Meta lancia Muse Ember, il suo modello di AI di piccole dimensioni ed Economico per le attività quotidiane degli agenti
Il nuovo modello di AI economico di Meta punta a eseguire compiti di routine come chiamate a strumenti e programmazione più rapidamente dei rivali, spendendo meno.
Come funziona
Un programma AI low-cost che si occupa di compiti di routine, come effettuare chiamate agli strumenti, scrivere pezzi di codice ed estrarre dati da un documento.
Cosa potresti farci
- Uno sviluppatore potrebbe costruire agenti di AI che fanno chiamate di strumenti, instradano richieste ed eseguono sottoattività di programmazione per tutto il giorno, spendendo una frazione del costo dei modelli precedenti 1.
- Un'azienda potrebbe attivare un sistema automatizzato che legge ed estrae informazioni da documenti lunghi o PDF senza pagare prezzi premium per ogni compito 2.
- Un ricercatore che confronta le frontiere di efficienza potrebbe eseguire Muse Ember accanto ai rivali su suite di benchmark come la classifica di Artificial Analysis per misurare l'intelligenza per dollaro speso 1.
Un modello piccolo per le commissioni degli agenti
Meta ha definito Muse Ember il suo ingresso "più piccolo ed efficiente", pensato soprattutto per quel tipo di lavoro ripetitivo che gli agenti di AI gestiscono tutto il giorno: fare chiamate di strumenti, eseguire sottoattività di programmazione, instradare richieste, estrarre informazioni da documenti e analizzare file grandi 2.
L'azienda dice che il modello si posiziona esattamente sulla linea che chiama frontiera dell'efficienza, ovvero nessun modello ottiene un punteggio più alto spendendo meno per compito nella classifica di Artificial Analysis 2. Meta sostiene anche che eguaglia il punteggio migliore di Claude Haiku 5.5 spendendo circa un terzo del prezzo e batte tutte le configurazioni di GPT-6 Luna .
Artificial Analysis ha pubblicato dati grafici che mostrano la posizione di Muse Ember rispetto a questi due rivali a diversi livelli di ragionamento 1.
Indovina
Quanto costa Muse Ember per milione di token in input?
Il prezzo standard è $0,10 per milione di token in input, uguale a GPT-6 Luna e Claude Haiku 5.5.
Quanto costa
Per prompt brevi, il tariffario standard è di $0,10 per ogni milione di token in ingresso e $0,50 per ogni milione di token in uscita — uguale al costo indicato di GPT-6 Luna e Claude Haiku 5.5 1. Questo lo colloca ben al di sotto di modelli più cari come il recentemente annunciato Claude Fable 5.2, che costa circa 80 volte tanto, a $8 per milione di token in ingresso e $40 per milione di token in uscita .
La situazione si fa più complessa quando i prompt superano certi limiti di lunghezza. Tutti e tre i modelli economici supportano fino a un milione di token in ingresso, ma ognuno alza il prezzo oltre una certa soglia 1:
- GPT-6 Luna raddoppia a $0,20 / $0,02 / $0,75 oltre 272k token
- Muse Ember balza a $0,30 / $0,012 / $1,50 oltre 200k token
- Claude Haiku 5.5 sale a $0,50 / $0,05 / $2,50 oltre 100k token 1
Ma confrontare il semplice prezzo per token perde un aspetto importante: oggi i modelli usano numeri di token molto diversi per risolvere lo stesso problema a causa dei "token di ragionamento", che sono calcoli interni aggiuntivi che un modello genera prima di dare una risposta 1. È per questo che Artificial Analysis misura l'intelligenza per dollaro speso .
Punteggi nei test comuni
Nei risultati dei benchmark di Artificial Analysis riportati da Meta, Muse Ember ha guidato diverse categorie al massimo dello sforzo di ragionamento: Agents AutomationBench-AA (37,8 contro 13,9 per Haiku e 20,2 per Luna), Agents' Last Exam (61,6 vs. 57,0 vs. 57,1), Personal Superintelligence Index (46,8 vs. 36,1 vs. 37,0), Coding Terminal-Bench 4.0 (40,9 vs. 39,2 vs. 16,4), Coding Agent Index-AA (46 vs. 37 vs. 31), FrontierCode 2.0-AA (34,9 vs. 27,2 vs. 25,2) e Multimodal GDP.pdf-AA (pareggiato a 22,8 con Luna, davanti al 20,8 di Haiku) 2.
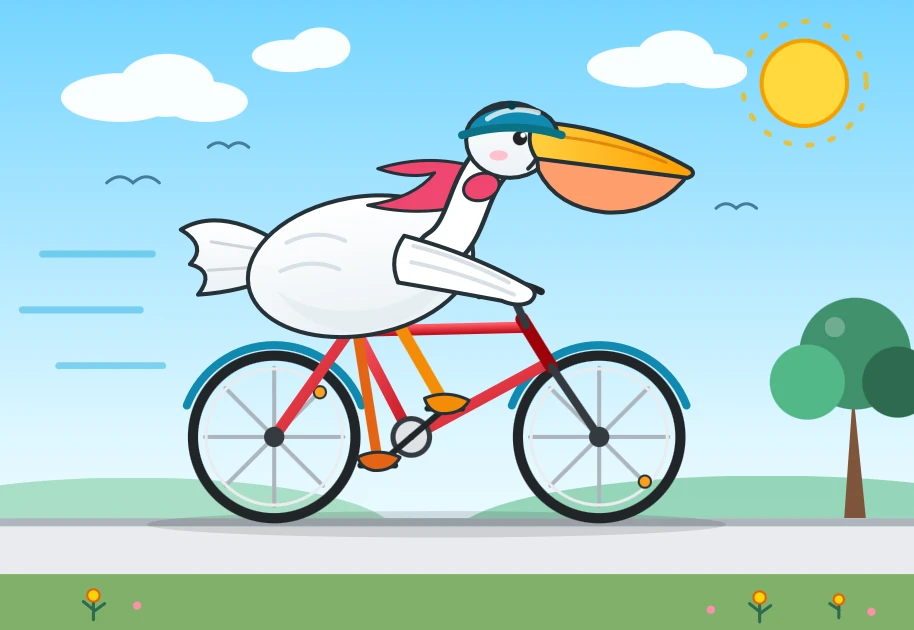
Simon Willison ha testato il modello personalmente e ha generato sei serie di immagini di pellicani che pedalano su biciclette usando i diversi livelli di ragionamento di Ember — minimal, low, medium, high, xhigh e max 1. Il livello high non è riuscito a restituire un file immagine completo, e ha notato che la qualità visiva non seguiva chiaramente la forza del ragionamento . Ha confrontato il risultato con le immagini di Muse Wonder, un modello circa 40 volte più costoso, e ha trovato la qualità comparabile .
Muse Ember è disponibile ora sulle piattaforme di Meta AI.
score representing ability on each test, higher is better. Più alto è meglio. Numeri: Artificial Analysis via Meta. Grafico di Herald of AI.
Fonti
- Introducing Our Smallest, Most Efficient Model: Muse Ember — simonwillison.net
- Introducing Our Smallest, Most Efficient Model: Muse Ember — research.meta.ai
Continua a leggere
 Nuovi modelliMeta lancia Muse Ember, un modello di AI economico costruito per compiti ripetitivi degli agentiHerald of AINuovi modelli
Meta lancia Muse Ember, un modello di AI economico costruito per compiti ripetitivi degli agenti
Un nuovo piccolo modello di AI da Meta che esegue attività di codifica e passaggi di flusso di lavoro rutinari per circa un terzo del prezzo della concorrenza.
Notizie collegate
 Come funzionaUber, DoorDash e Airbnb dicono che quasi nessuno usa ancora gli agenti di AIHerald of AI
Uber, DoorDash e Airbnb dicono che quasi nessuno usa ancora gli agenti di AI
Le app più popolari raccontano che gli assistenti personali di AI hanno effettuato solo qualche centinaio di ordini tra milioni di transazioni, a dimostrazione che l'hype sugli assistenti di AI ha ancora tanta strada da fare prima di raggiungere gli utenti comuni.
 Fatto con l’AIMeta lancia Style Sketch, un'app con AI per provare virtualmente i vestiti dal proprio guardarobaHerald of AI
Meta lancia Style Sketch, un'app con AI per provare virtualmente i vestiti dal proprio guardaroba
Meta ha rilasciato discretamente un'app di moda con AI che costruisce un guardaroba digitale dalle tue foto e suggerisce outfit — ma per ora è disponibile solo in tre paesi asiatici.
 La settimanaQuesta settimana in AI: nuovi modelli a profusione e agenti più sicuriHerald of AI
Questa settimana in AI: nuovi modelli a profusione e agenti più sicuri
Rilasci importanti di pesi aperti, risultati sulla velocità e un impegno a rendere gli agenti di intelligenza artificiale più affidabili e protetti.
 Come funzionaGoogle lancia TorchTPU, un backend nativo per PyTorch su TPU nel cloudHerald of AIhttps://github.com/soumith, CC BY-SA 4.0, via Wikimedia Commons
Google lancia TorchTPU, un backend nativo per PyTorch su TPU nel cloud
Un nuovo stack open-source permette agli sviluppatori di far girare modelli PyTorch direttamente sui chip TPU di Google, sostituendo il vecchio sistema PyTorch/XLA.