Google lancia TorchTPU, un backend nativo per PyTorch su TPU nel cloud
Un nuovo stack open-source permette agli sviluppatori di far girare modelli PyTorch direttamente sui chip TPU di Google, sostituendo il vecchio sistema PyTorch/XLA.
Google ha rilasciato TorchTPU come open-source, offrendo agli sviluppatori un modo nativo per far girare modelli PyTorch su chip Cloud TPU (tensor processing unit). Il progetto è nato in collaborazione con il team PyTorch di Meta ed è stato presentato alla PyTorch Conference 2026 il 20 ottobre 2026 1.
Il codice PyTorch esistente puntava già ai TPU usando un comando standard come torch.device("tpu"), ma TorchTPU rende ora i TPU un cittadino di prima classe alongside GPU e CPU dentro PyTorch stesso 1. Google consiglia di usarlo per tutti i nuovi workload e afferma che sostituisce il vecchio sistema PyTorch/XLA .
Cosa ci si può fare
- Un ricercatore potrebbe allenare un modello linguistico di grandi dimensioni sui chip TPU di Google usando codice PyTorch standard, abbandonando il vecchio e più lento sistema PyTorch/XLA 1.
- Una startup AI potrebbe ottimizzare un modello e ridurre il tempo per passaggio da circa 11,5 secondi a 2,8 secondi attivando torch.compile con il backend TPU 1.
- Uno sviluppatore potrebbe distribuire modelli Hugging Face Transformer o Diffusers su TPU usando gli stessi comandi di mappatura del dispositivo che usa già per le GPU 1.
Come funziona
TorchTPU si collega tramite l'interfaccia PrivateUse1 di PyTorch, un punto di estensione per backend hardware personalizzati. Il risultato è che i tensori restano normali tensori PyTorch — nessun sottoclasse speciale o oggetto wrapper 1. Esegue anche un processo per dispositivo e mantiene corretti i tensori view e le modifiche in-place .
Il vecchio sistema PyTorch/XLA registrava quelli che gli sviluppatori chiamavano grafi di calcolo "lazy", che spesso richiedevano codice aggiuntivo per marcare le regioni compilabili. TorchTPU offre tre modalità di esecuzione eager: una modalità Strict predefinita per l'uso normale, una modalità Debug con controllo dei limiti, e una modalità DeferAndFuse che raggruppa gli operatori per ridurre il traffico di memoria e può essere oltre il 50 per cento più veloce di Strict 1. Per la massima velocità, gli sviluppatori possono usare torch.compile con il backend TPU, che compila il codice attraverso StableHLO verso OpenXLA e memorizza i risultati tra un avvio e l'altro .
Prestazioni e scala
Tutte le cifre sulle prestazioni provengono da test auto-riferiti da Google e partner 1. Nei test di allenamento, il framework TorchTitan di Google ha raggiunto il 52 per cento di MFU (machine flops utilization) allenando il modello linguistico Qwen 3 8B su chip Ironwood (TPU7x), con uno scaling quasi lineare fino a 8.192 chip . In un esempio di fine-tuning, il tempo per passaggio è sceso da 11,49 secondi nella modalità eager predefinita a 2,78 secondi dopo la messa a punto completa, con torch.compile che ha offerto un boost di velocità 3,80x rispetto al baseline .
Google dice inoltre di testare continuamente circa 5.000 modelli Hugging Face sia in modalità eager che compilata 1. Un partner chiamato Zenteiq ha riferito di aver fatto crescere l'output giornaliero di token da 1,47 miliardi a 5,97 miliardi per 1.000 chip TPU v6e usando llm-d routing su Google Kubernetes Engine .
Integrazioni nell'ecosistema
Il rilascio include diversi progetti companion. Hugging Face Transformers v5 e Diffusers supportano ora la distribuzione su TPU tramite device mapping standard 1. Due framework di inference — vLLM-TorchTPU e SGLang-TorchTPU — mantengono le loro funzionalità esistenti di scheduling e attention aggiungendo kernel personalizzati per TPU . Il serving supporta formati checkpoint FP8, MXFP4 e NVFP4, insieme al speculative decoding . TorchTitan include recipe di allenamento per modelli come Llama 3 70B, Qwen 3 8B, Qwen 3 235B MoE e FLUX.1 12B .
L'intero stack TorchTPU è open-source sotto licenza Apache 2.0, con la versione 0.2.0 disponibile su PyPI per Python 3.11 e versioni successive 1.
I fatti principali
- TorchTPU è open-source sotto Apache 2.0, versione 0.2.0, co-sviluppato da Google e Meta
- Sostituisce PyTorch/XLA come backend raccomandato da Google per nuovi workload TPU
- Sono disponibili tre modalità eager: Strict, Debug e DeferAndFuse
- TorchTitan ha raggiunto il 52% MFU allenando Qwen 3 8B su fino a 8.192 TPU Ironwood
- Le integrazioni includono Hugging Face, vLLM-TorchTPU, SGLang-TorchTPU e TorchTitan
Fonti
- Google Open-Sources TorchTPU, a Native PyTorch Backend for Cloud TPUs — marktechpost.com
Notizie collegate
 Come funzionaUn nuovo motore permette ai modelli AI piccoli di rispondere in meno di 50 millisecondiHerald of AI
Un nuovo motore permette ai modelli AI piccoli di rispondere in meno di 50 millisecondi
Liquid AI afferma che il suo strumento permette all'AI generativa di sostituire vecchi modelli per i controlli antifrode, i pagamenti e la ricerca — senza rallentare le operazioni.
 Come funzionaDeepSeek rende open-source DeepInfer, il suo motore di inferenza ad alte prestazioniHerald of AI
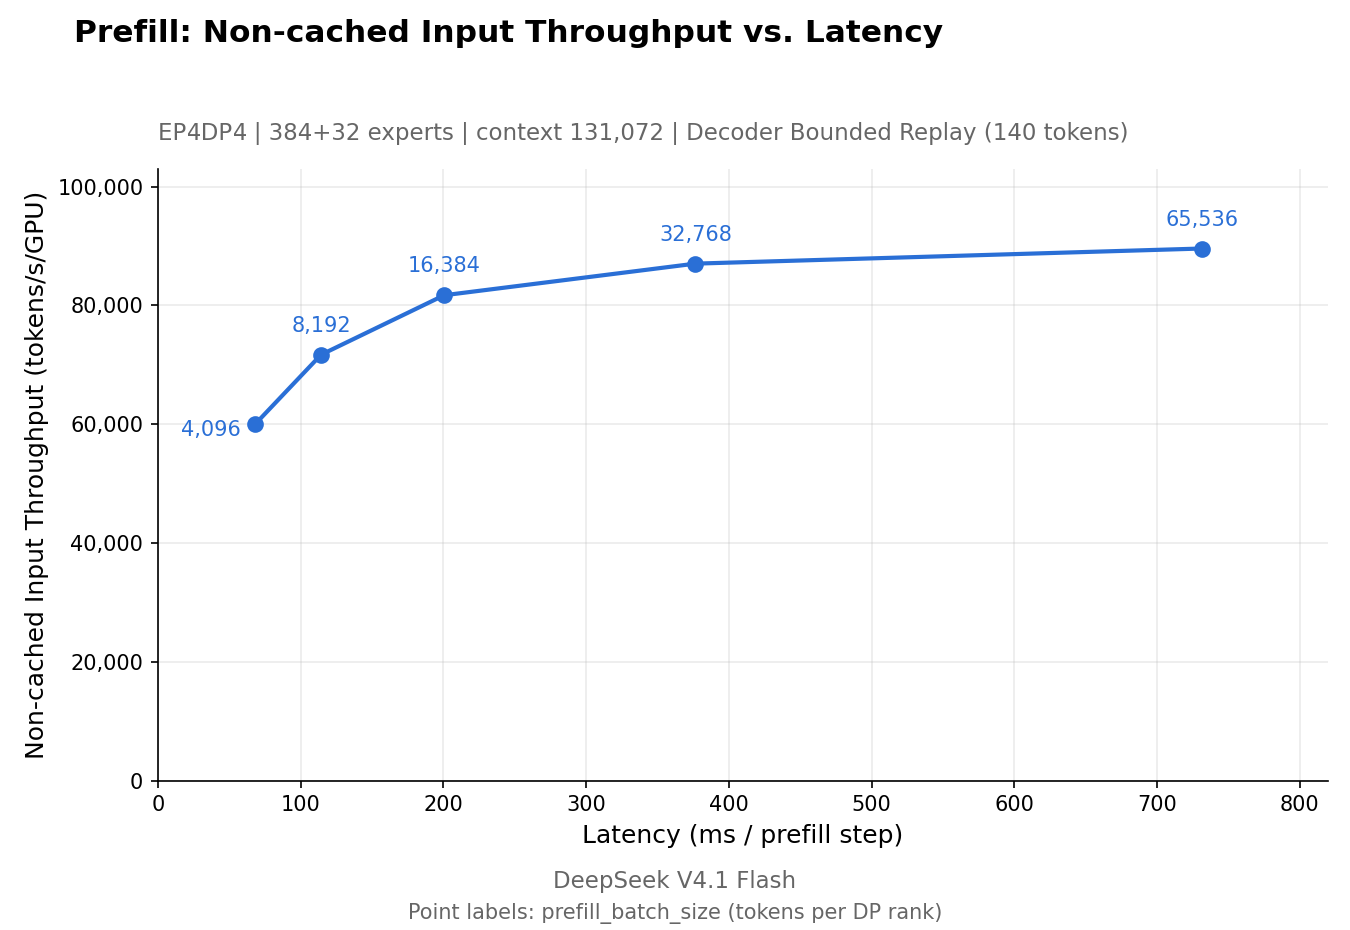
DeepSeek rende open-source DeepInfer, il suo motore di inferenza ad alte prestazioni
Il laboratorio di intelligenza artificiale cinese ha rilasciato il framework alla base dei suoi servizi di produzione sotto licenza Apache 2.0, mettendone a disposizione dei developer le ottimizzazioni per il servizio su larga scala.
 Nuovi modellivLLM Hyper-Optimizza Kimi K3 su NVIDIA GB300 per Inferenza RapidissimaHerald of AI
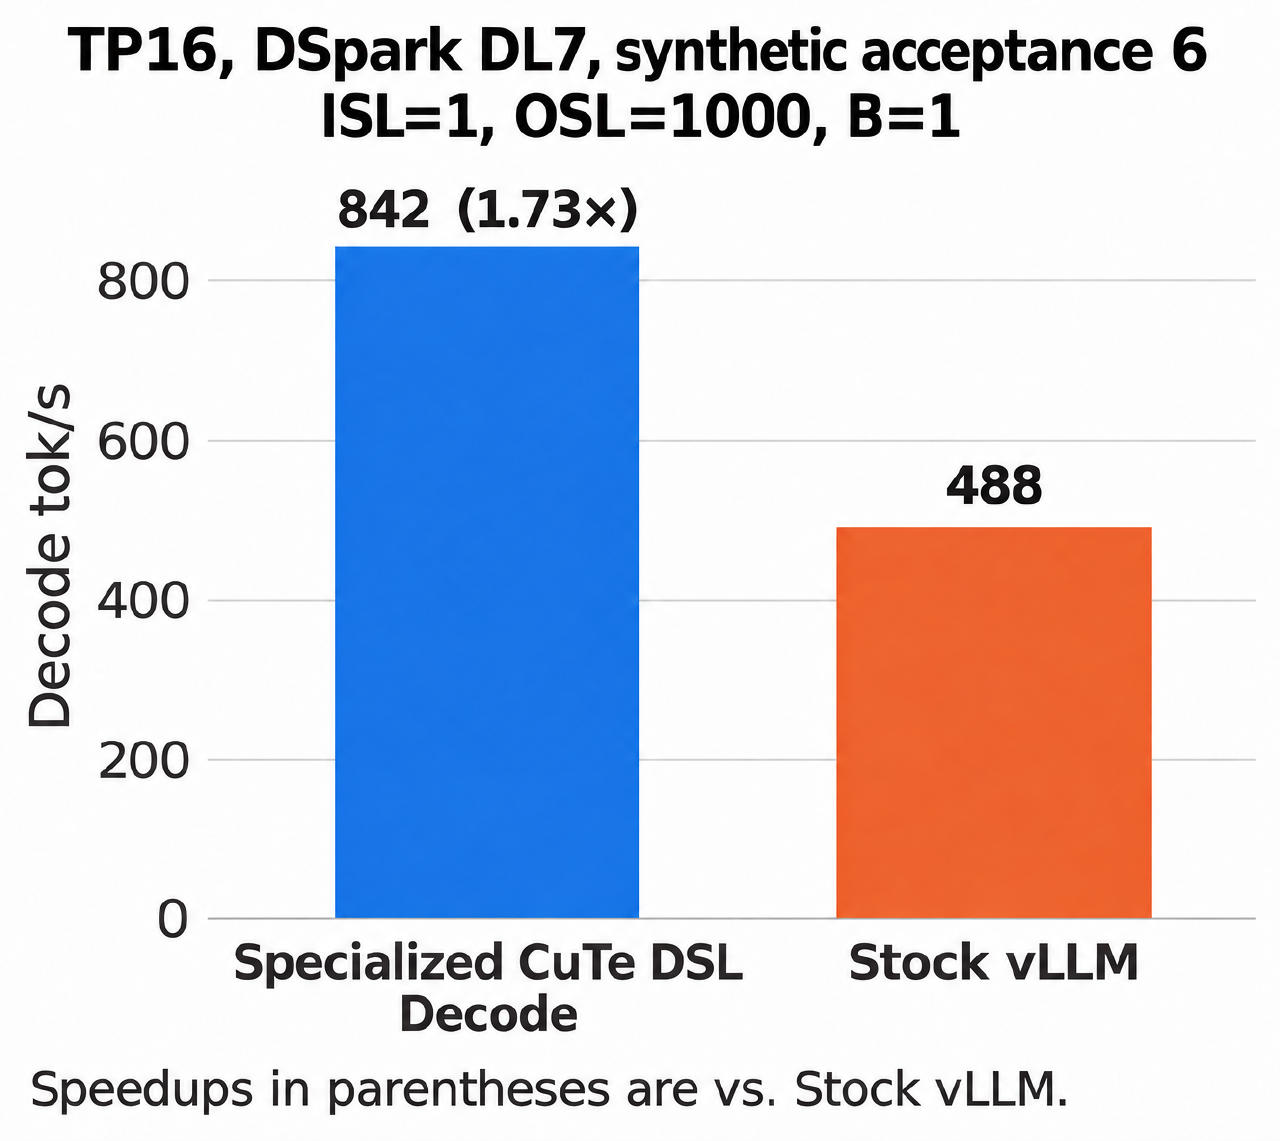
vLLM Hyper-Optimizza Kimi K3 su NVIDIA GB300 per Inferenza Rapidissima
Nuove ottimizzazioni spingono il decoding di Kimi K3 oltre 840 token al secondo con batch 1 su 16 GPU NVIDIA GB300 con DSpark.
 Come funzionaCome la nuova libreria di NVIDIA fa previsioni senza tabelle di addestramentoHerald of AI
Come la nuova libreria di NVIDIA fa previsioni senza tabelle di addestramento
Structured Data Models di NVIDIA permette di ottenere previsioni accurate dai fogli di calcolo semplicemente fornendo esempi all'AI.