Meta lanza Muse Ember, su modelo de IA pequeño y económico para tareas cotidianas de agentes
El nuevo modelo de IA de bajo costo de Meta apunta a realizar tareas habituales como llamadas a herramientas y programación más rápido que la competencia por menos dinero.
Cómo funciona
Un programa de IA de bajo coste que se encarga de tareas rutinarias como realizar llamadas a herramientas, escribir fragmentos de código y extraer datos de documentos.
Qué podrías hacer con él
- Un desarrollador podría construir agentes de IA que realicen llamadas a herramientas, enruten solicitudes y ejecuten subtareas de programación todo el día por una fracción del costo de los modelos anteriores 1.
- Una empresa podría configurar un sistema automatizado que lea y extraiga información de documentos largos o PDF sin pagar precios premium por tarea 2.
- Un investigador que compare frentes de eficiencia podría ejecutar Muse Ember junto a rivales en conjuntos de pruebas como el ranking de Artificial Analysis para medir inteligencia por dólar gastado 1.
Un modelo pequeño para tareas de agentes
Meta describió a Muse Ember como su entrada «más pequeña y eficiente» dirigida específicamente al tipo de trabajo repetitivo que los agentes de IA manejan todo el día: hacer llamadas a herramientas, ejecutar subtareas de programación, enrutar solicitudes, extraer información de documentos y analizar archivos grandes 2.
La compañía dice que el modelo se posiciona justo en lo que denomina frontera de eficiencia, lo que significa que ningún modelo obtiene una puntuación más alta por menos por tarea en el ranking de Artificial Analysis 2. Meta también afirma que iguala la mejor puntuación de Claude Haiku 5.5 a aproximadamente un tercio del precio y supera todas las configuraciones de GPT-6 Luna .
Artificial Analysis publicó datos de gráficos que muestran la posición de Muse Ember frente a esos dos rivales en diferentes niveles de razonamiento 1.
Adivina
¿Cuánto cobra Muse Ember por cada millón de tokens de entrada?
El precio estándar es de 0,10 dólares por millón de tokens de entrada, igual que GPT-6 Luna y Claude Haiku 5.5.
Cuánto cuesta
Para prompts breves, el precio estándar asciende a $0,10 por cada millón de tokens de entrada y $0,50 por cada millón de tokens de salida, lo que coincide con el coste indicado de GPT-6 Luna y Claude Haiku 5,5 1. Eso lo sitúa muy por debajo de modelos más caros como el recientemente anunciado Claude Fable 5.2, que cuesta unas 80 veces más, a $8 por millón de tokens de entrada y $40 por millón de tokens de salida .
Las cosas se vuelven más complejas cuando los prompts superan ciertos límites de longitud. Los tres modelos económicos admiten hasta un millón de tokens de entrada, pero cada uno incrementa su precio tras un umbral 1:
- GPT-6 Luna se duplica a $0,20 / $0,02 / $0,75 más allá de 272k tokens
- Muse Ember sube a $0,30 / $0,012 / $1,50 más allá de 200k tokens
- Claude Haiku 5.5 aumenta a $0,50 / $0,05 / $2,50 más allá de 100k tokens 1
Pero comparar el precio en crudo por token pierde algo importante: hoy en día los modelos usan cantidades muy distintas de tokens para resolver el mismo problema debido a los «tokens de razonamiento», que son cálculos internos adicionales que un modelo genera antes de dar una respuesta 1. Por eso Artificial Analysis mide la inteligencia por dólar gastado en su lugar .
Puntuaciones en pruebas comunes
Según los resultados de benchmarks de Artificial Analysis reportados por Meta, Muse Ember lideró varias categorías con esfuerzo máximo de razonamiento: Agents AutomationBench-AA (37,8 frente a 13,9 para Haiku y 20,2 para Luna), Agents' Last Exam (61,6 vs. 57,0 vs. 57,1), Personal Superintelligence Index (46,8 vs. 36,1 vs. 37,0), Coding Terminal-Bench 4.0 (40,9 vs. 39,2 vs. 16,4), Coding Agent Index-AA (46 vs. 37 vs. 31), FrontierCode 2.0-AA (34,9 vs. 27,2 vs. 25,2) y Multimodal GDP.pdf-AA (empatado a 22,8 con Luna, por delante del 20,8 de Haiku) 2.
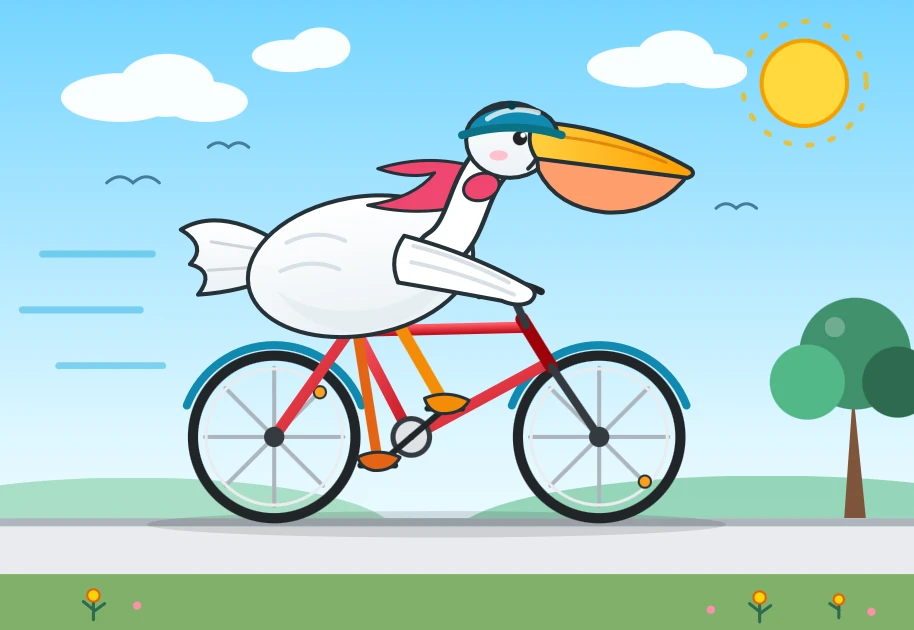
Simon Willison probó el modelo él mismo y generó seis conjuntos de imágenes de pelícanos montando bicicletas usando los distintos niveles de razonamiento de Ember —mínimo, bajo, medio, alto, muy alto y máximo— 1. El nivel alto falló al devolver un archivo de imagen completo, y señaló que la calidad visual no seguía claramente la fuerza de razonamiento . Comparó el resultado con imágenes de Muse Wonder, un modelo unas 40 veces más caro, y encontró una calidad comparable .
Muse Ember está disponible ahora a través de las plataformas de Meta AI.
score representing ability on each test, higher is better. Más alto es mejor. Datos: Artificial Analysis via Meta. Gráfico de Herald of AI.
Fuentes
- Introducing Our Smallest, Most Efficient Model: Muse Ember — simonwillison.net
- Introducing Our Smallest, Most Efficient Model: Muse Ember — research.meta.ai
Sigue leyendo
 Nuevos modelosMeta lanza Muse Ember, un modelo de IA económico diseñado para tareas repetitivas de agentesHerald of AINuevos modelos
Meta lanza Muse Ember, un modelo de IA económico diseñado para tareas repetitivas de agentes
Un nuevo modelo pequeño de IA de Meta que realiza programación rutinaria y pasos de flujo de trabajo por casi un tercio del precio de la competencia.
 Cómo funcionaUn nuevo plugin permite usar los modelos de IA Muse Wonder de MetaHerald of AI
 PersonasEl Muse Wonder de Meta nos devuelve a la frontera de la IAHerald of AI
 Cómo funcionaLas gafas Meta AI pueden calentarse demasiado cuando están mojadas: la empresa ofrece soluciones gratuitasHerald of AI
Noticias relacionadas
 Hecho con IAMeta lanza Style Sketch, una app de IA para probarte virtualmente la ropa de tu propio armarioHerald of AI
Meta lanza Style Sketch, una app de IA para probarte virtualmente la ropa de tu propio armario
Meta ha lanzado discretamente una app de moda con IA que construye un armario digital a partir de tus fotos y sugiere combinaciones de outfits — pero por ahora solo está disponible en tres países asiáticos.
 La semanaEsta semana en IA: llegan nuevos modelos y los agentes se vuelven más segurosHerald of AI
Esta semana en IA: llegan nuevos modelos y los agentes se vuelven más seguros
Grandes lanzamientos de modelos de pesos abiertos, avances de velocidad y un impulso para que los agentes de IA sean más fiables y seguros.
 Cómo funcionaGoogle abre TorchTPU, un backend nativo de PyTorch para TPUs en la nubeHerald of AIhttps://github.com/soumith, CC BY-SA 4.0, via Wikimedia Commons
Google abre TorchTPU, un backend nativo de PyTorch para TPUs en la nube
Una nueva pila de código abierto permite a los desarrolladores ejecutar modelos de PyTorch directamente en los chips TPU de Google, reemplazando el antiguo sistema PyTorch/XLA.
 La semanaEsta semana en herramientas de IA agéntica, modelos más baratos y dolores de crecimientoHerald of AI
Esta semana en herramientas de IA agéntica, modelos más baratos y dolores de crecimiento
OpenAI informa sobre la adopción de herramientas agénticas en la UE, nuevos modelos alcanzan salidas de un millón de tokens, y los desarrolladores luchan con código más rápido pero opaco.