Samaya Sterling, un agente de finanzas con IA diminuto, supera a uno mayor por una fracción del costo
Un modelo pequeño post-entrenado hace investigación financiera mejor que un modelo frontier grande, por 11 veces menos dinero.
Cómo funciona
Un programa que planifica investigaciones financieras, llama a herramientas para recopilar datos y redacta informes automáticamente.
- Planificar la investigación y elegir qué herramientas llamar
- Llamar hasta 37 herramientas financieras para recopilar evidencia
- Resumir los hallazgos y escribir un informe de investigación completo
Qué podrías hacer con ello
- Un investigador financiero o analista de inversiones podría realizar investigación financiera de principio a fin —planificar estudios, usar 37 herramientas financieras, recopilar evidencias y redactar informes— mediante un pequeño agente de IA creado por Samaya AI 2.
- Un desarrollador o empresa podría desplegar un agente asequible de investigación financiera por aproximadamente 11 veces menos dinero que usar Claude Fable 5.1, abaratando el funcionamiento de las herramientas de investigación a escala 1.
- Un equipo de inversión podría mejorar el rendimiento del cribado y la investigación macro, pasando del 31,8 por ciento en las preguntas más difíciles al 45,2 por ciento tras el post-entrenamiento 1.
Un ejemploInventado para explicarlo
Maya revisa acciones desde su pequeño escritorio en el departamento
MayaEncontrá todo sobre el último informe de ingresos de NovaTech
SterlingBuscando en las 37 herramientas financieras. Las voy a llamar ahora.
Maya¿Cuánto tarda y cuánto cuesta?
SterlingPlanificar el estudio, llamar a las herramientas, recopilar evidencia y después escribir el informe. Mucho menos que los grandes competidores.
Sterling completó el flujo de trabajo completo de investigación y entregó un informe a una fracción del costo habitual.
Un modelo más pequeño haciendo el trabajo de uno mayor
Samaya AI ha publicado Sterling, un modelo diseñado para actuar como agente de investigación financiera. Se basa en Nemotron 3.5 Lightning, un modelo de NVIDIA que tiene 30 mil millones de parámetros totales pero solo usa 3 mil millones a la vez —un diseño llamado mixture of experts, donde diferentes partes del modelo se encargan de diferentes tareas 12.
En el benchmark FrontierFinance propio de Samaya, que evalúa la capacidad de la IA en flujos de trabajo reales de inversión, Sterling obtiene un 58,9 por ciento de precisión 1. Eso supera la puntuación de Claude Fable 5.1 de 55,9 por ciento . La principal diferencia, no obstante, es el coste. Cada pregunta de investigación cuesta 61 centavos para Sterling, frente a los 6,89 dólares para Fable 5.1 —aproximadamente 11 veces más barato 2.
El modelo en sí solo cuesta unos 4 centavos por pregunta; el resto cubre las herramientas y los modelos auxiliares que usa 1. Samaya afirma que cada etapa de entrenamiento añadió calidad, pasando del 42,5 por ciento de precisión en el modelo base al 58,9 por ciento tras cuatro etapas de entrenamiento . En el tercio más difícil de las preguntas, el rendimiento subió del 31,8 por ciento al 45,2 por ciento .
Cómo funciona Sterling
Un agente de investigación financiera es un programa que planifica la investigación, usa herramientas para obtener datos, recopila evidencias y luego redacta un informe 2. Sterling hace esto siendo primero entrenado con aprendizaje supervisado para llamar a 37 herramientas financieras distintas con entradas correctas, y luego aprendiendo de estrategias mejoradas .
Samaya adaptó su sistema de herramientas financieras de producción para un modelo pequeño. Simplificaron las instrucciones, fusionaron algunas herramientas para acortar los prompts, y añadieron dos modelos auxiliares para gestionar el contexto —un condensador que acorta los resultados largos de las herramientas, y un compactador que resume la trazabilidad de la investigación a medida que crece 2. Un presupuesto de investigación limita cuánto tiempo trabaja el agente antes de entregar los hallazgos a un escritor de informes separado .
El entrenamiento usó LoRA, un método que ajusta solo parte de los parámetros de un modelo para ahorrar tiempo y dinero, en cuatro etapas usando a Kimi K3 como modelo profesor 12. La primera etapa usó 968 preguntas sintéticas. La segunda usó 1.819 preguntas escritas por expertos con ocho estrategias de investigación distintas, manteniendo solo la mejor respuesta por pregunta . Dos etapas adicionales usaron aprendizaje por refuerzo, primero puntaje offline de respuestas existentes, y luego online donde el modelo respondió cada pregunta ocho veces y aprendió de intentos evaluados .
Qué sigue sin saberse
Samaya dice que ninguna pregunta del benchmark se usó en el entrenamiento, y que los checkpoints se eligieron sobre 100 preguntas internas de validación 1. Sin embargo, todos los resultados son autorreportados por Samaya en su propio benchmark . El modelo aún no tiene pesos públicos ni API anunciada; el modelo base corre en una sola GPU H100 con 80 GB de memoria y 256K de contexto, pero el hardware de servicio de Sterling y el contexto no se revelan . No se reportan cifras para otros benchmarks más allá de FrontierFinance.
La conclusión más amplia es que entrenar conjuntamente un modelo pequeño con su sistema de herramientas puede estrechar la brecha con modelos más grandes en dominios especializados 2.
Qué tan bueno es
En el benchmark FrontierFinance propio de Samaya, que evalúa la capacidad de la IA en flujos de trabajo reales de inversión usando 220 consultas públicas calificadas contra rúbricas escritas por expertos, Sterling obtiene un 58,9 por ciento de precisión 1. Eso supera la puntuación de Claude Fable 5.1 de 55,9 por ciento en la misma prueba . Cada etapa de entrenamiento añadió calidad, pasando del 42,5 por ciento en el modelo base al 58,9 por ciento tras cuatro etapas . Todos los resultados son autorreportados por Samaya AI .
accuracy on real investment research workflows. Más alto es mejor. Datos: Samaya AI (self-reported). Gráfico de Herald of AI.
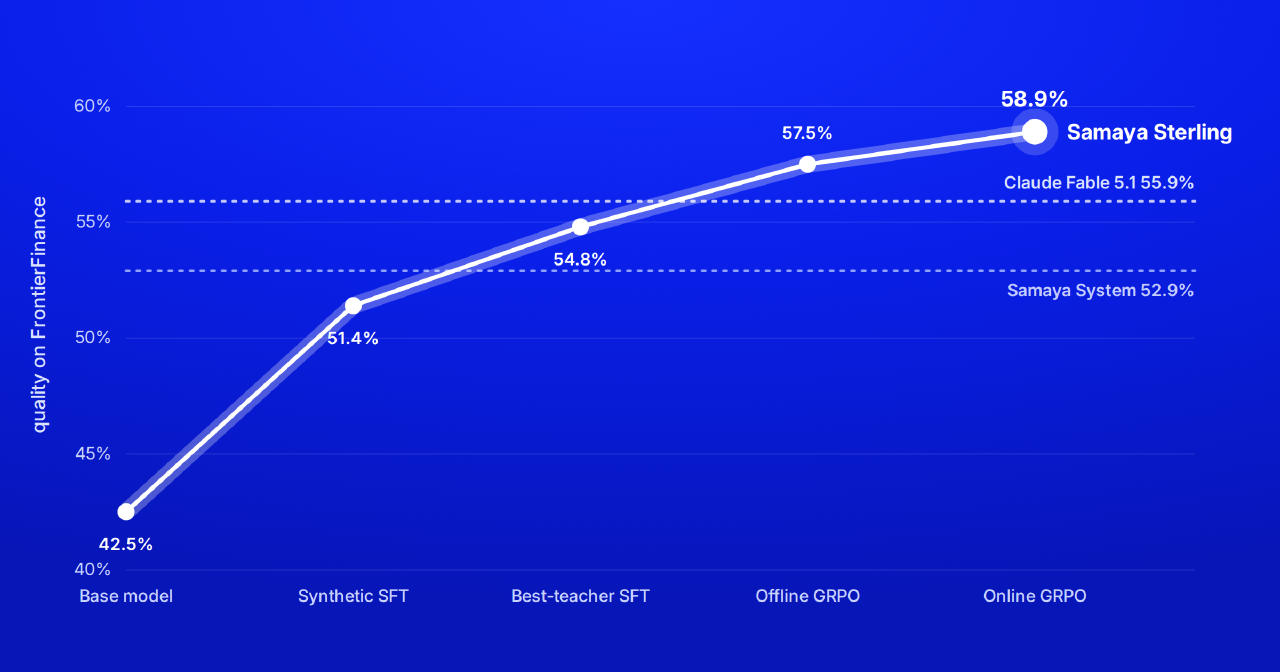
Imagen: samaya.ai
Imagen: samaya.ai
Imagen: samaya.ai
Los datos clave
- Sterling obtiene 58,9% en FrontierFinance, superando el 55,9% de Claude Fable 5.1
- El costo por pregunta baja 11 veces: 0,61 dólares frente a 6,89 dólares para Fable 5.1
- Construido sobre Nemotron 3.5 Lightning de NVIDIA con 30B totales / 3B activos de parámetros
- Entrenado en 4 etapas usando LoRA con Kimi K3 como modelo profesor
- Sin pesos públicos ni API anunciada; el modelo base cabe en una sola H100 de 80 GB
Fuentes
Sigue leyendo
 Nuevos modelosKimi K3.1 Pro, un modelo de IA chino que cualquiera podrá descargar, casi iguala a Claude Opus 5.5Herald of AINuevos modelos
Kimi K3.1 Pro, un modelo de IA chino que cualquiera podrá descargar, casi iguala a Claude Opus 5.5
El modelo de Moonshot AI con 2,8 billones de parámetros puntúa 55 en Artificial Analysis, tres puntos por debajo de Claude Opus 5.5, cuesta la mitad y sus pesos completos —los archivos que permiten ejecutarlo cualquiera— llegarán el 4 de noviembre.
 Nuevos modelosvLLM hiper-optimiza Kimi K3 en NVIDIA GB300 para inferencia ultrarrápidaHerald of AI
 Nuevos modelosKimi K4 no ha sido anunciado: esto es lo que realmente es ciertoHerald of AI
 Cómo funcionaReflection AI Lanza Beam, un modelo abierto de 501B diseñado para agentes de codificaciónHerald of AI
Noticias relacionadas
 Nuevos modelosMirendil lanza Fern 0.1, un modelo de IA que puede leer 10 millones de tokens a la vezHerald of AI
Mirendil lanza Fern 0.1, un modelo de IA que puede leer 10 millones de tokens a la vez
Una nueva IA para programar puede guardar un proyecto completo de software en memoria a la vez: útil para los desarrolladores, pero todavía muy por detrás de los mejores modelos a la hora de escribir código de verdad.
 Cómo funcionaUn nuevo motor hace que los modelos pequeños de IA respondan en menos de 50 milisegundosHerald of AI▶
Un nuevo motor hace que los modelos pequeños de IA respondan en menos de 50 milisegundos
Liquid AI dice que su herramienta permite que la IA generativa reemplace modelos antiguos para verificaciones de fraude, pagos y búsquedas, sin ralentizar los procesos.
 Nuevos modelosRecursive lanza Flint, un modelo de codificación local de 40B y pesos abiertos para agentesHerald of AI
Recursive lanza Flint, un modelo de codificación local de 40B y pesos abiertos para agentes
Flint es el primer modelo de Recursive Superintelligence: un agente de codificación rápido y local que funciona en hardware de consumo.
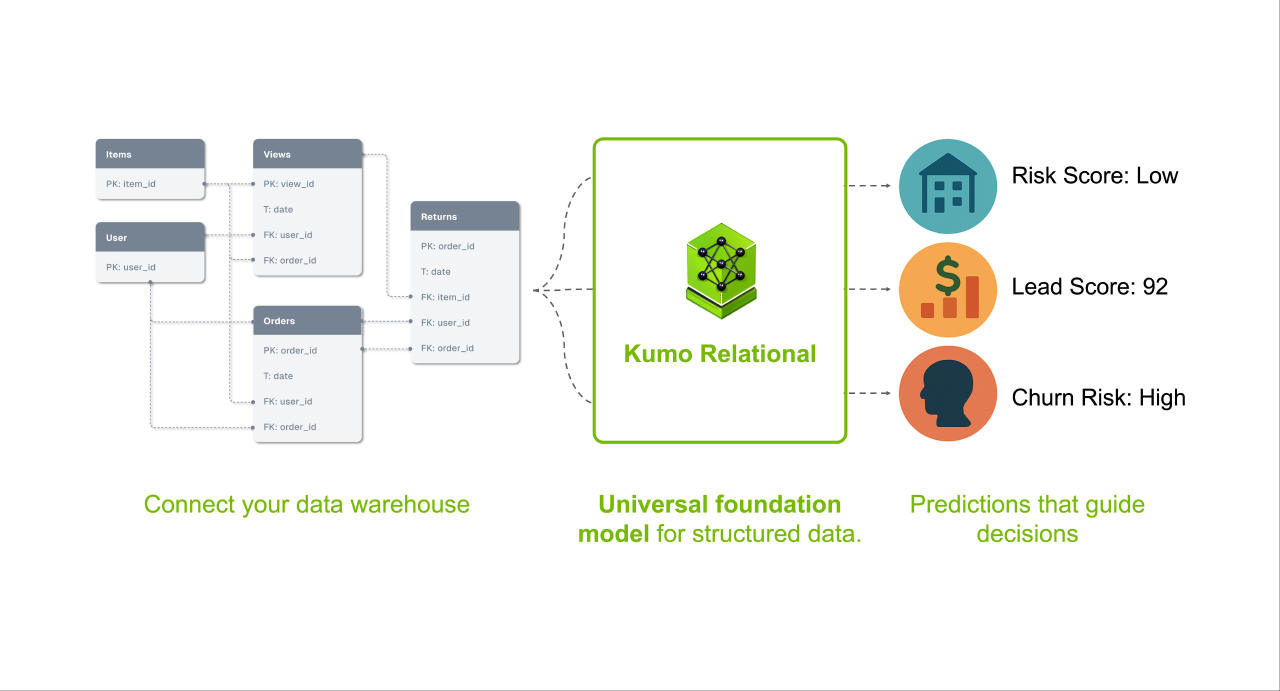 Nuevos modelosKumo Relational de NVIDIA supera al ML supervisado en datos relacionales sin entrenamientoHerald of AI
Kumo Relational de NVIDIA supera al ML supervisado en datos relacionales sin entrenamiento
Un nuevo modelo base preentrenado predice resultados directamente en bases de datos empresariales, sin necesidad de ingeniería de características ni entrenamiento específico para cada tarea.