vLLM hiper-optimiza Kimi K3 en NVIDIA GB300 para inferencia ultrarrápida
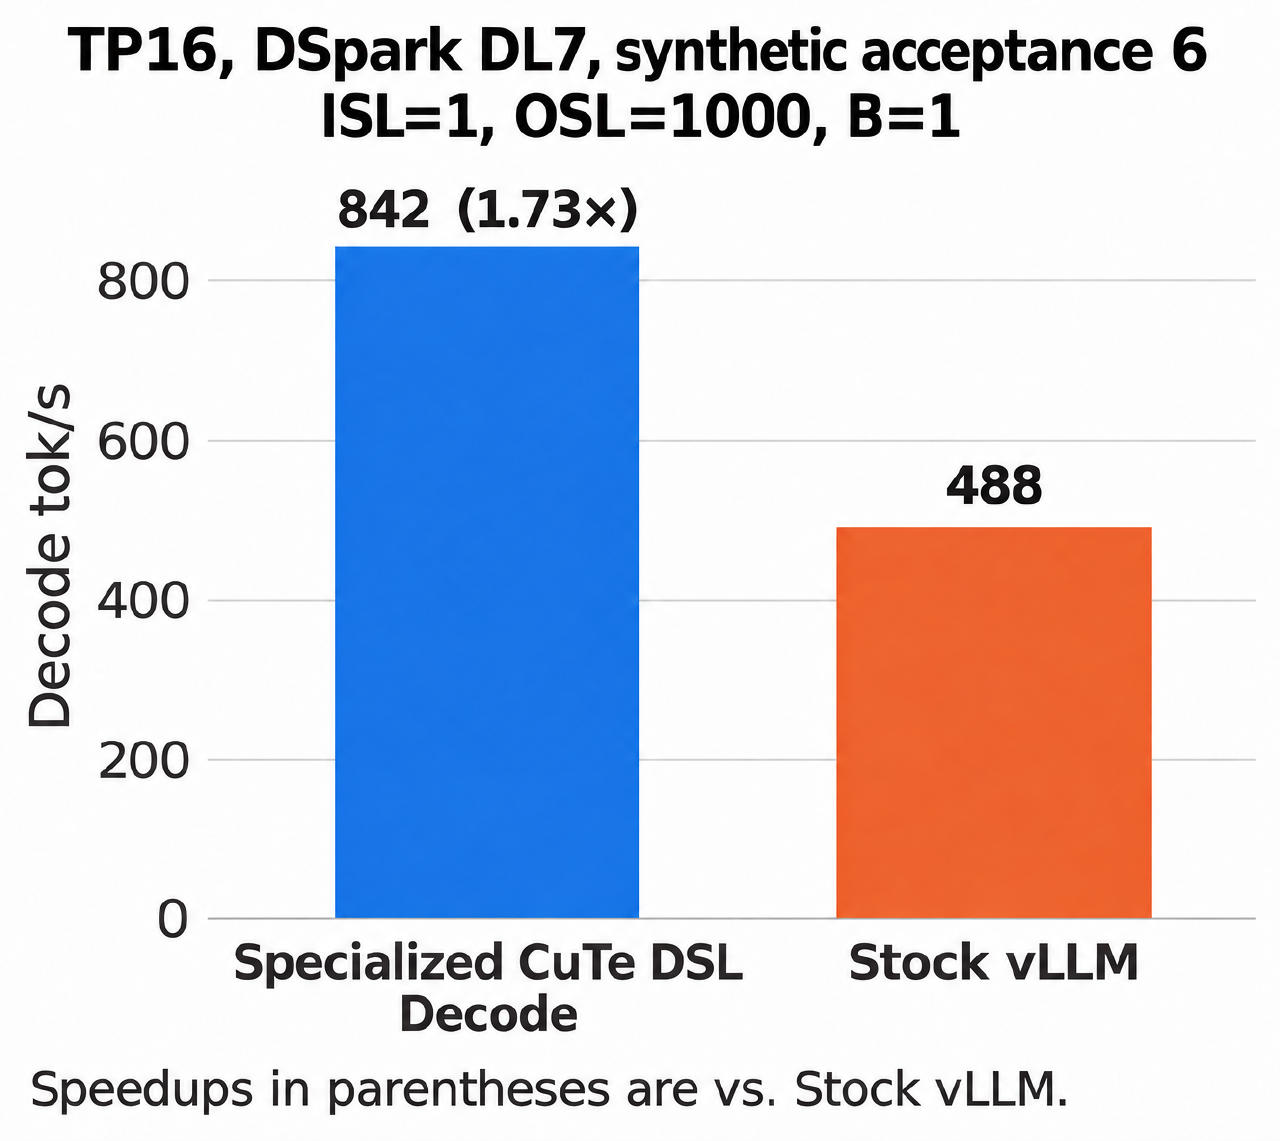
Las nuevas optimizaciones llevan el decodificado de Kimi K3 a más de 840 tokens por segundo con batch 1 en 16 GPUs NVIDIA GB300 con DSpark.
Qué se puede hacer con ello
- Una empresa de chatbots podría ofrecer a sus usuarios respuestas casi el doble de rápidas cuando hacen una pregunta a la vez 1.
- Un desarrollador que ejecute asistentes de IA basados en Kimi K3 podría reducir costes de infraestructura logrando más con las mismas máquinas de 16 GPUs 1.
- Un investigador que pruebe agentes de IA con contexto largo podría ver tiempos de respuesta hasta un 1,8× más rápidos en cargas de trabajo reales 1.
La velocidad lo es todo
La biblioteca de código abierto vLLM ha llevado el rendimiento de Kimi K3 a nuevas cotas construyendo un conjunto completamente personalizado de instrucciones para GPU, o kernels, optimizados para los chips NVIDIA Blackwell. Para modelos de IA que responden una palabra a la vez — un proceso llamado decoding—, cada microsegundo cuenta. El resultado: más de 840 tokens por segundo en una sola consulta usando 16 GPUs NVIDIA GB300 con DSpark (AL sintético=6), lo que representa un aumento del 1,5–2× en el rendimiento en varias configuraciones probadas.
El enfoque agente
vLLM también está cambiando la forma en que desarrolla estas optimizaciones. Por primera vez, agentes de IA ayudaron a escribir y ajustar las partes más complejas del código: kernels personalizados para GPU, fusión de múltiples operaciones en una sola, y coordinación de la comunicación entre muchas GPUs 1. El equipo dice que esto marca un cambio en cómo se organiza el trabajo de rendimiento: en lugar de que los humanos revisen cada línea, están construyendo sistemas que pueden verificar la corrección automáticamente. "Necesitamos cambiar la forma en que organizamos el trabajo de rendimiento", escribió el equipo en su publicación de octubre de 2026 .
Qué se ha optimizado
La ruta de decodificado optimizada reemplaza casi toda operación estándar con un kernel personalizado construido usando el framework CuTe DSL de NVIDIA. Las técnicas clave incluyen:
- Ajuste de forma: Diferentes tamaños de batch usan diferentes kernels, así que los recursos de la GPU se mantienen plenamente ocupados en cada carga de trabajo.
- Superposición de cálculo y comunicación: La salida de atención se fusiona directamente con su operación all-reduce y el cálculo de residual posterior, reduciendo el movimiento de datos entre GPUs.
- Mejora del enrutamiento de Mezcla de Expertos (MoE): Las puntuaciones del router y los cálculos de expertos se reparten entre GPUs, reduciendo trabajo redundante y permitiendo que el experto compartido se ejecute en paralelo en un stream separado.
- Precarga de pesos en caché: Mientras las GPUs manejan la comunicación, un kernel lateral precarga los pesos necesarios para la siguiente operación, evitando los cuellos de botella de memoria comunes en inferencias con batch pequeño.
La implementación estándar de vLLM para Kimi K3 usa 130 microsegundos y 23 kernels por capa. La versión optimizada reduce eso a 69 microsegundos y solo 13 kernels por capa 1.
Por qué importa
Un decodificado más rápido significa menores costes y mejor experiencia de usuario para cualquier servicio que ejecute Kimi K3. El equipo descubrió que el rendimiento de decodificado aumentó hasta un 1,5–2× en varias configuraciones probadas, y la interactividad P90 mejoró hasta un 1,8× en la carga de trabajo AgentX 1. vLLM planea aplicar el mismo enfoque de optimización agente a otros modelos y hardware en el futuro, esperando que la comunidad ayude a desarrollar las herramientas de verificación y validación necesarias para publicar código rápido pero seguro.
Qué tan buena es
La ruta de decodificado optimizada de vLLM funciona a más de 840 tokens por segundo con batch 1 en 16 GPUs NVIDIA GB300 con DSpark, lo que es un 1,5–2× más de rendimiento que la versión estándar de vLLM en varias configuraciones probadas 1. Cada capa ahora termina en solo 69 microsegundos usando solo 13 kernels personalizados, frente a los 130 microsegundos y 23 kernels de la implementación original . En la carga de trabajo agente AgentX, la interactividad P90 (el punto por debajo del cual cae el 90 % de las respuestas) mejoró hasta un 1,8× . Las pruebas las ejecutó y reportó el propio equipo de vLLM .
Imagen: vllm.ai
Correcciones y actualizaciones
- Corregido el 23 de octubre de 2026. Una versión anterior afirmaba que la optimización establecía un nuevo récord para la velocidad de inferencia de IA en general, y describía la línea base como funcionando a aproximadamente la mitad de la velocidad; la fuente especificaba la GPU exacta y las condiciones DSpark, e informaba un aumento del 1,5–2× en el rendimiento en lugar de una simple comparación de mitad de velocidad.
Los datos clave
- Más de 840 tokens/segundo con batch 1 en 16 GPUs NVIDIA GB300 con DSpark
- La cantidad de kernels por capa bajó de 23 a 13, y la latencia de 130 μs a 69 μs
- Hasta un 1,8× más de interactividad P90 en la carga de trabajo AgentX
- vLLM usó agentes de IA para ayudar a escribir y ajustar kernels personalizados para GPU
- Las optimizaciones están dirigidas a GPUs NVIDIA Blackwell con tamaños de batch de 1 a 64 y paralelismo de contexto opcional
Fuentes
Noticias relacionadas
 Nuevos modelosKimi K3.1 Pro, un modelo de IA chino que cualquiera podrá descargar, casi iguala a Claude Opus 5.5Herald of AI
Kimi K3.1 Pro, un modelo de IA chino que cualquiera podrá descargar, casi iguala a Claude Opus 5.5
El modelo de Moonshot AI con 2,8 billones de parámetros puntúa 55 en Artificial Analysis, tres puntos por debajo de Claude Opus 5.5, cuesta la mitad y sus pesos completos —los archivos que permiten ejecutarlo cualquiera— llegarán el 4 de noviembre.
 Cómo funcionaUn nuevo motor hace que los modelos pequeños de IA respondan en menos de 50 milisegundosHerald of AI
Un nuevo motor hace que los modelos pequeños de IA respondan en menos de 50 milisegundos
Liquid AI dice que su herramienta permite que la IA generativa reemplace modelos antiguos para verificaciones de fraude, pagos y búsquedas, sin ralentizar los procesos.
 Nuevos modelosRecursive Releases Flint, a 40B Open-Weight Local Coding Model for AgentsHerald of AI
Recursive Releases Flint, a 40B Open-Weight Local Coding Model for Agents
Flint is Recursive Superintelligence's first model: a fast local coding agent running on consumer hardware.
 Nuevos modelosKumo Relational de NVIDIA supera al ML supervisado en datos relacionales sin entrenamientoHerald of AI
Kumo Relational de NVIDIA supera al ML supervisado en datos relacionales sin entrenamiento
Un nuevo modelo base preentrenado predice resultados directamente en bases de datos empresariales, sin necesidad de ingeniería de características ni entrenamiento específico para cada tarea.