Samaya Sterling, un piccolo agente AI per la finanza batte un concorrente molto più grande a una frazione del costo
Un modello post-allenato fa ricerche finanziarie meglio di un grande modello di frontiera, spendendo 11 volte meno.
Come funziona
Un programma che pianifica ricerche finanziarie, chiama strumenti per raccogliere dati e scrive i report in automatico.
- Pianifica la ricerca e scegli quali strumenti usare
- Chiama fino a 37 strumenti finanziari per raccogliere prove
- Riassumi i risultati e scrivi un report di ricerca completo
Cosa si può fare con esso
- Un ricercatore finanziario o analista d'investimento potrebbe condurre ricerche finanziarie complete — pianificare studi, usare 37 strumenti finanziari, raccogliere prove e redigere report — utilizzando un piccolo agente AI creato da Samaya AI 2.
- Uno sviluppatore o un'azienda potrebbe distribuire un agente di ricerca finanziaria conveniente per circa 11 volte meno rispetto all'uso di Claude Fable 5.1, rendendo gli strumenti di ricerca più economici da gestire su larga scala 1.
- Un team di investimenti potrebbe migliorare le prestazioni di screening e ricerca macro, passando dal 31,8% sulle domande più difficili al 45,2% dopo il post-allenamento 1.
Un esempioInventato per spiegare
Maya analizza azioni dalla sua piccola scrivania in appartamento
MayaTrova tutto sull'ultimo report sui ricavi di NovaTech
SterlingSto cercando tra 37 strumenti finanziari. Li chiamo subito.
MayaQuanto ci mette e quanto costa?
SterlingPianifico lo studio, chiamo gli strumenti, raccolgo le prove e poi scrivo il report. Costa molto meno dei grandi concorrenti.
Sterling ha completato tutto il flusso di ricerca e consegnato un report a una frazione del solito prezzo.
Un modello più piccolo che svolge il lavoro di uno più grande
Samaya AI ha rilasciato Sterling, un modello progettato per agire come agente di ricerca finanziaria. È basato su Nemotron 3.5 Lightning, un modello di NVIDIA che ha 30 miliardi di parametri totali ma ne utilizza solo 3 miliardi alla volta — un design chiamato mixture of experts, in cui parti diverse del modello gestiscono compiti diversi 12.
Sul benchmark FrontierFinance di Samaya, che testa la capacità dell'AI in workflow d'investimento reali, Sterling ottiene il 58,9% di accuratezza 1. Questo batte il punteggio del 55,9% di Claude Fable 5.1 . La differenza principale, però, è il costo. Ogni domanda di ricerca costa 61 centesimi per Sterling, contro $6,89 per Fable 5.1 — circa 11 volte più economico 2.
Il modello stesso costa solo circa 4 centesimi per domanda; il resto copre gli strumenti e i modelli ausiliari che utilizza 1. Samaya afferma che ogni fase di allenamento ha aggiunto qualità, passando dal 42,5% di accuratezza sul modello di base al 58,9% dopo quattro fasi di allenamento . Sul terzo più difficile delle domande, le prestazioni sono aumentate dal 31,8% al 45,2% .
Come funziona Sterling
Un agente di ricerca finanziaria è un programma che pianifica la ricerca, chiama strumenti per ottenere dati, raccoglie prove e poi scrive un report 2. Sterling fa questo sendo prima allenato con apprendimento supervisionato a chiamare 37 diversi strumenti finanziari con input corretti, poi imparando da strategie migliorate .
Samaya ha adattato il suo sistema di strumenti finanziari di produzione per un modello piccolo. Hanno semplificato le istruzioni, unito alcuni strumenti per accorciare i prompt, e aggiunto due modelli ausiliari per gestire il contesto — un condensatore che accorcia i risultati lunghi degli strumenti, e un compattatore che riassume la traccia di ricerca man mano che cresce 2. Un budget di ricerca limita quanto a lungo l'agente lavora prima di passare i risultati a un writer di report separato .
L'allenamento ha usato LoRA, un metodo che regola solo parte dei parametri di un modello per risparmiare tempo e denaro, attraverso quattro fasi su Kimi K3 come modello teacher 12. La prima fase ha usato 968 domande sintetiche. La seconda ha usato 1.819 domande scritte da esperti con otto diverse strategie di ricerca, mantenendo solo la risposta migliore per ogni domanda . Due fasi ulteriori hanno usato apprendimento per rinforzo, prima offline valutando risposte esistenti, poi online dove il modello ha risposto a ciascuna domanda otto volte e ha imparato da tentativi valutati .
Cosa rimane ancora sconosciuto
Samaya afferma che nessuna domanda del benchmark è stata utilizzata durante l'allenamento, e i checkpoint sono stati selezionati su 100 domande interne di validazione 1. Tuttavia, tutti i risultati sono dichiarati direttamente da Samaya sul proprio benchmark . Il modello non ha ancora pesi pubblici né un'API annunciata; il modello di base gira su una singola GPU H100 con 80 GB di memoria a contesto 256K, ma l'hardware di serving e il contesto di Sterling non sono divulgati . Non vengono riportate cifre per altri benchmark oltre a FrontierFinance.
La lezione più ampia è che addestrare insieme un modello piccolo con il suo sistema di strumenti può ridurre il divario con modelli più grandi in domini specializzati 2.
Quanto è bravo
Sul benchmark FrontierFinance di Samaya, che testa la capacità dell'AI in workflow d'investimento reali utilizzando 220 query pubbliche valutate contro rubriche scritte da esperti, Sterling ottiene il 58,9% di accuratezza 1. Questo batte il punteggio del 55,9% di Claude Fable 5.1 sullo stesso test . Ogni fase di allenamento ha aggiunto qualità, passando dal 42,5% sul modello di base al 58,9% dopo quattro fasi . Tutti i risultati sono dichiarati direttamente da Samaya AI .
accuracy on real investment research workflows. Più alto è meglio. Numeri: Samaya AI (self-reported). Grafico di Herald of AI.
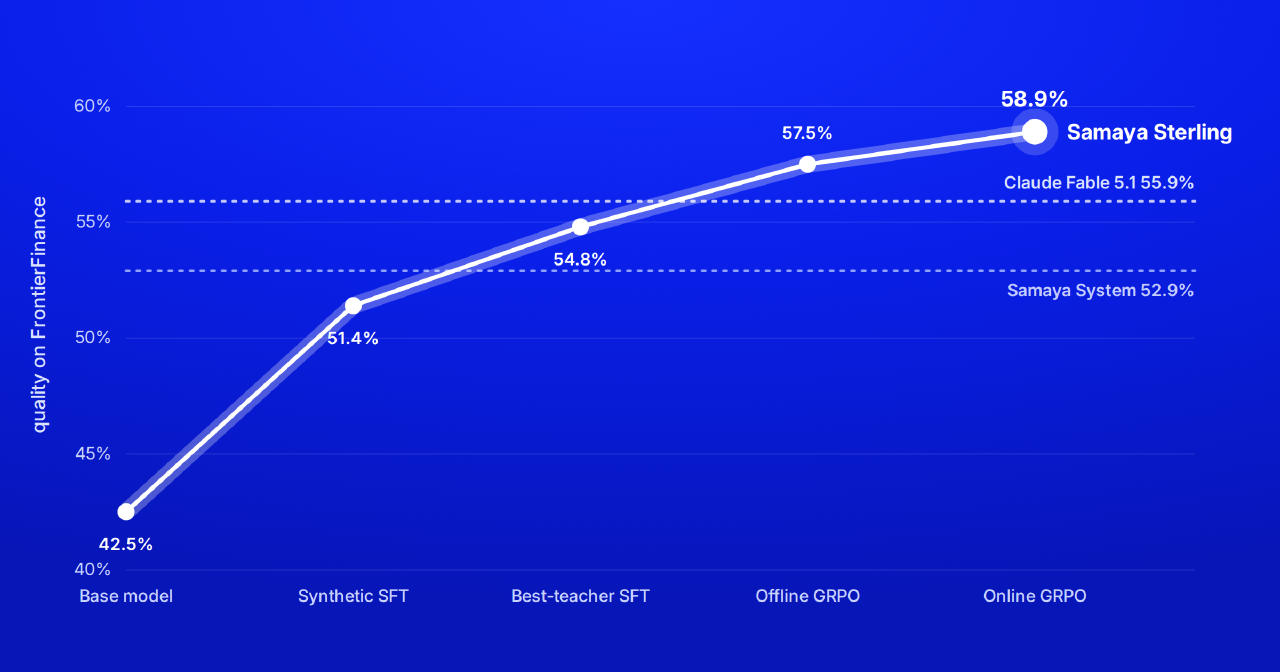
Immagine: samaya.ai
Immagine: samaya.ai
Immagine: samaya.ai
I fatti principali
- Sterling ottiene il 58,9% su FrontierFinance, battendo il 55,9% di Claude Fable 5.1
- Il costo per domanda si riduce di 11 volte: $0,61 contro $6,89 per Fable 5.1
- Basato su Nemotron 3.5 Lightning di NVIDIA con 30 miliardi di parametri totali / 3 miliardi attivi
- Allenato in 4 fasi usando LoRA con Kimi K3 come modello teacher
- Nessun peso pubblico o API annunciata; il modello di base gira su una singola H100 da 80 GB
Fonti
Continua a leggere
 Nuovi modelliKimi K3.1 Pro, un modello di intelligenza artificiale cinese scaricabile da chiunque, quasi eguaglia Claude Opus 5.5Herald of AINuovi modelli
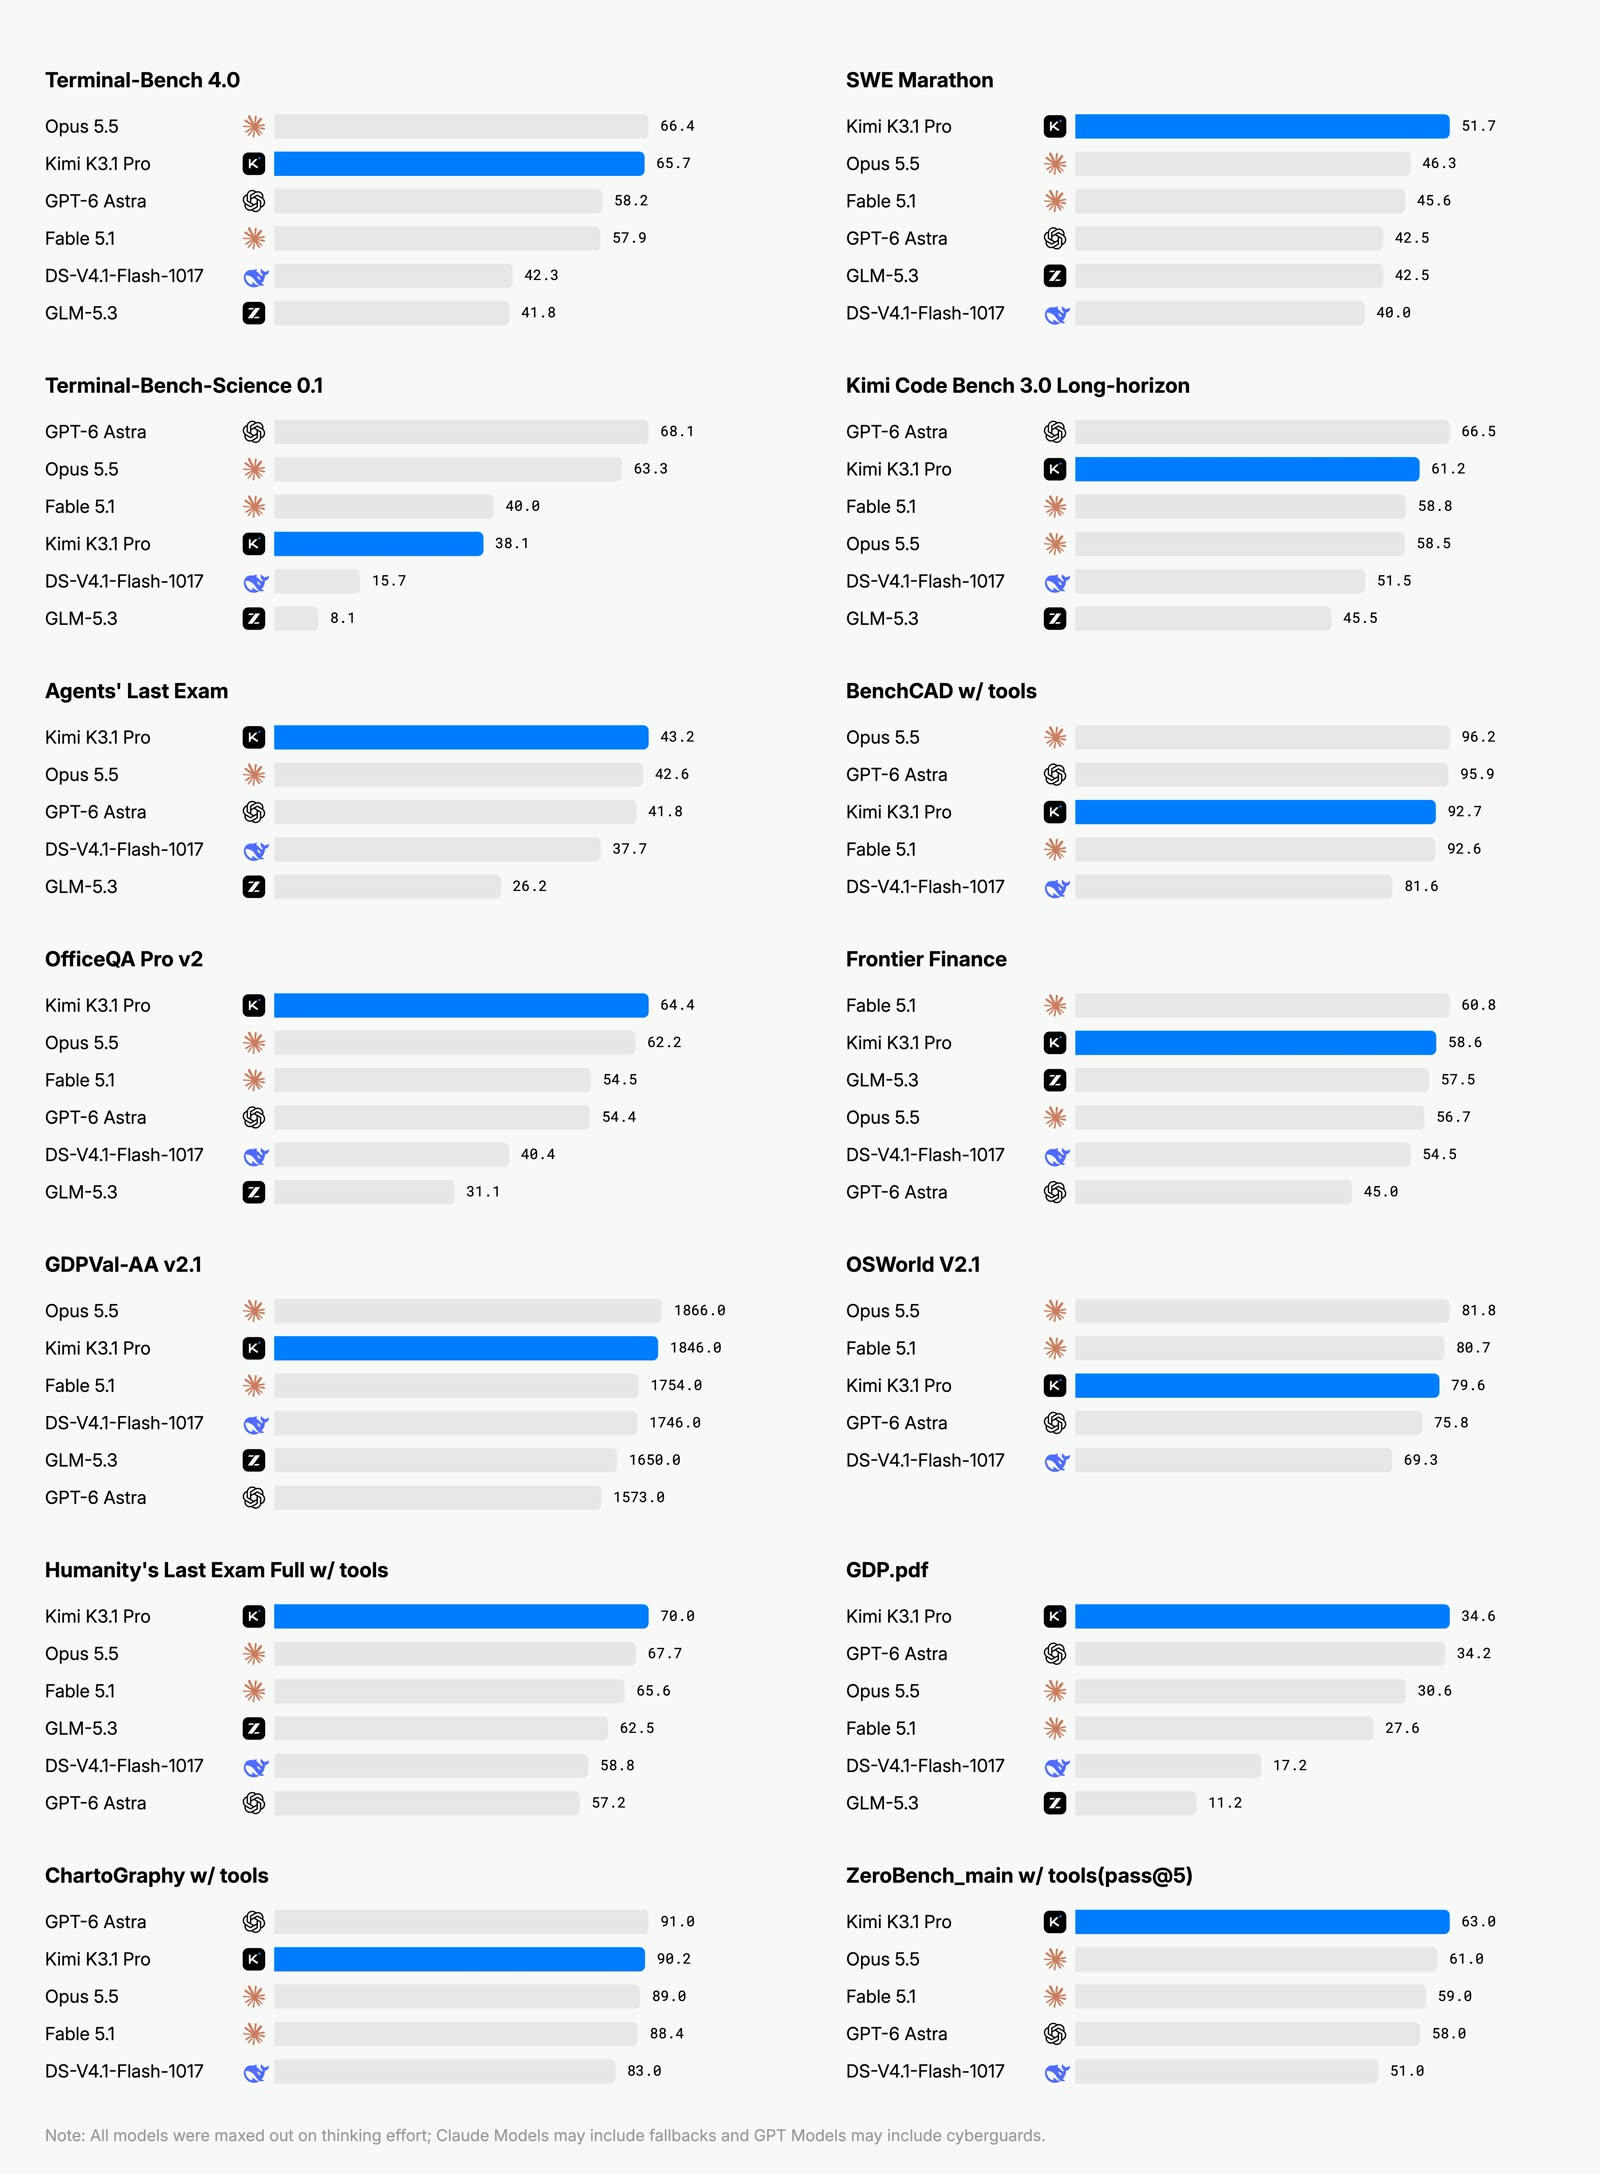
Kimi K3.1 Pro, un modello di intelligenza artificiale cinese scaricabile da chiunque, quasi eguaglia Claude Opus 5.5
Il modello da 2,8 trilioni di parametri di Moonshot AI segna 55 su Artificial Analysis, tre punti dietro Claude Opus 5.5, costa la metà e i suoi pesi completi — i file che permettono a chiunque di eseguirlo autonomamente — saranno disponibili entro il 4 novembre.
Notizie collegate
 Nuovi modelliMirendil lancia Fern 0.1, un modello di AI che può leggere 10 milioni di token in una voltaHerald of AI
Mirendil lancia Fern 0.1, un modello di AI che può leggere 10 milioni di token in una volta
Una nuova AI per la programmazione può tenere in memoria un intero progetto software tutto insieme — utile per gli sviluppatori, ma ancora molto indietro rispetto ai migliori modelli nei compiti di programmazione effettivi.
 Come funzionaUn nuovo motore permette ai modelli AI piccoli di rispondere in meno di 50 millisecondiHerald of AI
Un nuovo motore permette ai modelli AI piccoli di rispondere in meno di 50 millisecondi
Liquid AI afferma che il suo strumento permette all'AI generativa di sostituire vecchi modelli per i controlli antifrode, i pagamenti e la ricerca — senza rallentare le operazioni.
 Nuovi modelliRecursive Releases Flint, a 40B Open-Weight Local Coding Model for AgentsHerald of AI
Recursive Releases Flint, a 40B Open-Weight Local Coding Model for Agents
Flint è il primo modello di Recursive Superintelligence: un agente di codifica locale veloce che gira su hardware consumer.
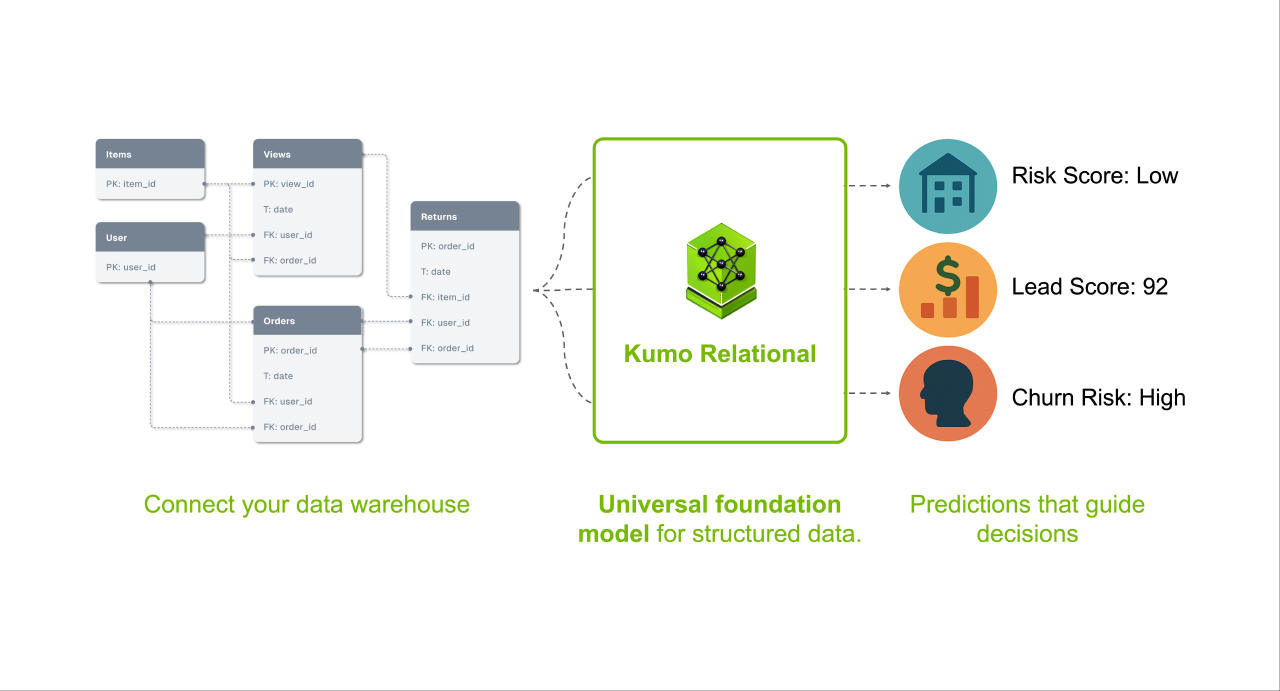 Nuovi modelliNVIDIA Kumo Relational batte il ML supervisionato sui dati relazionali senza trainingHerald of AI
NVIDIA Kumo Relational batte il ML supervisionato sui dati relazionali senza training
Un nuovo modello base pre-addestrato prevede risultati direttamente sui database enterprise, senza bisogno di feature engineering o training specifico per task.