Kumo Relational de NVIDIA supera al ML supervisado en datos relacionales sin entrenamiento
Un nuevo modelo base preentrenado predice resultados directamente en bases de datos empresariales, sin necesidad de ingeniería de características ni entrenamiento específico para cada tarea.
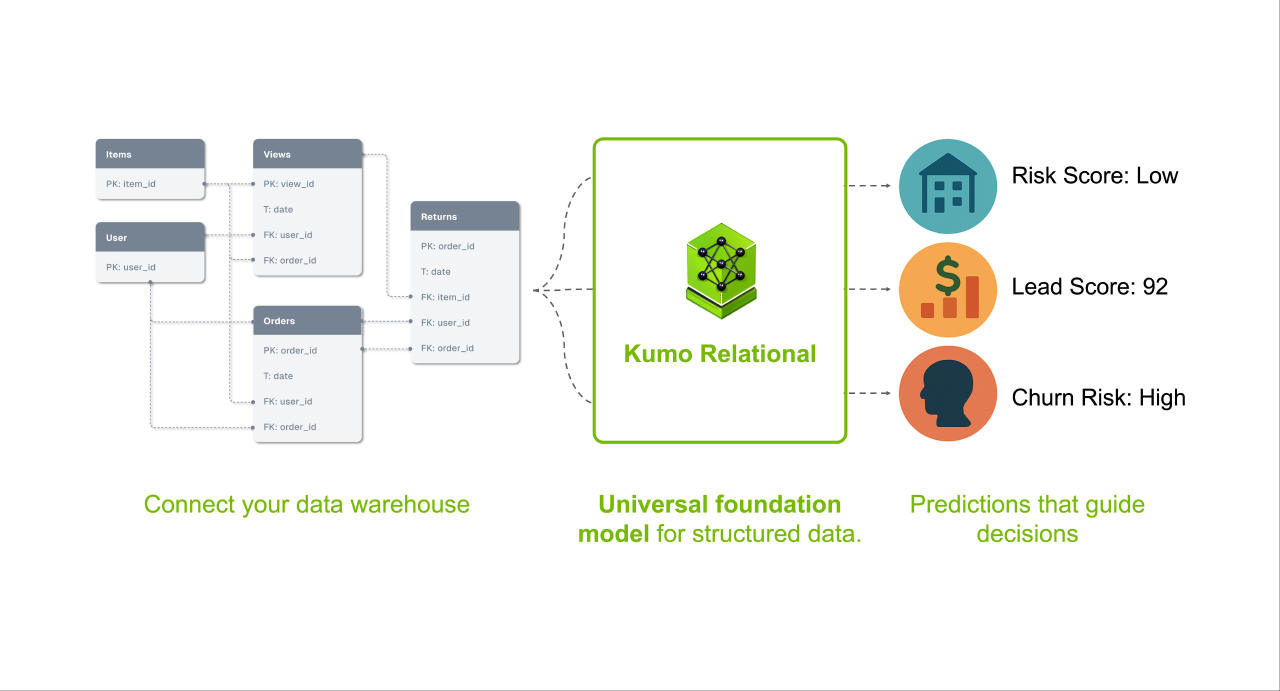
Un nuevo modelo para predicciones en bases de datos
NVIDIA ha lanzado Kumo Relational, un modelo base preentrenado diseñado para trabajar directamente con bases de datos relacionales. En lugar de requerir semanas de ingeniería de características y ajuste de modelos para cada nueva tarea, el modelo puede generar predicciones en un solo paso después de que un usuario describa lo que desea predecir 1.
El sistema extrae hasta 10.000 ejemplos históricos de una base de datos como contexto para cualquier consulta determinada, y luego genera predicciones para resultados como la fuga de clientes, la demanda de productos o el fraude en una sola pasada 1. Está disponible como modelo de código abierto a través de la biblioteca GPU-native structured-data-models de NVIDIA y como un punto final NVIDIA NIM .
Cómo funciona
La mayoría de los modelos base existentes para datos estructurados operan sobre tablas planas individuales. Kumo Relational, en cambio, respeta la estructura real de las bases de datos relacionales, trabajando con tablas, claves foráneas y marcas de tiempo sin aplanarlas en una sola fila ancha 1.
El modelo utiliza aprendizaje en contexto, lo que significa que aprende a partir de los ejemplos de contexto que reúne en el momento de la predicción, en lugar de depender de un entrenamiento específico para cada tarea 1. Aplica mecanismos de atención de grafos para razonar dentro de tablas individuales y entre tablas simultáneamente, conectando registros a través de las relaciones ya definidas en el esquema de la base de datos .
Para tareas de predicción basadas en el tiempo, el sistema reproduce los estados históricos de la base de datos y muestrea subgrafos centrados en la entidad alrededor de los registros que se analizan 1. Un lenguaje de consulta predictiva integrado permite a los usuarios expresar qué predecir en términos naturales, en lugar de escribir código complejo de transformación de datos .
Pruebas de rendimiento
En pruebas que abarcan 41 tareas extraídas de 15 bases de datos, Kumo Relational superó tanto a modelos supervisados de aprendizaje profundo relacional como a pipelines de árboles de gradiente impulsados por expertos 1. En las tareas de clasificación RelBench V1, superó a los árboles de gradiente que utilizan características diseñadas a mano en casi cuatro puntos AUROC, en promedio .
En el benchmark empresarial SAP SALT, Kumo Relational superó a los conjuntos de AutoGluon en ocho puntos porcentuales en rango recíproco medio, sin ajuste fino, y en 13 puntos después del ajuste fino 1. El modelo está diseñado para escalar horizontalmente y manejar bases de datos que contienen más de 500 mil millones de filas .
Los investigadores de NVIDIA desarrollaron el modelo y publicaron sus hallazgos en arXiv 1.
Los datos clave
- Kumo Relational es un modelo base preentrenado que predice directamente en bases de datos relacionales sin requerir entrenamiento específico para cada tarea
- Reúne hasta 10.000 ejemplos históricos de contexto en el momento de la inferencia y utiliza aprendizaje en contexto
- Supera a los modelos supervisados de aprendizaje profundo y a los pipelines de árboles de gradiente en 41 tareas sobre 15 bases de datos
- - En el benchmark SAP SALT, supera a los conjuntos de AutoGluon en un 8% en rango recíproco medio sin ajuste fino
- Escala a bases de datos con más de 500 mil millones de filas y está disponible como software de código abierto y a través de NVIDIA NIM
Fuentes
Noticias relacionadas
 Cómo funcionaUn nuevo motor hace que los modelos pequeños de IA respondan en menos de 50 milisegundosHerald of AI
Un nuevo motor hace que los modelos pequeños de IA respondan en menos de 50 milisegundos
Liquid AI dice que su herramienta permite que la IA generativa reemplace modelos antiguos para verificaciones de fraude, pagos y búsquedas, sin ralentizar los procesos.
 Nuevos modelosRecursive Releases Flint, a 40B Open-Weight Local Coding Model for AgentsHerald of AI
Recursive Releases Flint, a 40B Open-Weight Local Coding Model for Agents
Flint is Recursive Superintelligence's first model: a fast local coding agent running on consumer hardware.
 Cómo funcionaDeepSeek publica como código abierto DeepInfer, su motor de inferencia de alto rendimientoHerald of AI
DeepSeek publica como código abierto DeepInfer, su motor de inferencia de alto rendimiento
El laboratorio de inteligencia artificial chino publicó el marco que respalda sus servicios de producción bajo una licencia Apache 2.0, dando a los desarrolladores acceso a optimizaciones de servicio a gran escala.
 Nuevos modelosvLLM hiper-optimiza Kimi K3 en NVIDIA GB300 para inferencia ultrarrápidaHerald of AI
vLLM hiper-optimiza Kimi K3 en NVIDIA GB300 para inferencia ultrarrápida
Las nuevas optimizaciones llevan el decodificado de Kimi K3 a más de 840 tokens por segundo con batch 1 en 16 GPUs NVIDIA GB300 con DSpark.