Un nuevo motor hace que los modelos pequeños de IA respondan en menos de 50 milisegundos
Liquid AI dice que su herramienta permite que la IA generativa reemplace modelos antiguos para verificaciones de fraude, pagos y búsquedas, sin ralentizar los procesos.
What you could do with it
- Una empresa de pagos podría cambiar sus modelos antiguos de verificación de fraude por un modelo de IA generativa y seguir obteniendo respuestas en menos de 50 milisegundos, manteniendo el flujo del usuario sin interrupciones 1.
- Un sitio de comercio electrónico como Shopify podría ejecutar mejoras de búsqueda en tiempo real en el tráfico en vivo con inferencia de menos de 20 ms, ofreciendo a los compradores resultados más rápidos e inteligentes 1.
- Una plataforma de adtech podría reescribir las consultas de búsqueda del usuario sobre la marcha dentro de un presupuesto de latencia de 50 ms, mejorando la relevancia de los anuncios sin ralentizar la página 1.
What RIPL actually does
La mayoría de las herramientas de servicios de IA como vLLM están diseñadas para trabajos largos en lote — piensa en chatbots o flujos de trabajo agentivos donde unos segundos son aceptables. RIPL está construido para lo contrario: ranking de búsqueda, verificaciones de fraude, autorización de pagos — caminos donde cada milisegundo cuenta 1.
Liquid AI dice que sus LFMs (Liquid Foundation Models) son arquitecturas híbridas que combinan bloques de convolución con bloques GQA (atención de consulta agrupada). El modelo LFM2.5-1.2B tiene 16 capas; el LFM2.5-2.6B tiene 30 1. RIPL optimiza toda la trayectoria desde la llegada de la solicitud hasta la respuesta completada, no solo la velocidad de inferencia .
How fast is it?
Liquid ejecutó benchmarks en una sola GPU NVIDIA B200 1. Estos son los números que reporta la empresa:
| Workload | LFM2.5 on RIPL | Qwen3.5 on vLLM | Gap |
|---|---|---|---|
| Procesar 32 tokens de entrada en 32 tokens de salida a aproximadamente 1.000 solicitudes por segundo: el modelo de 1,2B tarda 34,6 ms mientras que el modelo de 0,8B tarda 498 ms, dando una 14,4× aceleración | |||
| Procesar 256 tokens de entrada en 128 tokens de salida a aproximadamente 400 solicitudes por segundo: el modelo de 1,2B tarda 155,8 ms en comparación con 4.431 ms para el modelo de 0,8B, una 28,4× aceleración | |||
| Procesar 32 tokens de entrada en 32 tokens de salida a alrededor de 1.000 solicitudes por segundo: el modelo de 2,6B tarda 76,4 ms frente a 586,8 ms para el modelo de 2B, una 7,7× aceleración | |||
| Procesar 256 tokens de entrada en 128 tokens de salida a aproximadamente 300 solicitudes por segundo: el modelo de 2,6B tarda 449,1 ms en comparación con 2.499 ms para el modelo de 2B, una 5,6× aceleración |
Liquid también afirma que usando el mismo modelo LFM2.5-350M, RIPL supera a vLLM — lo que significa que el motor en sí añade velocidad, no solo la arquitectura del modelo 1.
Real-world use cases
Liquid mapeó varias cargas de trabajo en tiempo real contra presupuestos de latencia 1:
- Reescritura de consultas de adtech: 32 entrada, 32 salida, presupuesto de 50 ms
- Clasificación de intención de búsqueda: 128 tokens de entrada, 1 token de salida, presupuesto de 20 ms
- Puntuación de riesgo de pagos: 512 tokens de entrada, 16 tokens de salida, presupuesto de 50 ms
- Decisiones de crédito: 8.000 tokens de entrada, 64 tokens de salida, presupuesto de 150 ms
- Texto alternativo de imagen (LFM2.5-VL-450M): imagen de 512×512, presupuesto de 100 ms
Who is using it?
Según Liquid AI, Shopify está desplegando LFMs en producción. La empresa dice que la mejora de búsqueda se ejecuta con inferencia de menos de 20 ms en el tráfico en vivo, usando aproximadamente 50 % menos de parámetros que las alternativas y entregando una inferencia de 2 a 10× más rápida 1.
Liquid AI enfatiza que RIPL es solo para empresas y que todas las cifras son auto-reportadas 1. Los modelos LFM usan la Licencia Abierta LFM v1.0, mientras que las líneas base de Qwen usan Apache 2.0 .
How good is it
Liquid AI reporta latencia p95 de 5,6 a 28,4 veces menor que Qwen3.5 ejecutándose en vLLM, medido en una sola GPU NVIDIA B200 1. En la mayor diferencia, un modelo de 1,2B en RIPL tardó 155,8 ms versus 4.431 ms para un modelo más pequeño de 0,8B en vLLM, una diferencia de 28,4× . Incluso cuando se usa el mismo modelo LFM2.5-350M, RIPL superó a vLLM, lo que significa que el motor en sí añade velocidad más allá del diseño del modelo . Shopify ya está ejecutando LFMs en búsqueda de producción con inferencia de menos de 20 ms en el tráfico en vivo, según Liquid AI .
Los datos clave
- RIPL devuelve respuestas en menos de 50 ms para solicitudes cortas en una sola NVIDIA B200
- Hasta 28,4× menor latencia p95 que Qwen3.5 en vLLM, según los benchmarks de Liquid
- Shopify supuestamente ejecuta inferencia de búsqueda LFM en menos de 20 ms en el tráfico de producción
- RIPL es solo para empresas; todas las cifras de benchmark son auto-reportadas por Liquid AI
- Los modelos LFM2.5 varían de 230M a 2,6B de parámetros y usan un diseño híbrido conv+GQA
Fuentes
- Liquid AI Launches RIPL, a Real-Time Inference Engine for Sub-50 ms LFMs — marktechpost.com
Noticias relacionadas
 Nuevos modelosRecursive Releases Flint, a 40B Open-Weight Local Coding Model for AgentsHerald of AI
Recursive Releases Flint, a 40B Open-Weight Local Coding Model for Agents
Flint is Recursive Superintelligence's first model: a fast local coding agent running on consumer hardware.
 Nuevos modelosKumo Relational de NVIDIA supera al ML supervisado en datos relacionales sin entrenamientoHerald of AI
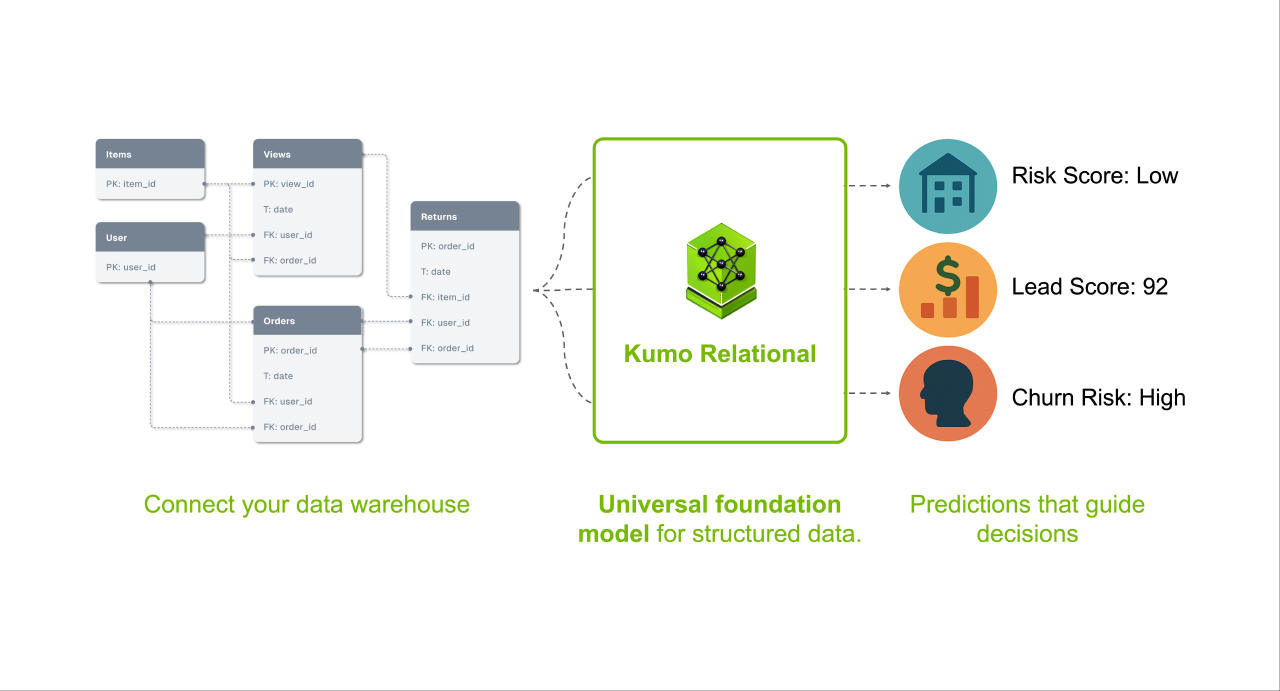
Kumo Relational de NVIDIA supera al ML supervisado en datos relacionales sin entrenamiento
Un nuevo modelo base preentrenado predice resultados directamente en bases de datos empresariales, sin necesidad de ingeniería de características ni entrenamiento específico para cada tarea.
 Cómo funcionaDeepSeek publica como código abierto DeepInfer, su motor de inferencia de alto rendimientoHerald of AI
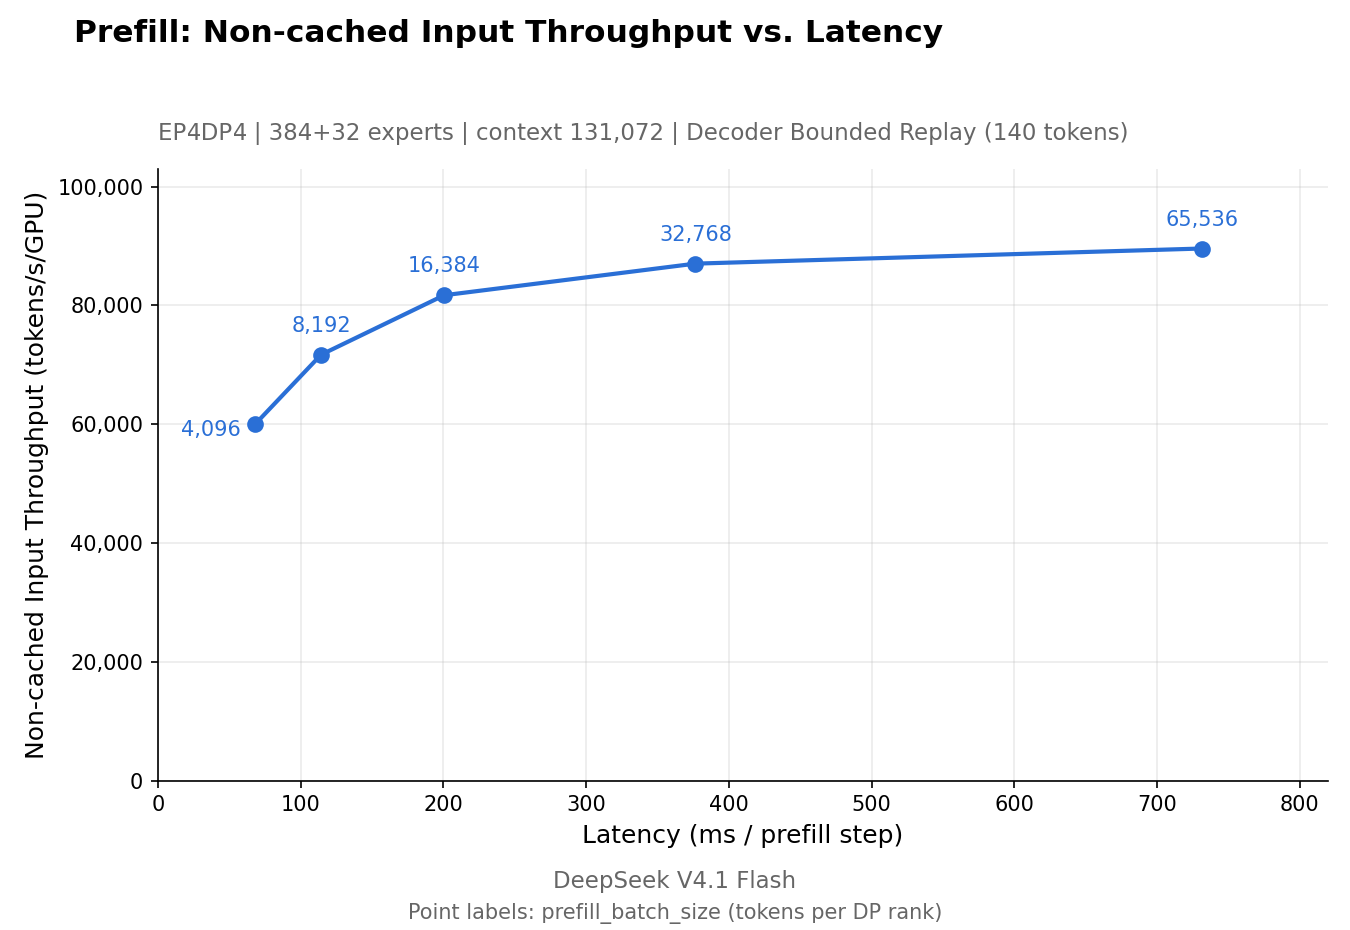
DeepSeek publica como código abierto DeepInfer, su motor de inferencia de alto rendimiento
El laboratorio de inteligencia artificial chino publicó el marco que respalda sus servicios de producción bajo una licencia Apache 2.0, dando a los desarrolladores acceso a optimizaciones de servicio a gran escala.
 Nuevos modelosvLLM hiper-optimiza Kimi K3 en NVIDIA GB300 para inferencia ultrarrápidaHerald of AI
vLLM hiper-optimiza Kimi K3 en NVIDIA GB300 para inferencia ultrarrápida
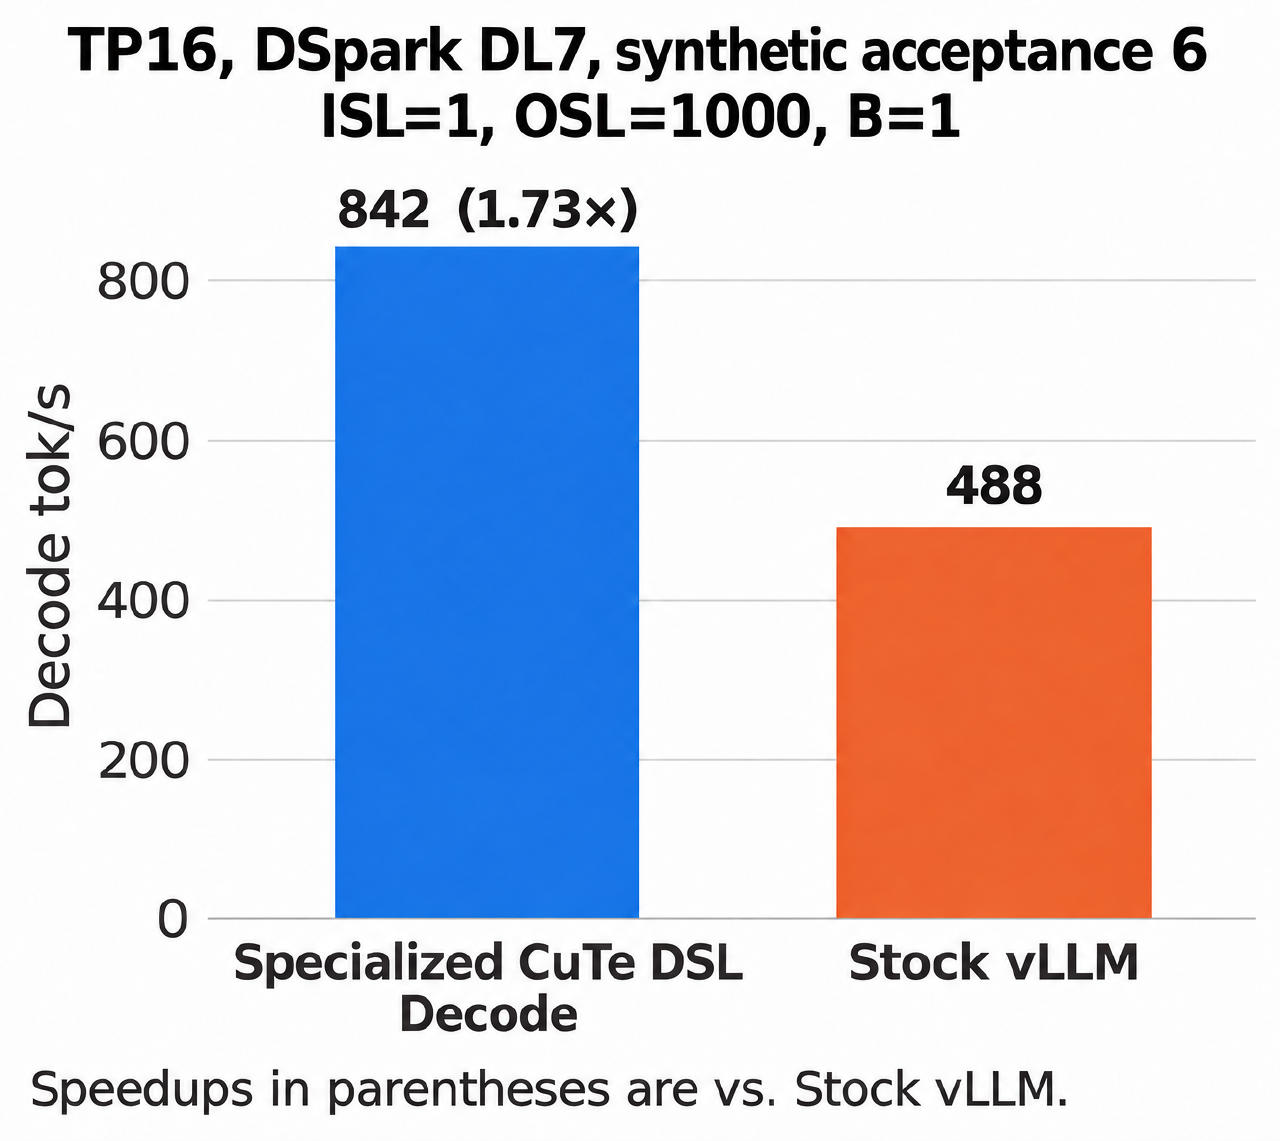
Las nuevas optimizaciones llevan el decodificado de Kimi K3 a más de 840 tokens por segundo con batch 1 en 16 GPUs NVIDIA GB300 con DSpark.