Mirendil lanza Fern 0.1, un modelo de IA que puede leer 10 millones de tokens a la vez
Una nueva IA para programar puede guardar un proyecto completo de software en memoria a la vez: útil para los desarrolladores, pero todavía muy por detrás de los mejores modelos a la hora de escribir código de verdad.
Qué podrías hacer con ello
- Un desarrollador de software podría pegar todo el código de un proyecto —unas media millón de líneas— en el modelo y recibir ayuda que entienda el trabajo completo de una sola vez 1.
- Un investigador podría cargar días de registros de agentes o de entrenamiento en el modelo para depurar ejecuciones o revisar datos sin perder el contexto por cortes 1.
- Un ingeniero podría usar el modelo para ejecutar comandos en una terminal una y otra vez hasta que las pruebas funcionen, trabajando con proyectos grandes sin tener que ir alimentándolo por trozos 1.
Un proyecto entero de un solo golpe
Fern 0.1 puede guardar hasta 10 millones de tokens de entrada, lo que según Mirendil son aproximadamente 23 MB de código o cerca de medio millón de líneas 1. Para hacerse una idea, un proyecto grande de software como Megatron-LM cabe entero en la memoria de trabajo del modelo a la vez .
El modelo va dirigido al trabajo técnico, más que al chat informal. Mirendil enumera seis usos principales: trabajar con proyectos grandes, ejecutar comandos hasta que las pruebas pasen (programación agéntica), depurar ejecuciones de entrenamiento a partir de registros largos, leer trazas completas de agentes o de entrenamiento, y revisar los datos de entrenamiento para buscar duplicados o basura 1.
Cómo se construyó
Fern se basa en Mirendil-Base, un modelo preentrenado por un solo investigador en 3,5 meses con menos de 10 millones de dólares en cálculo total 1. El entrenamiento se ejecutó solo con datos públicos de GitHub, páginas web públicas y conjuntos de datos públicos: sin contenido con licencia, sin datos destilados de otros modelos y sin datos sintéticos . Más del 99 % del código que construyó el modelo fue escrito por agentes de IA, mientras que el investigador humano decidía qué probar y cuándo intervenir .
Fern 0.1 es el más pequeño de tres modelos planificados. La siguiente versión, Mirendil-Base-Large, ya ha superado el 80 % del preentrenamiento y la más grande, Mirendil-Base-XL, lleva más del 20 % hecha 1.
¿Qué tan bien funciona?
En pruebas de contexto largo, Fern puntúa muy alto en tareas sencillas. Mirendil-Base (la versión antes del postentrenamiento) obtuvo el 100 % en una prueba sencilla de buscar una aguja en un pajar a cada longitud, desde 32.000 tokens hasta 10 millones de tokens 1. Sin embargo, el razonamiento en varios pasos bajó al 45 % en el contexto más largo .
Cuando se trata de trabajo real de programación, Fern 0.1 se queda en la mitad del grupo. En Terminal Bench 4.0, una prueba que le pide a una IA arreglar código en una terminal real, obtuvo solo 6,1 % —en comparación con el 66,4 % de Claude Opus 5.5 en la propia tabla comparativa de Mirendil 1. Superó a algunos modelos abiertos más pequeños en otras pruebas, pero se quedó por debajo de todos los modelos de vanguardia y los grandes abiertos .
Mirendil dice que la pérdida del modelo (una medida de la calidad de la predicción) siguió mejorando incluso más allá de 1 millón de tokens, donde otros modelos dejan de reportar cifras 1. En una ventana de 1 millón de bytes, Fern obtuvo 0,165 bits por byte frente a 0,140 de Kimi K3: no la mejor en igualdad de contexto, pero sigue mejorando a distancias más largas .
percentage of coding tasks correctly solved in a real terminal. Más alto es mejor. Datos: Mirendil. Gráfico de Herald of AI.
Quiénes pueden usarlo
Fern 0.1 está disponible solo a través de acceso anticipado alojado; no se han anunciado pesos abiertos ni versiones descargables 1. Las personas pueden solicitar acceso a través del sitio web de Mirendil 2. El modelo tiene entre 0,1 y 0,5 billones de parámetros, aunque Mirendil no ha revelado la cifra exacta .
Esta noticia informa sobre una tendencia con fines divulgativos. No constituye consejo ni aliento para hacer nada de ello.
Los datos clave
- Fern 0.1 tiene una ventana de contexto de 10 millones de tokens, que guarda unos 23 MB de código a la vez
- Construido por un investigador junto a agentes de IA en 3,5 meses por menos de 10 millones de dólares
- Puntúa 100 % en recuperación sencilla de contexto largo, pero solo 6,1 % en Terminal Bench 4.0
- Disponible solo por acceso anticipado alojado; no se anunciaron pesos abiertos
- Dos modelos más grandes ya están en desarrollo en Mirendil
Fuentes
Noticias relacionadas
 Nuevos modelosKimi K3.1 Pro, un modelo de IA chino que cualquiera podrá descargar, casi iguala a Claude Opus 5.5Herald of AI
Kimi K3.1 Pro, un modelo de IA chino que cualquiera podrá descargar, casi iguala a Claude Opus 5.5
El modelo de Moonshot AI con 2,8 billones de parámetros puntúa 55 en Artificial Analysis, tres puntos por debajo de Claude Opus 5.5, cuesta la mitad y sus pesos completos —los archivos que permiten ejecutarlo cualquiera— llegarán el 4 de noviembre.
 Nuevos modelosvLLM hiper-optimiza Kimi K3 en NVIDIA GB300 para inferencia ultrarrápidaHerald of AI
vLLM hiper-optimiza Kimi K3 en NVIDIA GB300 para inferencia ultrarrápida
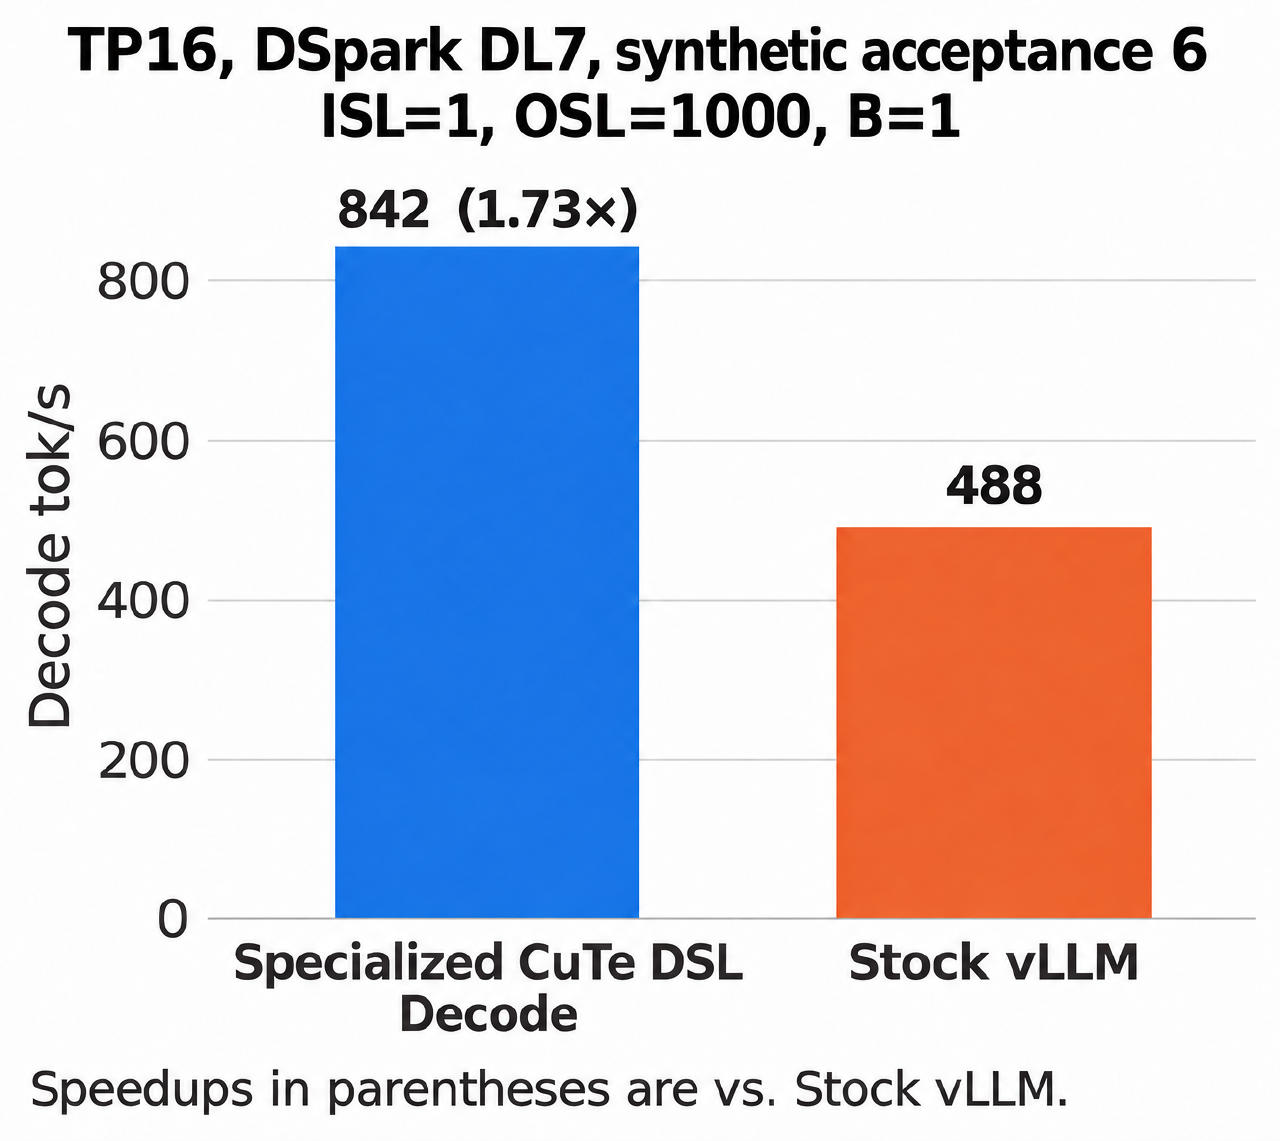
Las nuevas optimizaciones llevan el decodificado de Kimi K3 a más de 840 tokens por segundo con batch 1 en 16 GPUs NVIDIA GB300 con DSpark.
 Nuevos modelosStepFun publica pesos abiertos para su modelo Step 5 Preview de 600BHerald of AI
StepFun publica pesos abiertos para su modelo Step 5 Preview de 600B
El laboratorio de IA chino ha puesto a disposición su gran modelo Mixture-of-Experts para autoalojamiento, dirigido a desarrolladores que crean agentes de codificación y herramientas financieras.
 Nuevos modelosGemini 4 Argon intenta su suerte programando bots de StarCraftHerald of AI
Gemini 4 Argon intenta su suerte programando bots de StarCraft
El nuevo modelo de Google se ubica en el tercer puesto en un examen donde los sistemas de IA escriben bots para el clásico juego de estrategia en tiempo real.