Kimi K3.1 obtiene buena puntuación en inteligencia y se sitúa en el segmento de rentabilidad
El modelo puede resolver problemas difíciles y ofrece una capacidad sólida de razonamiento por su precio, pero genera respuestas largas y es lento.
Cómo funciona
Un programa de IA que resuelve problemas complicados de derecho, finanzas, ingeniería y programación, y después redacta respuestas detalladas.
- Cargá documentos o escribí tu pregunta
- Analiza el problema con cuidado
- Genera una respuesta larga y detallada
- Tardas un poco más de lo normal
Qué se puede hacer con él
- Un profesional del derecho podría alimentar al modelo hasta con 1.500 páginas A4 de documentos a la vez y recibir análisis de texto detallado para respaldar la investigación de casos 1.
- Un contador podría usar el modelo para resolver tareas complejas de finanzas y contabilidad, confiando en su sólida capacidad de razonamiento a pesar de los tiempos de respuesta más largos 1.
- Un equipo de ingeniería podría desplegar el modelo para trabajo desafiante de codificación, automatización y resolución de problemas científicos donde el pensamiento profundo importa más que la velocidad 1.
Lo que dicen las puntuaciones
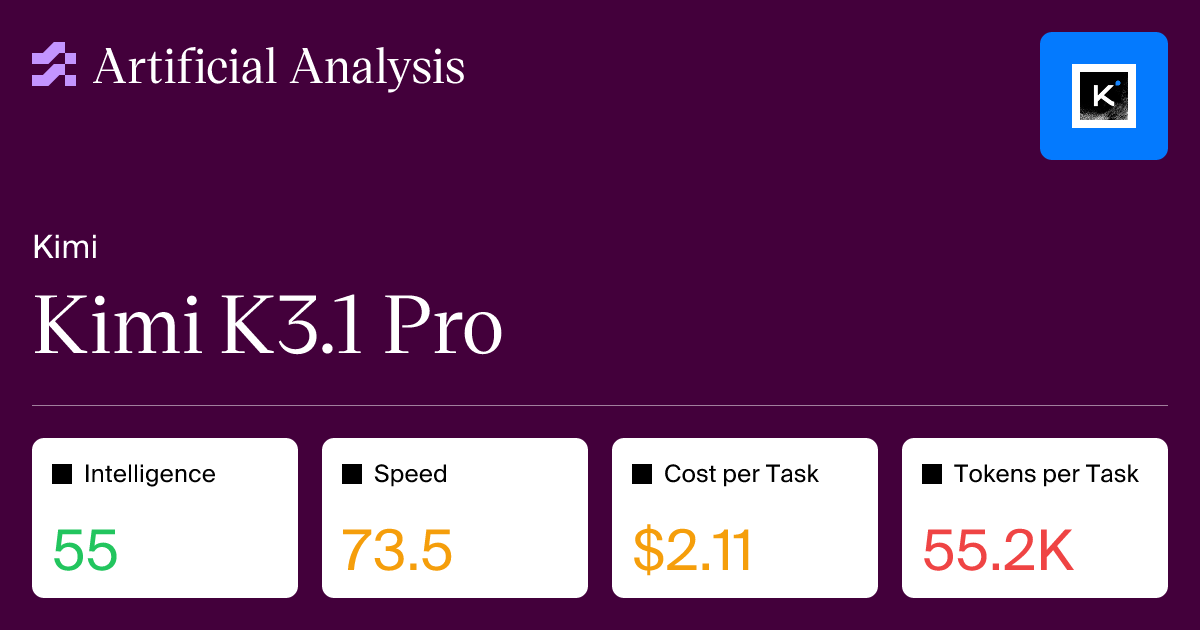
Kimi K3.1 Pro ocupó el puesto número 4 entre 215 modelos en el Índice de Inteligencia de Artificial Analysis con una puntuación de 55, muy por encima de la puntuación mediana de 27 1. El modelo fue evaluado generando 113 millones de tokens de salida, lo que lo hace algo extenso en comparación con la mediana de 104 millones .
En términos de velocidad, el modelo produjo 77,1 tokens de salida por segundo, ubicándose en el puesto #106 entre 186 modelos —más lento que el promedio de 81 tokens por segundo 1.
En cuanto al coste, el modelo cobra 2,00 dólares por millón de tokens de entrada (costoso, mediana: 0,43 dólares) y 10,00 dólares por millón de tokens de salida (costoso, mediana: 1,84 dólares) 1. También ofrece un descuento de cache del 90 por ciento . El coste promedio por tarea del Índice de Inteligencia resultó ser de 3,68 dólares .
Estar en la línea de Pareto
Artificial Analysis grafica cada modelo en un gráfico que muestra la inteligencia contra el coste por tarea. Los modelos en la "línea Pareto" son aquellos en los que no se puede obtener más inteligencia sin pagar más 1.
Kimi K3.1 Pro se sitúa en esta frontera de eficiencia junto a modelos de empresas como Google, OpenAI, Anthropic, DeepSeek y StepFun 1. Esto significa que el modelo es considerado una de las mejores opciones de relación calidad-precio para su nivel de inteligencia: no se paga extra por capacidades inteligentes que podrían conseguirse más barato en otro lugar .
Qué puede hacer el modelo
Kimi K3.1 Pro es un modelo de razonamiento de pesos abiertos lanzado en octubre de 2026 1. Soporta entrada de texto e imagen y produce solo salida de texto . Tiene una ventana de contexto de un millón de tokens, que equivale aproximadamente a unas 1.500 páginas A4 con tamaño 12 de fuente Arial .
El Índice de Inteligencia en sí mismo está compuesto por 9 evaluaciones diferentes: AA-Briefcase v1.1, AutomationBench-AA, Terminal-Bench 4.0, FrontierCode-AA 2.0, AA-Omniscience v1.1, GDP.pdf, HLE-Diamond, CritPt v2 (Subconjunto Difícil), y Terminal-Bench-Science 0.1 1. Estas pruebas miden habilidades en áreas como codificación, automatización, ciencia, finanzas, trabajo legal y resolución general de problemas .
Si bien Kimi K3.1 Pro ofrece inteligencia de primer nivel para su rango de precio, los usuarios deben esperar respuestas más largas y velocidades de salida más lentas en comparación con muchos otros modelos disponibles en el mercado 1.
¿Para quién es?
El modelo está dirigido a usuarios que necesitan una fuerte capacidad de razonamiento y pueden trabajar con tiempos de generación más largos y salidas más extensas 1. Es particularmente adecuado para tareas en finanzas, contabilidad, trabajo legal, ingeniería y estrategia —áreas donde el pensamiento profundo importa más que la velocidad .
El modelo actualmente no tiene API disponible públicamente, lo que significa que el acceso puede estar limitado a ciertas plataformas o asociaciones en este momento 1.
Correcciones y actualizaciones
- Corregido el 12 de noviembre de 2026. Una versión anterior describía a Kimi K3.1 Pro como propietario, con precios en la mediana, de menor rendimiento y más extenso; la versión corregida indica que es de pesos abiertos, muy por encima de la mediana tanto en precios de entrada como de salida, moderadamente extenso y costoso.
Los datos clave
- Kimi K3.1 Pro obtuvo una puntuación de 55 en el Índice de Inteligencia de Artificial Analysis, ubicándose en el puesto #4 entre 215 modelos
- Se sitúa en la línea de eficiencia Pareto, lo que significa que ofrece una sólida inteligencia para su precio
- The model costs $2 per million input tokens and
0 por millón de tokens de salida, ambos muy por encima de la mediana (mediana de entrada: 0,43 dólares, mediana de salida: ## Hechos clave
.84)
- Genera 113 millones de tokens durante las pruebas, lo que lo hace algo extenso en comparación con la mediana de 104M
- La velocidad es de 77,1 tokens por segundo, más lenta que el promedio de 81
Fuentes
Sigue leyendo
 Nuevos modelosClaude Fable 5.2 alcanza 65 en el Índice de Inteligencia de Artificial Analysis — la puntuación más alta hasta ahoraHerald of AINuevos modelos
Claude Fable 5.2 alcanza 65 en el Índice de Inteligencia de Artificial Analysis — la puntuación más alta hasta ahora
La última versión de Claude de Anthropic lidera un ranking ampliamente seguido de IA, pero viene con precios elevados y largos tiempos de espera.
 La semanaEsta semana en IA: llegan nuevos modelos y los agentes se vuelven más segurosHerald of AI
 Nuevos modelosMeta lanza Muse Ember, un modelo de IA económico diseñado para tareas repetitivas de agentesHerald of AI
 Nuevos modelosEl Muse Ember de Meta iguala a Claude Haiku con un tercio del costeHerald of AI
Noticias relacionadas
 Nuevos modelosEl nuevo modelo de IA de Kimi se acerca a los principales competidores estadounidenses en diseño 3D y los iguala en programaciónHerald of AI
El nuevo modelo de IA de Kimi se acerca a los principales competidores estadounidenses en diseño 3D y los iguala en programación
Kimi K3.1 Pro permite crear videojuegos completos, modelos 3D y análisis financieros — ya disponible para usar hoy.
 Nuevos modelosMeta lanza Muse Spark Open, un modelo de pesos abiertos diseñado para funcionar en MacsHerald of AI
Meta lanza Muse Spark Open, un modelo de pesos abiertos diseñado para funcionar en Macs
El nuevo modelo de 816 mil millones de parámetros puede ejecutarse localmente en computadoras Apple, pero se necesita hardware potente para que funcione.
 Nuevos modelosDeepSeek lanza V4.1 Flash 1017 Max con contexto de 1 millón de tokens y capacidad de razonamientoHerald of AI
DeepSeek lanza V4.1 Flash 1017 Max con contexto de 1 millón de tokens y capacidad de razonamiento
El nuevo modelo de pesos abiertos obtiene las mejores puntuaciones en tests de inteligencia y velocidad de Artificial Analysis.
 Nuevos modelosLiquid AI presenta el modelo de decisiones d1-ultra que lidera el ranking de benchmarks de IAHerald of AI
Liquid AI presenta el modelo de decisiones d1-ultra que lidera el ranking de benchmarks de IA
El nuevo modelo lee texto e imágenes para responder preguntas con probabilidades en lugar de generar texto, reduciendo costos para desarrolladores.