DeepSeek lanza V4.1 Flash 1017 Max con contexto de 1 millón de tokens y capacidad de razonamiento
El nuevo modelo de pesos abiertos obtiene las mejores puntuaciones en tests de inteligencia y velocidad de Artificial Analysis.
Qué se ha publicado
DeepSeek ha lanzado DeepSeek V4.1 Flash 1017 (Max), un modelo de IA con capacidad de razonamiento y pesos de modelo abiertos, según una página de Artificial Analysis.
El modelo llegó en octubre de 2026 y tiene licencia MIT, lo que significa que cualquiera puede usar o modificar los pesos. DeepSeek dijo que esta versión admite entradas de texto e imágenes y genera texto como salida.
Cómo funciona
Artificial Analysis le otorgó al modelo 4 de 4 unidades en Inteligencia, Velocidad y Verbosidad, mientras que lo calificó con 2 de 4 en Costo en su índice de referencia.
El modelo mantiene una clasificación alta de inteligencia en su categoría, situándose cerca de la cima entre más de 700 modelos con pesos abiertos evaluados. También se ejecuta a aproximadamente 209 tokens de salida por segundo, lo que el sitio describe como notablemente rápido.
Una compensación notable es la verbosidad. Artificial Analysis registró 210 millones de tokens de salida durante sus pruebas de referencia, muy por encima de la mediana para modelos similares.
Especificaciones clave
El modelo utiliza una arquitectura de mezcla de expertos con 552 mil millones de parámetros totales, pero solo activa 16 mil millones por token durante la inferencia. Ese diseño le permite manejar tareas grandes sin necesidad de ejecutar el modelo completo.
Soporta una ventana de contexto de un millón de tokens, aproximadamente equivalente a 1.500 páginas A4 de texto estándar. Esto lo hace adecuado para procesar documentos muy largos o grandes bases de código de una sola vez.
Los datos de precios de Artificial Analysis muestran costos de entrada de $0,30 por millón de tokens y costos de salida de $1,20 por millón de tokens, con un descuento del 98 por ciento en la memoria caché que reduce aún más los precios efectivos.
Actualmente, el modelo no cuenta con una API disponible públicamente a través de Artificial Analysis.
Qué miden las referencias
Artificial Analysis evalúa los modelos mediante su Índice de Inteligencia, que combina diez pruebas separadas, incluidos desafíos de programación, tareas de razonamiento y verificaciones de conocimiento. DeepSeek V4.1 Flash 1017 (Max) obtuvo 45 en ese índice, en comparación con una mediana de 19 entre modelos similares.
Las pruebas cubren una mezcla de habilidades generales y específicas del dominio, incluidas finanzas, ingeniería y estrategia.
Correcciones y actualizaciones
- Corrected on 20 October 2026. An earlier version said the model runs at about 225 output tokens per second; the source states 208.7 tokens per second, rounded to 209.
Los datos clave
- Modelo de razonamiento de pesos abiertos con licencia MIT publicado en octubre de 2026
- 552 mil millones de parámetros totales con solo 16 mil millones activos por token
- Ventana de contexto de 1 millón de tokens, aproximadamente 1.500 páginas A4
- Puntuación de 4 de 4 en las referencias de Inteligencia, Velocidad y Verbosidad
- No se listó API disponible públicamente por Artificial Analysis
Fuentes
Cada dato de esta noticia viene de la fuente de arriba.
Noticias relacionadas
 Nuevos modelosKimi K3.1 Pro, un modelo de IA chino que cualquiera podrá descargar, casi iguala a Claude Opus 5.5Herald of AI
Kimi K3.1 Pro, un modelo de IA chino que cualquiera podrá descargar, casi iguala a Claude Opus 5.5
El modelo de Moonshot AI con 2,8 billones de parámetros puntúa 55 en Artificial Analysis, tres puntos por debajo de Claude Opus 5.5, cuesta la mitad y sus pesos completos —los archivos que permiten ejecutarlo cualquiera— llegarán el 4 de noviembre.
 Cómo funcionaEl RL agéntico tiene una ley de escalamiento — y cambia cómo deberías gastar tu presupuestoHerald of AI
El RL agéntico tiene una ley de escalamiento — y cambia cómo deberías gastar tu presupuesto
Un nuevo estudio descubre que, en el aprendizaje por refuerzo agéntico, diversificar los mundos en los que entrena tu agente supera con creces generar más trayectorias — y la combinación adecuada puede rendir hasta 1,7× más eficiencia computacional.
 Cómo funcionaDeepSeek publica como código abierto DeepInfer, su motor de inferencia de alto rendimientoHerald of AI
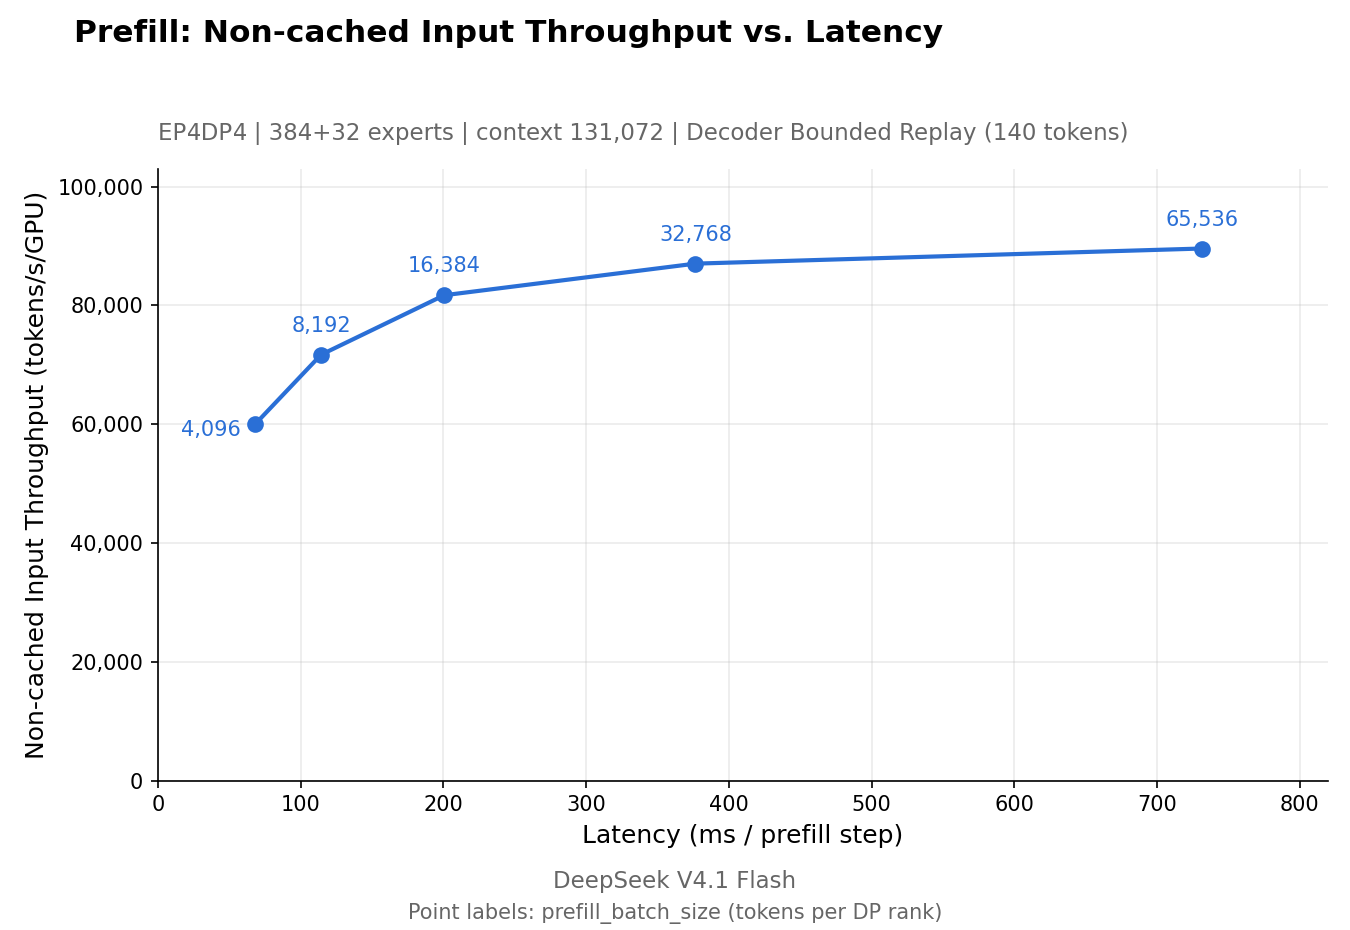
DeepSeek publica como código abierto DeepInfer, su motor de inferencia de alto rendimiento
El laboratorio de inteligencia artificial chino publicó el marco que respalda sus servicios de producción bajo una licencia Apache 2.0, dando a los desarrolladores acceso a optimizaciones de servicio a gran escala.
 Nuevos modelosEE. UU. prohíbe DeepSeek en sistemas de agencias federales con nueva orden del DHSHerald of AI
EE. UU. prohíbe DeepSeek en sistemas de agencias federales con nueva orden del DHS
La prohibición excluye a la empresa de inteligencia artificial china de cualquier sistema utilizado por agencias del gobierno civil.