Technologies
vLLM
vLLM es una biblioteca de software de código abierto que ayuda a las empresas a ejecutar modelos grandes de IA más rápido y a menor costo en GPU.
2 noticias, reportadas por primera vez el 23 de octubre de 2026.
Qué es vLLM
vLLM es una biblioteca de código abierto que despliega modelos de lenguaje grande en unidades de procesamiento gráfico (GPU). Piensa en ella como el motor bajo el capó de cualquier servicio de IA: toma un modelo entrenado y lo convierte en algo capaz de responder preguntas con la rapidez suficiente para usuarios reales.
El proyecto es conocido por hacer que la inferencia de IA (el proceso de ejecutar un modelo para generar respuestas) sea mucho más rápida que la configuración predeterminada con la que la mayoría comienza. Se usa ampliamente como herramienta base contra la cual otras empresas miden sus resultados. Por ejemplo, cuando Liquid AI presentó su motor RIPL en octubre de 2026, comparó sus resultados directamente con Qwen3.5 ejecutándose en vLLM.
Qué hizo vLLM en octubre de 2026
En octubre de 2026, el equipo de vLLM lanzó un conjunto importante de optimizaciones personalizadas para GPU del modelo Kimi K3 ejecutado en chips NVIDIA Blackwell (específicamente GPUs GB300). El equipo escribió desde cero nuevas instrucciones para GPU, llamadas kernels, utilizando el framework CuTe de NVIDIA, en lugar de depender de la configuración estándar de vLLM.
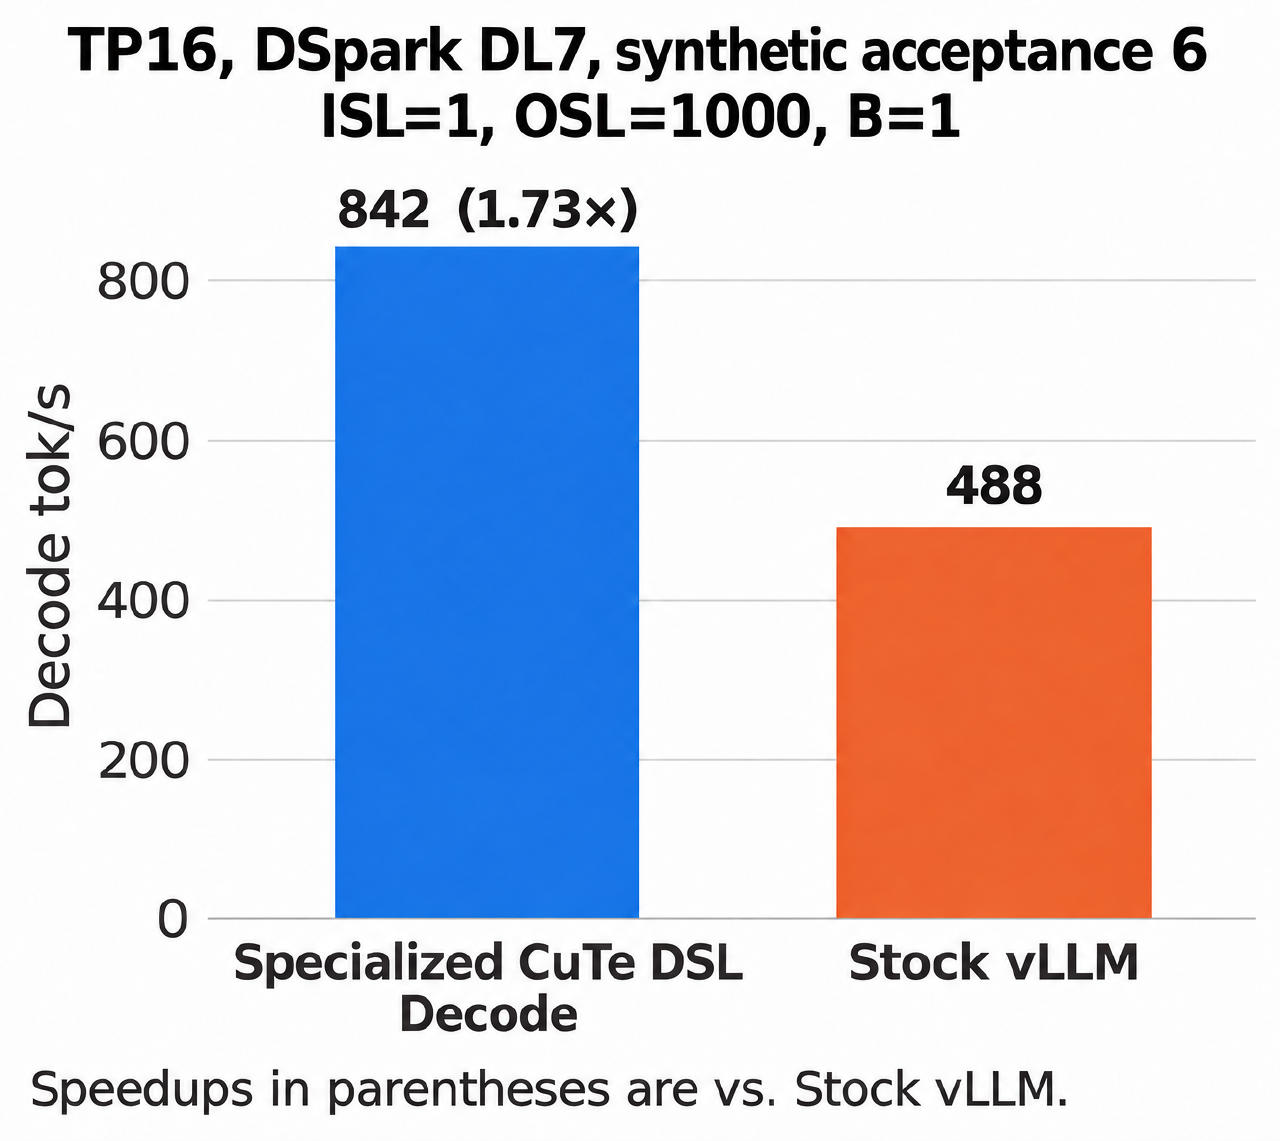
Los resultados fueron significativos. En una sola consulta usando 16 GPUs GB300, la versión optimizada logró más de 840 tokens por segundo durante la decodificación —el proceso paso a paso de generar una palabra a la vez—, aproximadamente el doble de velocidad que la configuración estándar de vLLM. La latencia de decodificación bajó de 130 microsegundos por capa a 69 microsegundos, y la cantidad de kernels necesarios por capa pasó de 23 a solo 13.
Cuatro técnicas clave hicieron esto posible:
- Ajuste de forma (shape tuning): Diferentes tamaños de lote usan diferentes kernels, de modo que los recursos de GPU permanecen plenamente ocupados en cada carga de trabajo.
- Superposición de cómputo y comunicación: La salida de atención se fusiona directamente con su operación de all-reduce y el cálculo residual posterior, reduciendo el movimiento de datos entre GPUs.
- Mejora del enrutamiento en Mixture of Experts: Las puntuaciones del router y los cálculos de expertos se distribuyen entre ranuras de GPU, reduciendo el trabajo redundante y permitiendo que el experto compartido ejecute en paralelo en un stream separado.
- Precarga de pesos en caché: Mientras las GPUs manejan la comunicación, un kernel lateral precarga los pesos necesarios para la siguiente operación, evitando los cuellos de botella de memoria comunes en la inferencia con lotes pequeños.
El rendimiento de decodificación aumentó hasta 1,5–2× en las configuraciones probadas, y la interactividad P90 mejoró hasta 1,8× en la carga de trabajo AgentX.
El enfoque agéntico
Lo que hizo esta ronda de trabajo especialmente notable fue cómo se realizó. Por primera vez, agentes de IA ayudaron a escribir y ajustar las partes más complejas del código: los kernels personalizados de GPU, la fusión de operaciones y la coordinación de la comunicación entre muchas GPUs. En lugar de que los humanos revisaran cada línea individual del código de optimización escrito a mano, el equipo construyó sistemas capaces de verificar la corrección automáticamente. El equipo indicó en su publicación de octubre de 2026 que "necesitamos cambiar cómo organizamos el trabajo de rendimiento".
vLLM planea aplicar el mismo enfoque de optimización agéntica a otros modelos y hardware, con la esperanza de que la comunidad ayude a desarrollar las herramientas de verificación y validación necesarias para implementar código rápido pero seguro.
Preguntas que la gente hace
¿Qué hace exactamente vLLM?
vLLM es un software de código abierto que ejecuta modelos de IA entrenados en GPU para que puedan responder preguntas lo suficientemente rápido como para usuarios reales. Si alguna vez has usado un chatbot de IA, es probable que vLLM sea el tipo de herramienta que funciona detrás de escena para que las respuestas lleguen rápidamente.
¿Por qué vLLM se volvió más rápido en octubre de 2026?
El equipo de vLLM escribió kernels de GPU completamente personalizados — programas de bajo nivel que indican a los chips exactamente qué calcular — utilizando el framework CuTe de NVIDIA, específicamente para el modelo Kimi K3 en GPUs GB300. El resultado fue más de 840 tokens por segundo en una única consulta a través de 16 GPUs, aproximadamente el doble de la velocidad de la configuración estándar.
¿Qué es el 'enfoque agéntico' mencionado por vLLM?
Por primera vez, agentes de IA ayudaron a escribir y ajustar las partes más complejas del código de optimización, incluyendo kernels personalizados y comunicación multi-GPU. En lugar de que los humanos revisen cada línea, el equipo está construyendo sistemas que verifican la corrección automáticamente, y planean aplicar este método a otros modelos y hardware.
Escrito solo por IA a partir de las historias enumeradas a continuación, cada una de las cuales enlaza con sus propias fuentes.
Historias sobre otra cosa que mencionan a vLLM de paso, con la oración que lo hace.
 Cómo funcionaUn nuevo motor permite que los modelos pequeños de IA respondan en menos de 50 milisegundosHerald of AI▶