Tecnologie
vLLM
vLLM è una libreria software open-source che aiuta le aziende a eseguire modelli AI su larga scala più velocemente e a minor costo sulle GPU.
2 notizie, coperte per la prima volta il 23 ottobre 2026.
Che cos'è vLLM
vLLM è una libreria open-source che serve modelli linguistici di grandi dimensioni su unità di elaborazione grafica (GPU). Pensatela come il motore sotto il cofano di qualsiasi servizio AI: prende un modello addestrato e lo trasforma in qualcosa capace di rispondere alle domande con la velocità necessaria per utenti reali.
Il progetto è noto soprattutto per rendere l'inferenza AI (il processo di esecuzione di un modello per produrre risposte) molto più veloce rispetto alle impostazioni predefinite da cui la maggior parte delle persone parte. È ampiamente utilizzato come strumento di riferimento contro cui altre aziende misurano i propri risultati. Per esempio, quando Liquid AI ha presentato il suo motore RIPL nell'ottobre 2026, ha confrontato direttamente i suoi risultati con Qwen3.5 in esecuzione su vLLM.
Cosa ha fatto vLLM nell'ottobre 2026
Nell'ottobre 2026, il team di vLLM ha rilasciato una vasta serie di ottimizzazioni personalizzate per GPU per il modello Kimi K3 in esecuzione sui chip NVIDIA Blackwell (in particolare GPU GB300). Il team ha scritto ex novo le istruzioni GPU, chiamate kernel, da zero utilizzando il framework CuTe di NVIDIA, anziché affidarsi alla configurazione standard di vLLM.
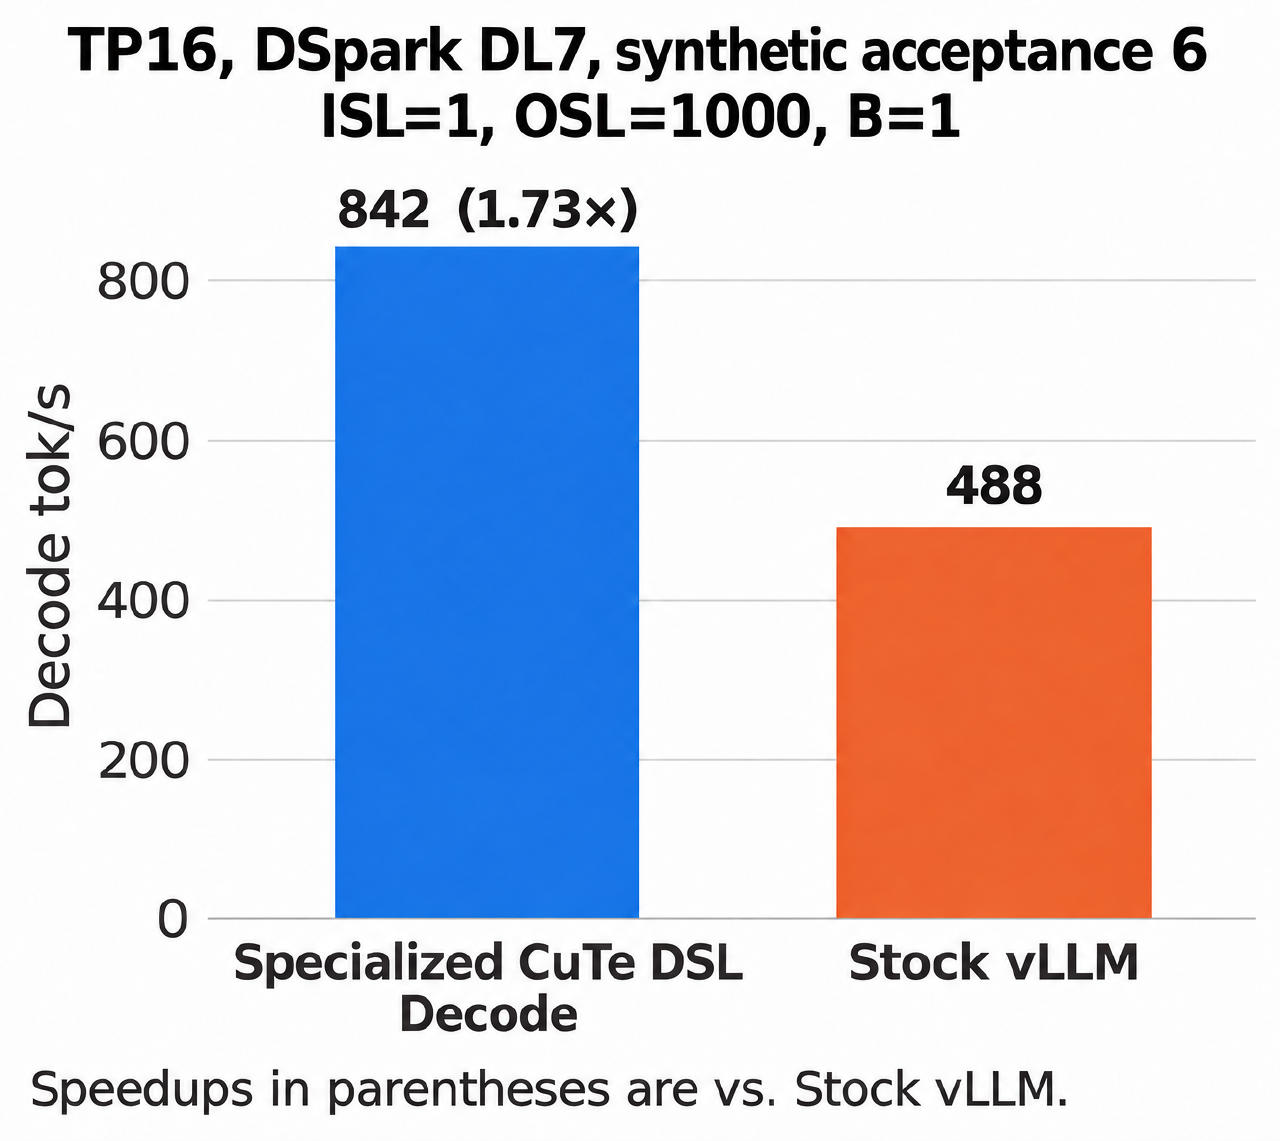
I risultati sono stati significativi. Su una singola query utilizzando 16 GPU GB300, la versione ottimizzata ha raggiunto oltre 840 token al secondo durante il decoding — il processo passo dopo passo di generazione di una parola alla volta — circa il doppio della velocità della configurazione standard di vLLM. La latenza di decoding è scesa da 130 microsecondi per layer a 69 microsecondi, e il numero di kernel necessari per layer è passato da 23 a soli 13.
Quattro tecniche chiave hanno reso questo possibile:
- Sintonizzazione della forma: Diverse dimensioni del batch utilizzano kernel diversi in modo che le risorse GPU rimangano pienamente occupate a ogni carico di lavoro.
- Sovrapposizione tra calcolo e comunicazione: L'output dell'attenzione viene fuso direttamente con la sua operazione all-reduce e il successivo calcolo residuo, riducendo lo spostamento di dati tra le GPU.
- Miglioramento dello scheduling del Mixture of Experts: I punteggi del router e i calcoli degli expert vengono distribuiti tra i ranghi delle GPU, riducendo il lavoro ridondante e consentendo all'expert condiviso di essere eseguito in parallelo su uno stream separato.
- Precaricamento dei pesi nella cache: Mentre le GPU gestiscono la comunicazione, un kernel secondario precarica i pesi necessari per l'operazione successiva, evitando colli di bottiglia di memoria tipici dell'inferenza con batch piccoli.
Il throughput di decoding è aumentato fino a 1,5–2× in tutte le configurazioni testate, e l'interattività P90 è migliorata fino a 1,8× sul carico di lavoro AgentX .
L'approccio Agentic
Cosa ha reso notevole questo ciclo di lavoro è stato il modo in cui è stato realizzato. Per la prima volta, agenti AI hanno aiutato a scrivere e ottimizzare le parti più complesse del codice — i kernel GPU personalizzati, la fusione delle operazioni e il coordinamento della comunicazione tra molte GPU. Invece di far revisionsare ogni singola riga di codice di ottimizzazione scritto a mano, il team ha costruito sistemi capaci di verificare automaticamente la correttezza. Nel post del blog di ottobre 2026, il team ha dichiarato che «possiamo cambiare il modo in cui organizziamo il lavoro sulle prestazioni».
vLLM prevede di applicare lo stesso approccio di ottimizzazione agentic ad altri modelli e hardware, nella speranza che la comunità contribuisca a sviluppare gli strumenti di verifica e validazione necessari per rilasciare codice rapido ma sicuro.
Domande più frequenti
Cosa fa effettivamente vLLM?
vLLM è un software open-source che esegue modelli AI addestrati su GPU, consentendo loro di rispondere alle domande con una velocità sufficiente per gli utenti reali. Se hai mai usato un chatbot AI, vLLM è probabilmente il tipo di strumento che gira dietro le quinte per far arrivare le risposte rapidamente.
Perché vLLM è diventato più veloce nell'ottobre 2026?
Il team di vLLM ha scritto kernel GPU completamente personalizzati — programmi a basso livello che dicono ai chip esattamente cosa calcolare — utilizzando il framework CuTe di NVIDIA, specificamente per il modello Kimi K3 su GPU GB300. Il risultato è stato oltre 840 token al secondo su una singola query su 16 GPU, circa il doppio della velocità della configurazione standard.
Cos'è l'"approccio agentic" menzionato da vLLM?
Per la prima volta, agenti AI hanno aiutato a scrivere e ottimizzare le parti più complesse del codice di ottimizzazione, inclusi kernel personalizzati e comunicazione multi-GPU. Invece di farrevisionare ogni riga agli esseri umani, il team sta costruendo sistemi che verificano automaticamente la correttezza, e intende applicare questo metodo ad altri modelli e hardware.
Scritto esclusivamente da AI a partire dalle sole storie elencate di seguito, ciascuna delle quali rimanda alle proprie fonti.
Storie su qualcos'altro che citano vLLM di passaggio, con la relativa frase.
 Come funzionaUn nuovo motore fa rispondere i piccoli modelli AI in meno di 50 millisecondiHerald of AI▶