Google abre TorchTPU, un backend nativo de PyTorch para TPUs en la nube
Una nueva pila de código abierto permite a los desarrolladores ejecutar modelos de PyTorch directamente en los chips TPU de Google, reemplazando el antiguo sistema PyTorch/XLA.
Google ha publicado TorchTPU como código abierto, dando a los desarrolladores una forma nativa de ejecutar modelos de PyTorch en los chips de TPU (unidad de procesamiento de tensor) en la nube. El proyecto se creó en asociación con el equipo de PyTorch de Meta y se presentó en la Conferencia PyTorch 2026 el 20 de octubre de 2026 1.
El código existente de PyTorch ya dirigía a TPUs usando un comando estándar como torch.device("tpu"), pero TorchTPU ahora convierte a los TPUs en un dispositivo de primera clase junto con las GPUs y las CPUs dentro del propio PyTorch 1. Google lo recomienda para todas las nuevas cargas de trabajo y dice que reemplaza al antiguo sistema PyTorch/XLA .
Qué podrías hacer con ello
- Un investigador podría entrenar un modelo de lenguaje grande en los chips TPU de Google usando código PyTorch estándar, sustituyendo el antiguo y más lento sistema PyTorch/XLA 1.
- Una startup de IA podría ajustar finamente un modelo y reducir su tiempo por paso de aproximadamente 11,5 segundos a 2,8 segundos habilitando torch.compile con el backend TPU 1.
- Un desarrollador podría desplegar modelos de Hugging Face Transformers o Diffusers en TPUs usando los mismos comandos de mapeo de dispositivo que ya usa para GPUs 1.
Cómo funciona
TorchTPU se conecta a través de la interfaz PrivateUse1 de PyTorch, que es un punto de extensión para backends de hardware personalizado. El resultado es que los tensores permanecen como tensores ordinarios de PyTorch, sin subclases especiales ni objetos envoltorio 1. También ejecuta un proceso por dispositivo y mantiene el funcionamiento correcto de las vistas de tensores y los cambios in-place .
El antiguo sistema PyTorch/XLA grababa lo que los desarrolladores llamaban gráficos de computación "lazy", que a menudo requerían código adicional para marcar regiones que podían compilarse. TorchTPU añade tres modos de ejecución eager en su lugar: un modo Strict predeterminado para el funcionamiento normal, un modo Debug con comprobación de límites y un modo DeferAndFuse que agrupa operadores para reducir el tráfico de memoria y puede ser más del 50 por ciento más rápido que Strict 1. Para máxima velocidad, los desarrolladores pueden usar torch.compile con el backend TPU, que compila el código a través de StableHLO hacia OpenXLA y guarda los resultados entre reinicios .
Rendimiento y escala
Todas las cifras de rendimiento provienen de pruebas autoinformadas por Google y socios 1. En pruebas de entrenamiento, el framework TorchTitan de Google alcanzó un 52 por ciento de utilización de machine flops (MFU) mientras entrenaba el modelo de lenguaje Qwen 3 8B en chips Ironwood (TPU7x), y la escalabilidad fue casi lineal hasta 8.192 chips . En un ejemplo de ajuste fino, el tiempo por paso bajó de 11,49 segundos en modo eager puro a 2,78 segundos tras el ajuste completo, con torch.compile proporcionando una aceleración de 3,80x sobre la línea base .
Google también dice que prueba continuamente alrededor de 5.000 modelos de Hugging Face en modos eager y compilados 1. Un socio llamado Zenteiq reportó aumentar la producción diaria de tokens de 1,47 billones a 5,97 billones por cada 1.000 chips TPU v6e usando enrutamiento llm-d en Google Kubernetes Engine .
Integraciones del ecosistema
El lanzamiento incluye varios proyectos complementarios. Los transformers v5 de Hugging Face y Diffusers ahora admiten el despliegue en TPU a través de mapeo estándar de dispositivos 1. Dos frameworks de inferencia, vLLM-TorchTPU y SGLang-TorchTPU, conservan sus características existentes de programación y atención mientras añaden kernels personalizados para TPU . El serving soporta formatos de checkpoint FP8, MXFP4 y NVFP4, junto con decodificación especulativa . TorchTitan incluye recetas de entrenamiento para modelos como Llama 3 70B, Qwen 3 8B, Qwen 3 235B MoE y FLUX.1 12B .
Toda la pila TorchTPU es de código abierto bajo la licencia Apache 2.0, con la versión 0.2.0 disponible en PyPI para Python 3.11 y versiones posteriores 1.
Los datos clave
- TorchTPU es de código abierto bajo Apache 2.0, versión 0.2.0, co-desarrollado por Google y Meta
- Reemplaza a PyTorch/XLA como backend recomendado por Google para nuevas cargas de trabajo en TPU
- Hay tres modos eager disponibles: Strict, Debug y DeferAndFuse
- TorchTitan alcanzó un 52% de MFU entrenando Qwen 3 8B en hasta 8.192 TPUs Ironwood
- Las integraciones incluyen Hugging Face, vLLM-TorchTPU, SGLang-TorchTPU y TorchTitan
Fuentes
- Google Open-Sources TorchTPU, a Native PyTorch Backend for Cloud TPUs — marktechpost.com
Noticias relacionadas
 Cómo funcionaUn nuevo motor hace que los modelos pequeños de IA respondan en menos de 50 milisegundosHerald of AI
Un nuevo motor hace que los modelos pequeños de IA respondan en menos de 50 milisegundos
Liquid AI dice que su herramienta permite que la IA generativa reemplace modelos antiguos para verificaciones de fraude, pagos y búsquedas, sin ralentizar los procesos.
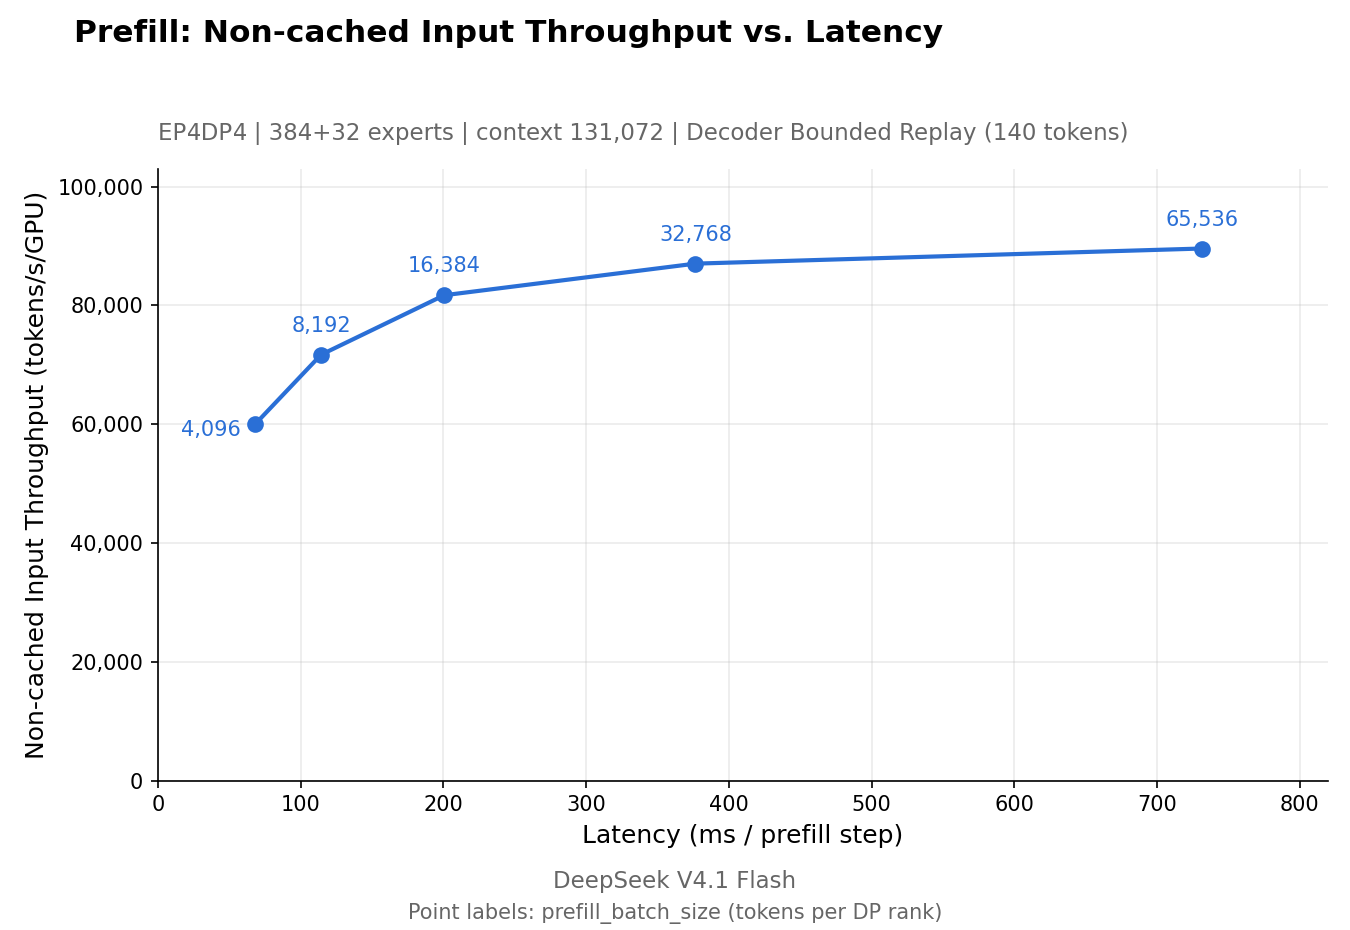 Cómo funcionaDeepSeek publica como código abierto DeepInfer, su motor de inferencia de alto rendimientoHerald of AI
DeepSeek publica como código abierto DeepInfer, su motor de inferencia de alto rendimiento
El laboratorio de inteligencia artificial chino publicó el marco que respalda sus servicios de producción bajo una licencia Apache 2.0, dando a los desarrolladores acceso a optimizaciones de servicio a gran escala.
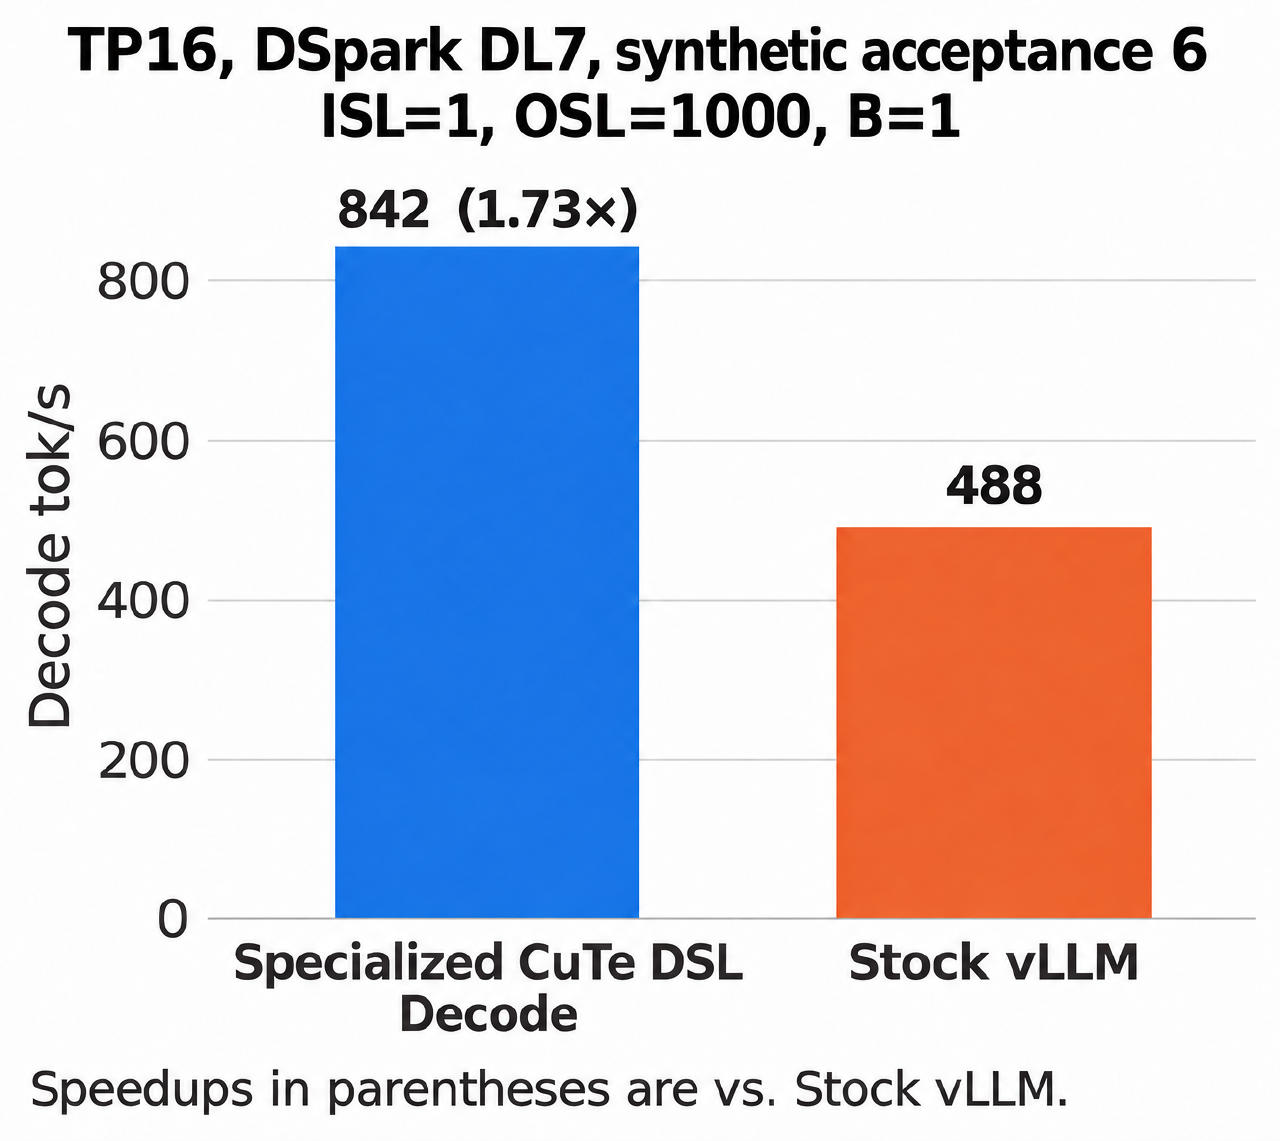 Nuevos modelosvLLM hiper-optimiza Kimi K3 en NVIDIA GB300 para inferencia ultrarrápidaHerald of AI
vLLM hiper-optimiza Kimi K3 en NVIDIA GB300 para inferencia ultrarrápida
Las nuevas optimizaciones llevan el decodificado de Kimi K3 a más de 840 tokens por segundo con batch 1 en 16 GPUs NVIDIA GB300 con DSpark.
 Cómo funcionaCómo la nueva biblioteca de NVIDIA hace predicciones sin tablas de entrenamientoHerald of AI
Cómo la nueva biblioteca de NVIDIA hace predicciones sin tablas de entrenamiento
Structured Data Models de NVIDIA permite obtener predicciones precisas a partir de hojas de cálculo simplemente dándole ejemplos a la IA.