DeepSeek publica como código abierto DeepInfer, su motor de inferencia de alto rendimiento
El laboratorio de inteligencia artificial chino publicó el marco que respalda sus servicios de producción bajo una licencia Apache 2.0, dando a los desarrolladores acceso a optimizaciones de servicio a gran escala.
Qué podrías hacer con ello
- Un desarrollador que construye una aplicación de chat con IA podría ejecutar DeepSeek V4.1 Flash localmente con optimizaciones de velocidad que DeepSeek mismo usa en producción, reduciendo los tiempos de respuesta sin depender de una API costosa 1.
- Un equipo de investigación podría imponer formatos de salida estrictos, como esquemas JSON o reglas de expresiones regulares, para que los datos generados por IA sean siempre estructuralmente consistentes y estén listos para procesos posteriores 1.
- Una empresa que ejecute inferencia en GPUs NVIDIA SM100 o NPUs Huawei Ascend 950 podría reemplazar su propio marco de servicio con DeepInfer, obteniendo programación asíncrona y decodificadores de predicción multi-token listos para usar 1.
Un motor de producción para todos
DeepSeek ha publicado como código abierto DeepInfer, el marco de inferencia que impulsa sus servicios de producción a gran escala. Publicado bajo la licencia Apache 2.0, DeepInfer le da a la comunidad de IA acceso directo a las optimizaciones que la compañía ha estado usando para servir sus modelos a gran escala.
El marco está diseñado para inferencia sin conexión, lo que significa que ejecuta modelos localmente en lugar de atender solicitudes de API en vivo, e incluye las funciones principales necesarias para un despliegue de nivel producción.
Qué incluye
DeepInfer soporta DeepSeek V4.1 Flash 1017 y cuenta con un conjunto de kernels optimizados que incluyen FlashMLA, DeepGEMM, DeepEP, TileKernels y kernels personalizados de TileLang 1. El sistema también incluye un decodificador de predicción multi-token basado en tokens borrador y un programador de verificación con programación por confianza que acelera la generación.
Capacidades técnicas clave incluyen:
- Programación asíncrona: Superpone la programación de lotes de CPU con la ejecución del dispositivo de forma predeterminada
- Inferencia independiente del lote: Mantiene los resultados del modelo idénticos independientemente de las composiciones del lote
- Muestreo determinista: Produce salidas idénticas para entradas idénticas cuando se proporciona una semilla fija
- Salidas estructuradas: Restringe la generación a reglas de expresiones regulares, esquema JSON o gramática EBNF
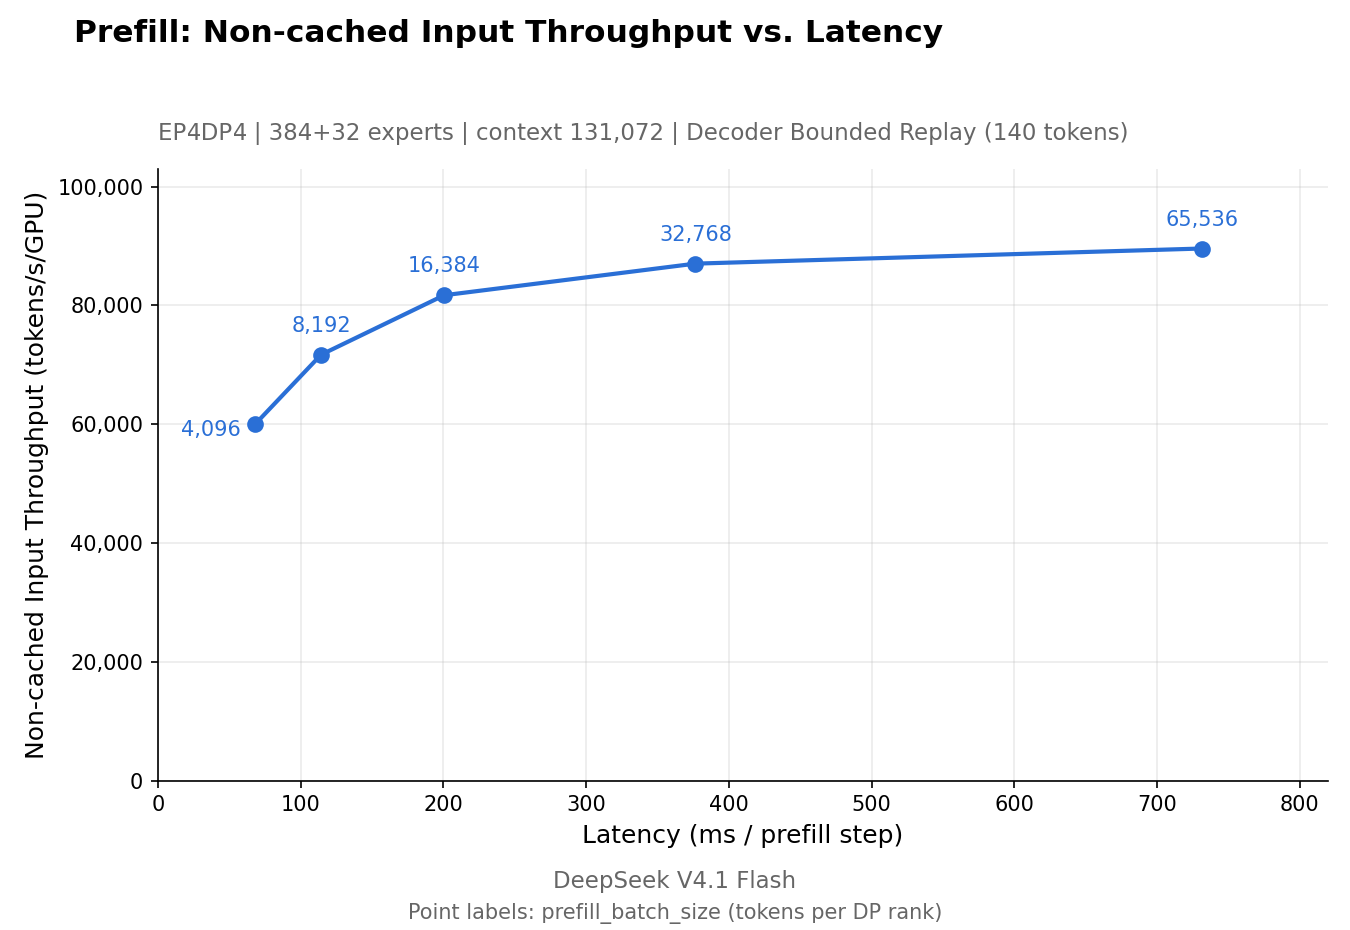
El marco también soporta un mecanismo de replay de atención de ventana deslizante del decodificador que reduce el trabajo de prefijado al replayar solo una cola acotada del contexto 1.
Hardware y configuración
DeepInfer funciona en GPUs SM100 de NVIDIA y NPUs Ascend 950 de Huawei. Requiere Linux con GCC 13 o posterior, Python 3.12 y ya sea CUDA 13 (para NVIDIA) o CANN 9.2 (para Ascend) 1.
El equipo explica que DeepInfer fue desarrollado inicialmente basándose principalmente en vLLM, y obtuvo mayor inspiración de SGLang y TensorRT-LLM. La desagregación de memoria caché KV, el balanceo de carga entre réplicas y otros componentes de infraestructura de servicio no están incluidos en este lanzamiento pero se señalan como requeridos para un servicio de inferencia completo 1.
Por qué importa
Publicar como código abierto la capa de inferencia es significativo. La mayoría de los laboratorios de IA publican modelos pero mantienen la infraestructura de servicio como privada. Al publicar DeepInfer, DeepSeek está haciendo que las optimizaciones que permiten un despliegue rápido y económico de sus modelos estén disponibles para toda la comunidad.
El lanzamiento incluye benchmarks de rendimiento medidos en clústeres de 4 GPUs SM100 para prefijado y 64 para decode, demostrando la escala para la cual el marco está diseñado para operar 1.
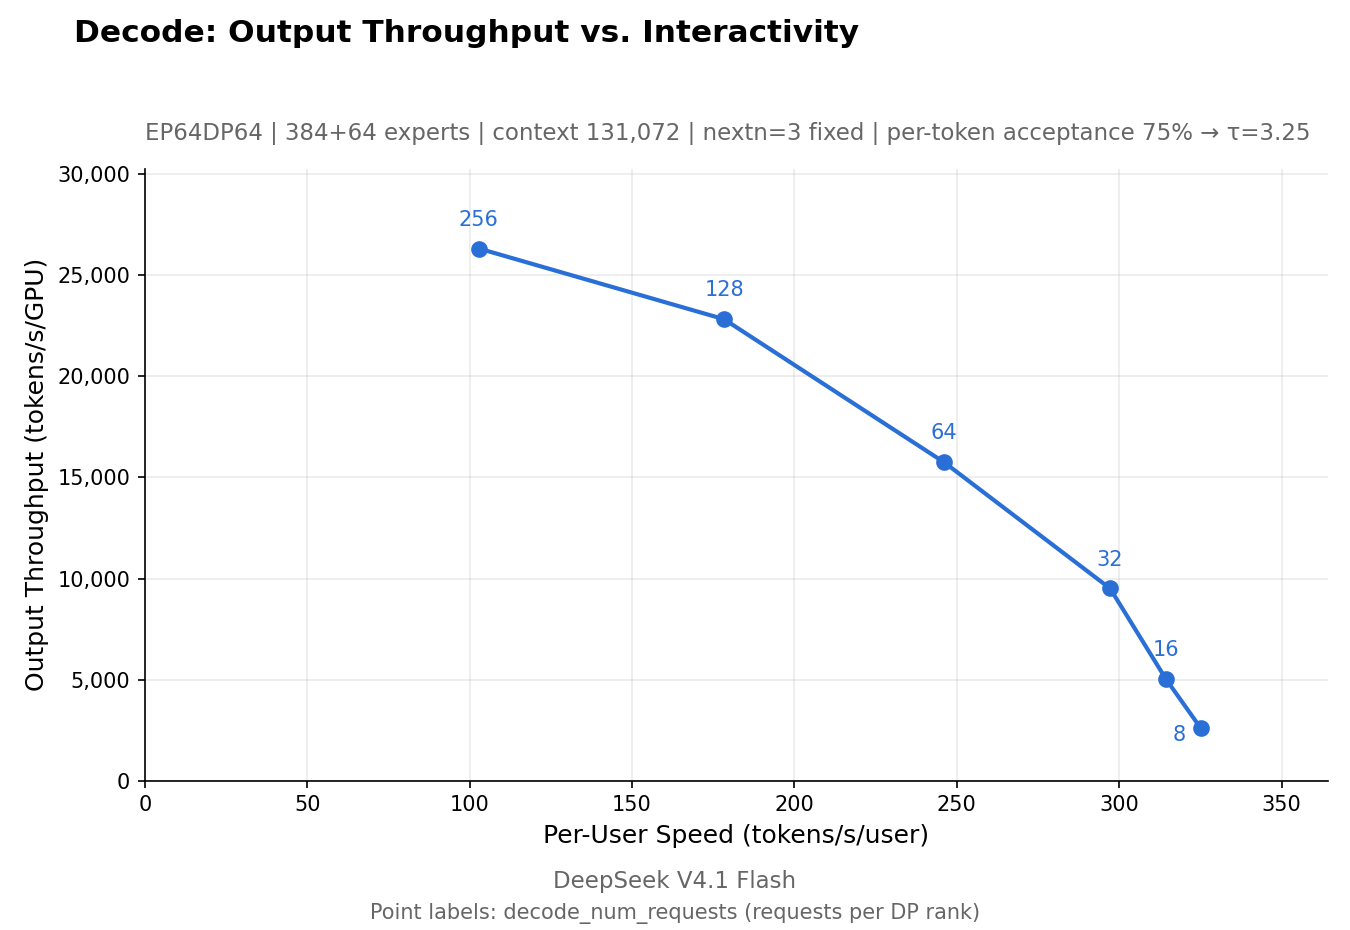
Imagen: github.com
Correcciones y actualizaciones
- Corrected on 23 de octubre de 2026. Una versión anterior decía que DeepInfer soporta DeepSeek V4.1 Flash 1017 y otros modelos de DeepSeek, pero la fuente solo enumera DeepSeek-V4.1-Flash como el modelo soportado y trata 1017 exclusivamente como el nombre del checkpoint por defecto. La afirmación correcta restringe el modelo específico a V4.1 Flash e identifica 1017 como el checkpoint.
Los datos clave
- DeepInfer se publica como código abierto bajo licencia Apache 2.0
- Soporta DeepSeek V4.1 Flash (específicamente el checkpoint DeepSeek-V4.1-Flash-1017)
- Funciona en GPUs SM100 de NVIDIA y NPUs Ascend 950 de Huawei
- Construido principalmente sobre vLLM con inspiración de SGLang y TensorRT-LLM
Fuentes
Noticias relacionadas
 Cómo funcionaUn nuevo motor hace que los modelos pequeños de IA respondan en menos de 50 milisegundosHerald of AI
Un nuevo motor hace que los modelos pequeños de IA respondan en menos de 50 milisegundos
Liquid AI dice que su herramienta permite que la IA generativa reemplace modelos antiguos para verificaciones de fraude, pagos y búsquedas, sin ralentizar los procesos.
 Nuevos modelosRecursive Releases Flint, a 40B Open-Weight Local Coding Model for AgentsHerald of AI
Recursive Releases Flint, a 40B Open-Weight Local Coding Model for Agents
Flint is Recursive Superintelligence's first model: a fast local coding agent running on consumer hardware.
 Nuevos modelosKumo Relational de NVIDIA supera al ML supervisado en datos relacionales sin entrenamientoHerald of AI
Kumo Relational de NVIDIA supera al ML supervisado en datos relacionales sin entrenamiento
Un nuevo modelo base preentrenado predice resultados directamente en bases de datos empresariales, sin necesidad de ingeniería de características ni entrenamiento específico para cada tarea.
 Cómo funcionaEl RL agéntico tiene una ley de escalamiento — y cambia cómo deberías gastar tu presupuestoHerald of AI
El RL agéntico tiene una ley de escalamiento — y cambia cómo deberías gastar tu presupuesto
Un nuevo estudio descubre que, en el aprendizaje por refuerzo agéntico, diversificar los mundos en los que entrena tu agente supera con creces generar más trayectorias — y la combinación adecuada puede rendir hasta 1,7× más eficiencia computacional.