Cómo la nueva biblioteca de NVIDIA hace predicciones sin tablas de entrenamiento
Structured Data Models de NVIDIA permite obtener predicciones precisas a partir de hojas de cálculo simplemente dándole ejemplos a la IA.
Una herramienta de una sola interfaz para datos tabulares
NVIDIA ha lanzado una nueva biblioteca llamada Structured Data Models que reúne modelos fundacionales preentrenados para datos estilo hoja de cálculo detrás de una única interfaz PyTorch. En lugar de pasar horas entrenando un modelo con tus propios datos, puedes entregarle al sistema un conjunto de ejemplos etiquetados y pedirle que prediga respuestas para filas nuevas de una sola vez.
La biblioteca engloba varios modelos: TabICLv2 para tareas de clasificación de tablas individuales, KumoTabular para regresión y clasificación tabulares, y KumoRelational para bases de datos completas con múltiples tablas vinculadas. Cada modelo utiliza una técnica llamada aprendizaje en contexto (in-context learning), en la que lee filas de ejemplo etiquetadas y luego produce probabilidades para las filas que quieres predecir. Obtienes distribuciones completas de predicción, no simples conjeturas.
Cómo funciona en la práctica
Para usar la biblioteca, le das dos cosas: un lote de filas que ya tienen respuestas conocidas, y las filas nuevas que quieres que prediga. El modelo procesa ambos juntos en una sola pasada y devuelve sus respuestas. También puedes reutilizar el mismo conjunto de ejemplos etiquetados en muchas consultas de predicción diferentes, lo que ahorra tiempo.
En las pruebas, los modelos preentrenados se compararon contra herramientas estándar de scikit-learn como boosting de gradiente y regresión logística. Los modelos de datos estructurados se mantuvieron razonablemente bien sin ningún entrenamiento, aunque no siempre superan a modelos construidos específicamente para una tarea. La biblioteca también maneja intervalos de predicción de regresión, que te dan un rango de valores probables en lugar de un número único 1.
Precaución con las trampas
El tutorial advierte sobre algunos problemas silenciosos. Una paso de preprocesamiento elimina automáticamente las columnas de marcas de tiempo y texto sin avisarte, lo cual podría quitar información útil de tus datos. Otro problema involucra a una herramienta de explicación con dos trampas conocidas que pueden dar resultados engañosos.
También hay un problema técnico al instalar la biblioteca. El sistema que maneja los datos relacionales necesita un paquete llamado pyg-lib, pero el mensaje de error que produce la biblioteca señala la página de descarga incorrecta. La solución es construir la URL correcta manualmente a partir de los números de versión mayor y menor, en lugar de seguir el consejo de la biblioteca.
Más allá de las tablas individuales
Una de las funciones más interesantes es la capacidad de trabajar con bases de datos relacionales completas. El tutorial demuestra construir una pequeña base de datos de tienda con tres tablas vinculadas y usar el modelo para predecir la actividad del cliente directamente a partir de los datos conectados. La diferencia clave entre un modelo relacional propio y uno defectuoso radica en si los datos de una tabla se filtran accidentalmente a las predicciones de otra, algo que la biblioteca maneja con cuidado cuando se usa correctamente 1.
El código completo del tutorial está disponible en GitHub, fijado a un commit específico para coincidir con la configuración probada.
Los datos clave
- La biblioteca Structured Data Models de NVIDIA no requiere entrenamiento para hacer predicciones
- Usa aprendizaje en contexto, donde los ejemplos etiquetados sirven como indicaciones
- La biblioteca engloba los modelos TabICLv2, KumoTabular y KumoRelational
- Un paso de preprocesamiento elimina silenciosamente las columnas de marcas de tiempo y texto por defecto
- La biblioteca puede predecir a partir de bases de datos relacionales completas, no solo tablas individuales
Fuentes
Noticias relacionadas
 Cómo funcionaUn nuevo motor hace que los modelos pequeños de IA respondan en menos de 50 milisegundosHerald of AI
Un nuevo motor hace que los modelos pequeños de IA respondan en menos de 50 milisegundos
Liquid AI dice que su herramienta permite que la IA generativa reemplace modelos antiguos para verificaciones de fraude, pagos y búsquedas, sin ralentizar los procesos.
 Nuevos modelosRecursive Releases Flint, a 40B Open-Weight Local Coding Model for AgentsHerald of AI
Recursive Releases Flint, a 40B Open-Weight Local Coding Model for Agents
Flint is Recursive Superintelligence's first model: a fast local coding agent running on consumer hardware.
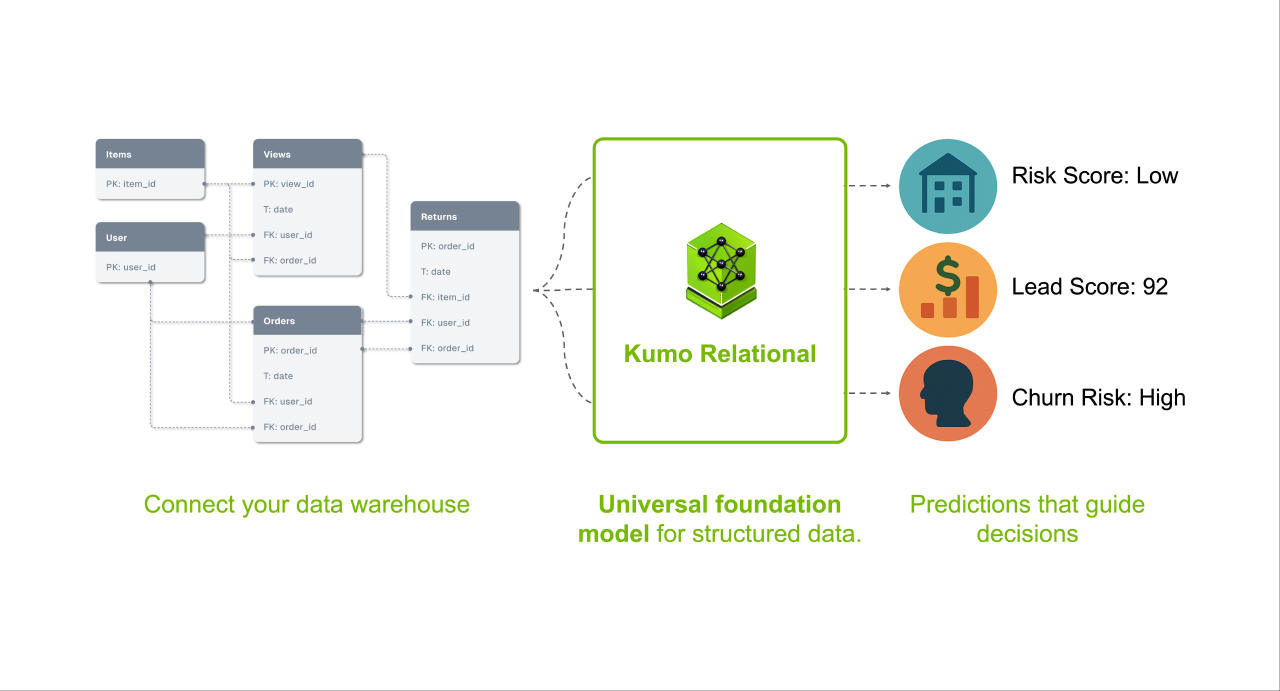 Nuevos modelosKumo Relational de NVIDIA supera al ML supervisado en datos relacionales sin entrenamientoHerald of AI
Kumo Relational de NVIDIA supera al ML supervisado en datos relacionales sin entrenamiento
Un nuevo modelo base preentrenado predice resultados directamente en bases de datos empresariales, sin necesidad de ingeniería de características ni entrenamiento específico para cada tarea.
 Cómo funcionaDeepSeek publica como código abierto DeepInfer, su motor de inferencia de alto rendimientoHerald of AI
DeepSeek publica como código abierto DeepInfer, su motor de inferencia de alto rendimiento
El laboratorio de inteligencia artificial chino publicó el marco que respalda sus servicios de producción bajo una licencia Apache 2.0, dando a los desarrolladores acceso a optimizaciones de servicio a gran escala.