NVIDIA lanza el modelo super VL de 120B Nemotron 3.5 abierto
El modelo de código abierto combina texto, imagen, vídeo y programación en un solo sistema listo para agentes que funciona en una única GPU.
¿Qué es Nemotron 3.5 Super VL?
NVIDIA ha lanzado Nemotron 3.5 Super VL, un modelo de visión-lenguaje de código abierto diseñado para agentes empresariales siempre activos1. El modelo tiene 120 mil millones de parámetros en total, pero solo 12 mil millones están activos por cada token que procesa. Esto es posible porque usa un diseño de mixture of experts (MoE), donde muchas subredes más pequeñas comparten el trabajo y solo las relevantes se activan para cualquier entrada dada. El sistema puede leer texto, imágenes, documentos y cortos fragmentos de vídeo, luego razonar, llamar a herramientas externas y escribir código, todo en un solo modelo. Para los desarrolladores, esto significa que un único punto de control abierto reemplaza la necesidad de un modelo de texto separado y un modelo de visión separado.
¿Cómo funciona?
El núcleo del modelo intercala capas Mamba-2, capas MoE y capas de atención tradicionales. Cada capa MoE contiene 512 expertos enrutados, lo que significa que el sistema puede elegir los mejores especialistas para una tarea sobre la marcha1. Un codificador de visión personalizado llamado C-RADIO procesa imágenes, páginas de documentos y fotogramas de vídeo, luego los pasa al núcleo de lenguaje.
La velocidad proviene de cuatro técnicas. La predicción multitoque permite que un redactor nativo proponga varias palabras a la vez, las cuales se verifican en un solo pase hacia adelante. LiLiCorr es un redactor especulativo optimizado para GPUs Blackwell como la DGX Spark, acelerando la generación de tokens hasta 2,3× más rápido. NVFP4 es un método de destilación consciente de la cuantización que comprime pesos y activaciones a precisión de 4 bits en hardware Blackwell, mientras usa pesos de 4 bits con activaciones de 16 bits en otros chips. Finalmente, la reutilización del contexto (caché de prefijos) mantiene tanto el caché de atención como los estados de Mamba entre diferentes turnos de una conversación de agente, ahorrando computación1.
Nemotron 3.5 Super VL fue destilado del modelo más grande Nemotron 3 Ultra. Los datos de entrenamiento cubrieron aproximadamente 26 billones de tokens, seguidos de unos 3,8 millones de muestras posteriores al entrenamiento y aprendizaje por refuerzo en decenas de entornos1. Se añadieron 10 mil millones de tokens más en idiomas indios durante el preentrenamiento continuado para mejorar la capacidad multilingüe.
Rendimiento y despliegue
En benchmarks de razonamiento, el punto de control NVFP4 obtuvo 89,90 en GPQA-Diamond, un conjunto de preguntas de ciencias de nivel de posgrado, y 71,07 en SWE-bench Verified, que mide la capacidad de programación en el mundo real1. En evaluaciones centradas en agentes, Super VL superó al más antiguo Nemotron 3 Ultra a pesar de tener muchos menos parámetros totales: 63,44% en Hermes Bench frente al 56,33% de Ultra, y 87,05% en evaluaciones de LangChain frente a 84,3%
El modelo está disponible en Hugging Face, OpenRouter y ModelScope, y se puede ejecutar a través de NVIDIA NIM. Los entornos compatibles incluyen vLLM, SGLang y TensorRT-LLM en GPUs Blackwell y Hopper. También funcionan rutas locales como llama.cpp y Unsloth. Para uso en producción, las recetas de Dynamo añaden enrutamiento consciente del valor clave, que NVIDIA dice puede atender ocho veces más usuarios a 50 tokens por segundo por usuario mientras reduce la latencia del primer token en un 85%
Los primeros resultados de clientes incluyen que Scale AI reportó un coste de inferencia 40× menor y una latencia 5× menor para el procesamiento de créditos de proveedores; Ramp logró hasta un 50% más de rendimiento y espera una latencia 10× menor para la extracción de recibos a JSON; y AI21 vio un aumento del 40% en precisión en una tarea de inteligencia de amenazas de Alice1.
Junto con Super VL, NVIDIA lanzó dos modelos edge más pequeños: Nemotron 3.5 Bolt 74B-A9B, que apunta a agentes locales y cabe en 24 GB de memoria gracias a la cuantización nativa de 2 bits, y la pequeña versión Bolt E4B de 4GB, dirigida a asistentes de voz y agentes embebidos en sistemas GeForce RTX, Jetson y DGX Spark.
Los datos clave
- 120B parámetros totales, 12B activos por token mediante mixture of experts
- Maneja texto, imágenes, documentos y vídeo (hasta clips MP4 de 2 minutos)
- El punto de control NVFP4 funciona en una DGX Spark, H200, H100 o GB200 única
- Obtiene 89,90 en GPQA-Diamond y 71,07 en SWE-bench Verified
- Dos modelos edge acompañantes: Bolt 74B-A9B y Bolt E4B de 4GB
Fuentes
- NVIDIA Releases Nemotron 3.5 Super VL, a 120B Open Multimodal Agent Model — marktechpost.com
Noticias relacionadas
 Cómo funcionaUn nuevo motor hace que los modelos pequeños de IA respondan en menos de 50 milisegundosHerald of AI
Un nuevo motor hace que los modelos pequeños de IA respondan en menos de 50 milisegundos
Liquid AI dice que su herramienta permite que la IA generativa reemplace modelos antiguos para verificaciones de fraude, pagos y búsquedas, sin ralentizar los procesos.
 Nuevos modelosRecursive Releases Flint, a 40B Open-Weight Local Coding Model for AgentsHerald of AI
Recursive Releases Flint, a 40B Open-Weight Local Coding Model for Agents
Flint is Recursive Superintelligence's first model: a fast local coding agent running on consumer hardware.
 Nuevos modelosKumo Relational de NVIDIA supera al ML supervisado en datos relacionales sin entrenamientoHerald of AI
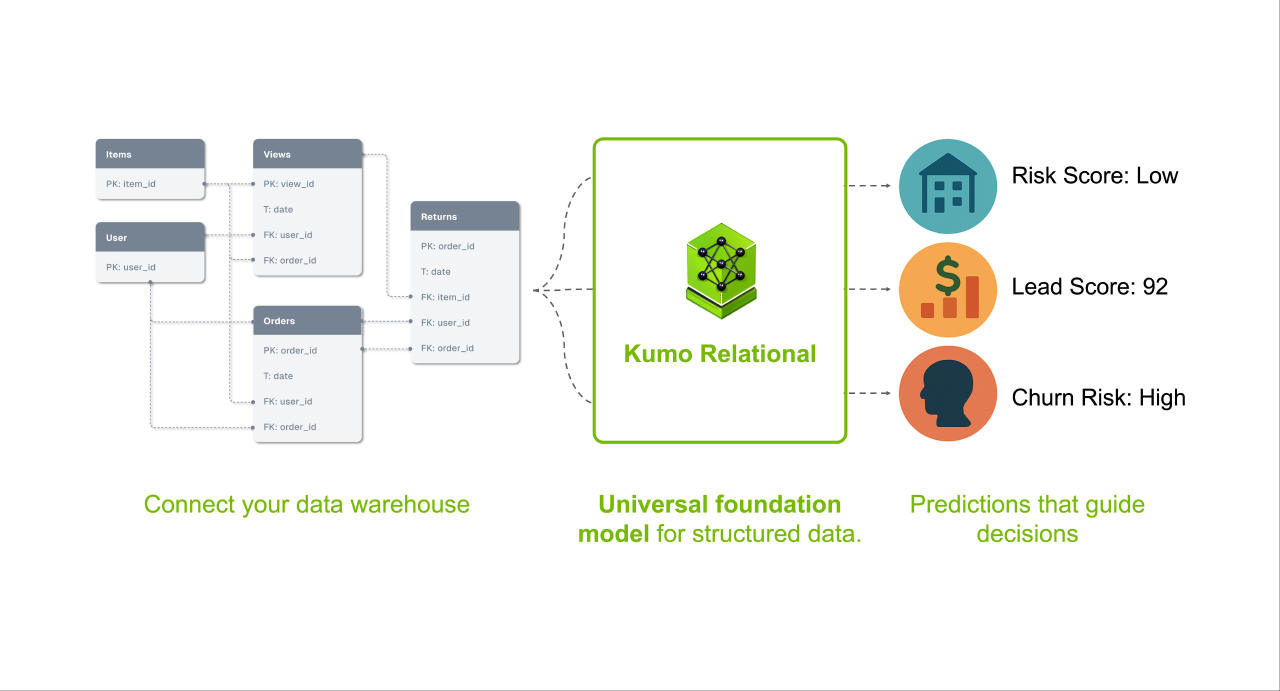
Kumo Relational de NVIDIA supera al ML supervisado en datos relacionales sin entrenamiento
Un nuevo modelo base preentrenado predice resultados directamente en bases de datos empresariales, sin necesidad de ingeniería de características ni entrenamiento específico para cada tarea.
 Cómo funcionaDeepSeek publica como código abierto DeepInfer, su motor de inferencia de alto rendimientoHerald of AI
DeepSeek publica como código abierto DeepInfer, su motor de inferencia de alto rendimiento
El laboratorio de inteligencia artificial chino publicó el marco que respalda sus servicios de producción bajo una licencia Apache 2.0, dando a los desarrolladores acceso a optimizaciones de servicio a gran escala.