NVIDIA rilascia il modello open-source Nemotron 3.5 Super VL da 120B
Il modello open-source unisce testo, immagini, video e codice in un unico sistema pronto per agent, che gira su una singola GPU.
Cos'è Nemotron 3.5 Super VL?
NVIDIA ha rilasciato Nemotron 3.5 Super VL, un modello vision-language open-source pensato per agent aziendali sempre attivi1. Il modello ha 120 miliardi di parametri in totale, ma solo 12 miliardi sono attivi per ogni token che elabora. Questo è possibile grazie al design a mixture of experts (MoE), in cui molti sottomodelli più piccoli condividono il lavoro e solo quelli rilevanti si attivano per un dato input. Il sistema può leggere testo, immagini, documenti e brevi clip video, poi ragionare, chiamare strumenti esterni e scrivere codice — il tutto in un unico modello. Per gli sviluppatori, questo significa che un singolo checkpoint open-source sostituisce la necessità di un modello di testo separato e un modello di visione separato.
Come funziona?
Il nucleo del modello alterna strati Mamba-2, strati MoE e strati di attenzione tradizionali. Ogni strato MoE contiene 512 esperti instradati, il che significa che il sistema può scegliere i migliori specialisti per un compito in tempo reale1. Un encoder visivo personalizzato chiamato C-RADIO elabora immagini, pagine di documenti e frame video, poi li passa al nucleo linguistico.
La velocità deriva da quattro tecniche. La multi-token prediction permette a un draft di base di proporre più parole contemporaneamente, verificate in un singolo forward pass. LiLiCorr è un draft speculativo ottimizzato per le GPU Blackwell come DGX Spark, che accelera la generazione di token fino a 2,3×. NVFP4 è un metodo di distillazione aware della quantizzazione che comprime pesi e attivazioni a precisione 4-bit sull'hardware Blackwell, mentre utilizza pesi 4-bit con attivazioni 16-bit su altri chip. Infine, il riuso del contesto (prefix caching) mantiene sia la cache di attenzione sia gli stati Mamba tra i diversi turni di una conversazione agent, risparmiando computazione1.
Nemotron 3.5 Super VL è stato distillato dal modello più grande Nemotron 3 Ultra. I dati di addestramento coprivano circa 26 trilioni di token, seguiti da circa 3,8 milioni di campioni post-addestramento e reinforcement learning in decine di ambienti1. Un ulteriore aggiunto di 10 miliardi di token in lingue indiche è stato inserito durante il pre-addestramento continuato per migliorare le capacità multilingua.
Performance e deploy
Sui benchmark di ragionamento, il checkpoint NVFP4 ha segnato 89,90 su GPQA-Diamond, un set di domande di scienze a livello di laurea, e 71,07 su SWE-bench Verified, che misura abilità di coding nel mondo reale1. Nelle valutazioni orientate agli agent, Super VL ha superato il più vecchio Nemotron 3 Ultra nonostante avesse molti meno parametri totali: 63,44% su Hermes Bench contro il 56,33% di Ultra, e 87,05% su LangChain evals contro l'84,3%
Il modello è disponibile su Hugging Face, OpenRouter e ModelScope, e può essere eseguito tramite NVIDIA NIM. I runtime supportati includono vLLM, SGLang e TensorRT-LLM su GPU Blackwell e Hopper. Funzionano anche percorsi locali come llama.cpp e Unsloth. Per uso in produzione, le ricette Dynamo aggiungono un instradamento aware di chiave-valore, che secondo NVIDIA può servire otto volte più utenti a 50 token al secondo per utente, riducendo la latenza del primo token dell'85%
I primi risultati dei clienti includono Scale AI che segnala costi di inferenza 40× inferiori e latenza 5× inferiore per l'elaborazione dei crediti vendor; Ramp che ha ottenuto fino al 50% in più di throughput e si aspetta una latenza 10× inferiore per l'estrazione receipt-to-JSON; e AI21 che ha visto un miglioramento del 40% di accuratezza su un compito di threat intelligence Alice1.
Accanto a Super VL, NVIDIA ha rilasciato due modelli edge più piccoli: Nemotron 3.5 Bolt 74B-A9B, che punta agli agent locali e entra in 24 GB di memoria grazie alla quantizzazione nativa 2-bit, e la piccola versione Bolt E4B 4GB, destinata ad assistenti vocali e agent incorporati su sistemi GeForce RTX, Jetson e DGX Spark.
I fatti principali
- 120B parametri totali, 12B attivi per token tramite mixture of experts
- Gestisce testo, immagini, documenti e video (fino a clip MP4 da 2 minuti)
- Il checkpoint NVFP4 gira su un singolo DGX Spark, H200, H100 o GB200
- Punteggi 89,90 su GPQA-Diamond e 71,07 su SWE-bench Verified
- Due modelli edge complementari: Bolt 74B-A9B e Bolt E4B 4GB
Fonti
- NVIDIA Releases Nemotron 3.5 Super VL, a 120B Open Multimodal Agent Model — marktechpost.com
Notizie collegate
 Come funzionaUn nuovo motore permette ai modelli AI piccoli di rispondere in meno di 50 millisecondiHerald of AI
Un nuovo motore permette ai modelli AI piccoli di rispondere in meno di 50 millisecondi
Liquid AI afferma che il suo strumento permette all'AI generativa di sostituire vecchi modelli per i controlli antifrode, i pagamenti e la ricerca — senza rallentare le operazioni.
 Nuovi modelliRecursive Releases Flint, a 40B Open-Weight Local Coding Model for AgentsHerald of AI
Recursive Releases Flint, a 40B Open-Weight Local Coding Model for Agents
Flint è il primo modello di Recursive Superintelligence: un agente di codifica locale veloce che gira su hardware consumer.
 Nuovi modelliNVIDIA Kumo Relational batte il ML supervisionato sui dati relazionali senza trainingHerald of AI
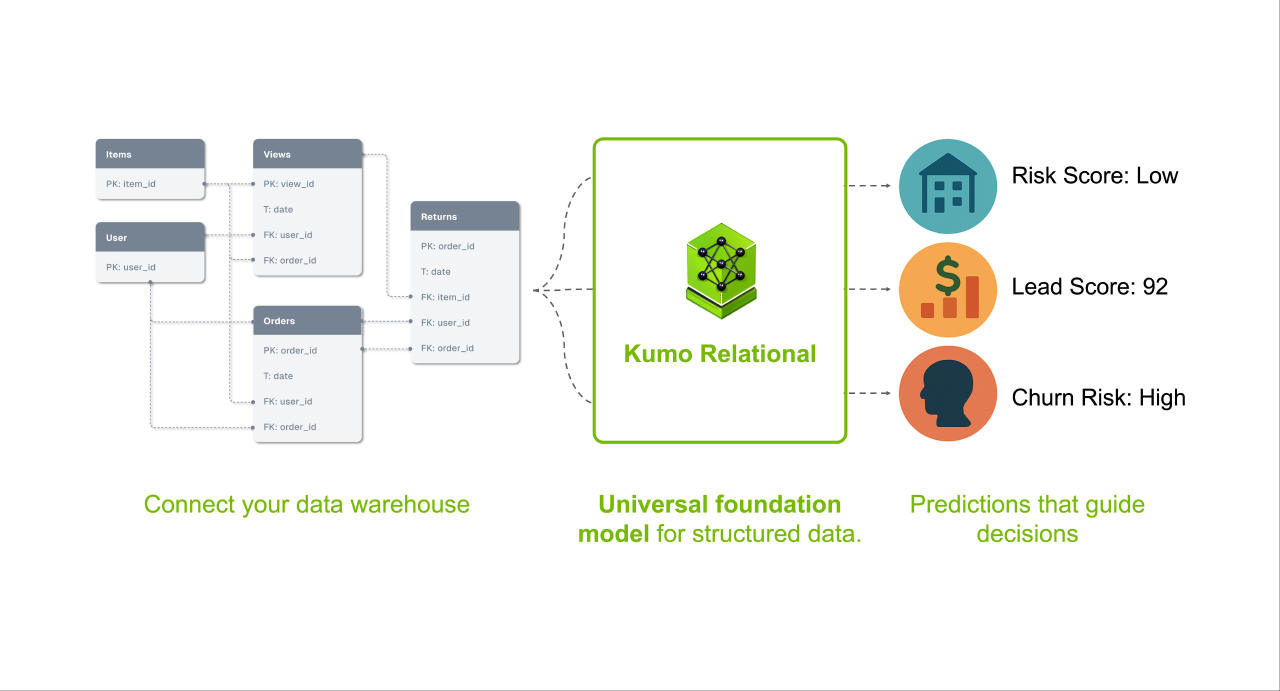
NVIDIA Kumo Relational batte il ML supervisionato sui dati relazionali senza training
Un nuovo modello base pre-addestrato prevede risultati direttamente sui database enterprise, senza bisogno di feature engineering o training specifico per task.
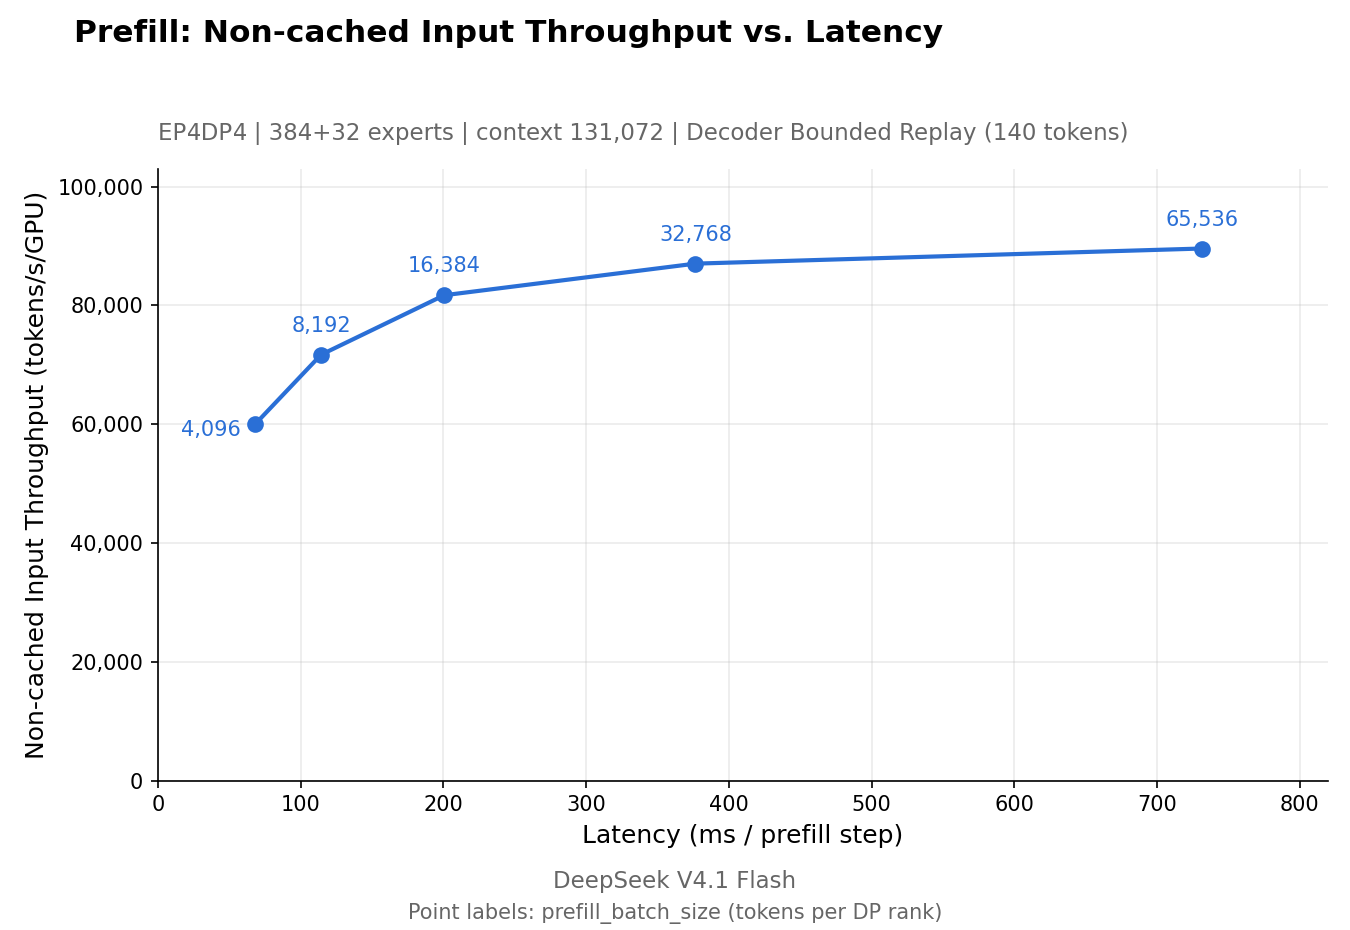 Come funzionaDeepSeek rende open-source DeepInfer, il suo motore di inferenza ad alte prestazioniHerald of AI
DeepSeek rende open-source DeepInfer, il suo motore di inferenza ad alte prestazioni
Il laboratorio di intelligenza artificiale cinese ha rilasciato il framework alla base dei suoi servizi di produzione sotto licenza Apache 2.0, mettendone a disposizione dei developer le ottimizzazioni per il servizio su larga scala.