NVIDIA Kumo Relational batte il ML supervisionato sui dati relazionali senza training
Un nuovo modello base pre-addestrato prevede risultati direttamente sui database enterprise, senza bisogno di feature engineering o training specifico per task.
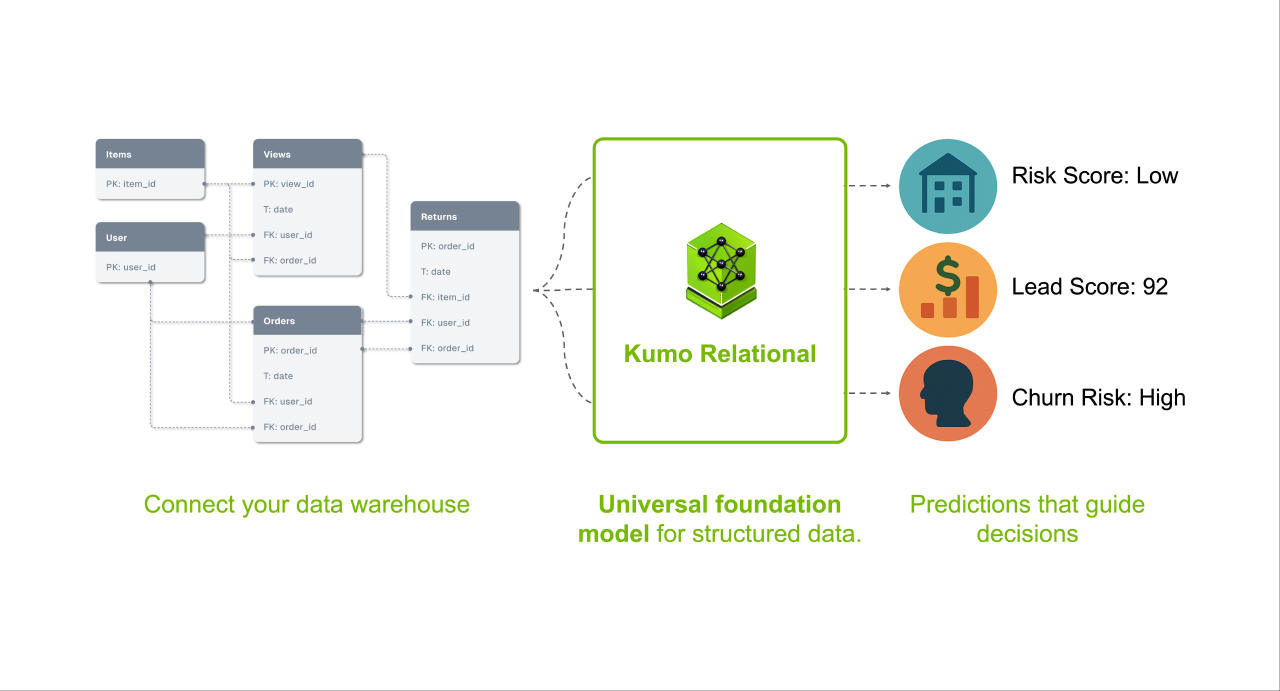
Un nuovo modello per le previsioni sui database
NVIDIA ha rilasciato Kumo Relational, un modello base pre-addestrato progettato per funzionare direttamente con i database relazionali. Invece di richiedere settimane di feature engineering e regolazione dei modelli per ogni nuovo task, il modello può generare previsioni in un unico passaggio dopo che un utente descrive cosa vuole prevedere 1.
Il sistema recupera fino a 10.000 esempi storici da un database come contesto per qualsiasi query, poi outputta previsioni per esiti come l'abbandono clienti, la domanda di prodotto o le frodi in un solo forward pass 1. È disponibile come modello open-source attraverso la libreria GPU-native structured-data-models di NVIDIA e come endpoint NVIDIA NIM .
Come funziona
La maggior parte dei modelli base esistenti per i dati strutturati opera su singole tabelle piatte. Kumo Relational rispetta invece la struttura effettiva dei database relazionali, lavorando con tabelle, chiavi esterne e timestamp senza appiattirle in una singola riga larga 1.
Il modello usa in-context learning, cioè impara dagli esempi di contesto che raccoglie al momento della previsione invece di fare affidamento su un training specifico per task 1. Applica meccanismi di graph attention per ragionare all'interno delle singole tabelle e tra tabelle simultaneamente, collegando i record attraverso le relazioni già definite nello schema del database .
Per i task di previsione basati sul tempo, il sistema riproduce gli stati storici del database e campiona sottofigli centrati sulle entità attorno ai record oggetto di analisi 1. Un Predictive Query Language integrato permette agli utenti di esprimere cosa prevedere in termini naturali invece di scrivere codice complesso di trasformazione dei dati .
Benchmark di prestazioni
Nei test che coprono 41 task estratti da 15 database, Kumo Relational ha battuto sia i modelli supervised relational deep learning che le pipeline expert-built gradient-boosted tree 1. Sui task classification RelBench V1, ha battuto gli gradient-boosted tree con features hand-engineered di quasi quattro punti AUROC in media .
Sul benchmark enterprise SAP SALT, Kumo Relational ha superato gli AutoGluon ensembles di otto punti percentuali in mean reciprocal rank out of the box, e di 13 punti dopo fine-tuning 1. Il modello è progettato per scalare orizzontalmente e gestire database contenenti oltre 500 miliardi di righe .
I ricercatori di NVIDIA hanno sviluppato il modello e pubblicato i loro risultati su arXiv 1.
I fatti principali
- Kumo Relational è un modello base pre-addestrato che prevede direttamente sui database relazionali senza training specifico per task
- Raccoglie fino a 10.000 esempi storici di contesto al momento dell'inference e usa in-context learning
- Supera il deep learning supervisionato e le pipeline gradient-boosted tree su 41 task su 15 database
- Sul benchmark SAP SALT batte gli AutoGluon ensembles dell'8% in mean reciprocal rank senza fine-tuning
- Scala a database con oltre 500 miliardi di righe ed è disponibile come software open-source e tramite NVIDIA NIM
{"title": "the headline", "summary": "the standfirst", "caption": "the picture caption, or empty", "body": "the story, in Markdown"}
Fonti
Notizie collegate
 Come funzionaUn nuovo motore permette ai modelli AI piccoli di rispondere in meno di 50 millisecondiHerald of AI
Un nuovo motore permette ai modelli AI piccoli di rispondere in meno di 50 millisecondi
Liquid AI afferma che il suo strumento permette all'AI generativa di sostituire vecchi modelli per i controlli antifrode, i pagamenti e la ricerca — senza rallentare le operazioni.
 Nuovi modelliRecursive Releases Flint, a 40B Open-Weight Local Coding Model for AgentsHerald of AI
Recursive Releases Flint, a 40B Open-Weight Local Coding Model for Agents
Flint è il primo modello di Recursive Superintelligence: un agente di codifica locale veloce che gira su hardware consumer.
 Come funzionaDeepSeek rende open-source DeepInfer, il suo motore di inferenza ad alte prestazioniHerald of AI
DeepSeek rende open-source DeepInfer, il suo motore di inferenza ad alte prestazioni
Il laboratorio di intelligenza artificiale cinese ha rilasciato il framework alla base dei suoi servizi di produzione sotto licenza Apache 2.0, mettendone a disposizione dei developer le ottimizzazioni per il servizio su larga scala.
 Nuovi modellivLLM Hyper-Optimizza Kimi K3 su NVIDIA GB300 per Inferenza RapidissimaHerald of AI
vLLM Hyper-Optimizza Kimi K3 su NVIDIA GB300 per Inferenza Rapidissima
Nuove ottimizzazioni spingono il decoding di Kimi K3 oltre 840 token al secondo con batch 1 su 16 GPU NVIDIA GB300 con DSpark.