Block presenta Dessa, una IA de voz que aprende solo escuchando hablar a los humanos
Una nueva IA de Block que habla y escucha al mismo tiempo: fue entrenada solo con habla humana, no con texto.
Cómo funciona
Una IA de voz que escucha y habla a la vez, entrenada solo con audio de conversaciones humanas, no con texto.
- Hablas de forma natural con la IA
- Escucha mientras sigues hablando
- Interviene, se ríe o reacciona en tiempo real
- Funciona directamente en tu portátil, de forma local
Qué podrías hacer con ella
- Un desarrollador podría ejecutar conversaciones de voz full-duplex localmente en un MacBook Pro con chip M4 Max, a velocidades más rápidas que el tiempo real 1.
- Un investigador podría explorar cómo un modelo solo de habla aprende nuevos idiomas y realiza aprendizaje en contexto, ya que la página del proyecto de Block invita a preguntas sobre ambos temas 2.
- Un usuario podría tener una conversación realista y emocional de ida y vuelta con una IA que escucha y habla al mismo tiempo, usando señales como risas, suspiros e interrupciones 2.
Adivina
¿Puede Dessa escuchar y hablar al mismo tiempo?
Dessa puede escuchar y hablar simultáneamente, como una persona real que te interrumpe o asiente.
Un ejemploInventado para explicarlo
Maya practicando una conversación sola en casa
MayaOye, ¿has oído esa noticia loca de hoy?
DessaEspera, cuéntame: ¿qué pasó?
Maya¡Mi amigo acaba de ser aceptado en ese programa!
Dessa¡Madre mía, es increíble!
Maya¿Verdad? Estoy muy feliz por ellos.
DessaSí, ¡totalmente! Qué buena noticia.
Maya se fue con la sensación de haber tenido una conversación natural de vaivén con una IA.
Cómo se diferencia Dessa
La mayoría de los sistemas de IA de voz actuales funcionan en tres etapas: convierten tu voz a texto, pasan el texto por un modelo de lenguaje y luego devuelven la respuesta a habla 1. Block dice que esa cadena desecha la emoción, el sarcasmo, las risas y los suspiros: las cosas que hacen que una conversación se sienta humana 2.
Dessa toma un camino diferente. Va directamente del sonido al sonido. Block la entrenó desde cero solo con grabaciones de personas hablando entre sí 2. Sin texto. Sin modelos preentrenados. «Creemos que la voz es la forma más natural de interactuar con la inteligencia», escribió la empresa en la página del proyecto .
Dessa es full-duplex, lo que significa que puede escuchar y hablar al mismo tiempo. Las personas reales hacen esto todo el tiempo: asienten con un rápido «sí» mientras otra persona aún está hablando, o intervienen antes de que la otra termine una oración. La mayoría de las IA de voz actuales no pueden hacer eso; esperan a que pares para responder 3. Block dice que Dessa aprendió cuándo intervenir y cuándo dar señales de escucha simplemente escuchando conversaciones reales 12.
Lo que muestran las demostraciones
Block compartió varias grabaciones en vivo de personas hablando con Dessa. En una, se ríe a mitad de una oración: algo que la empresa dice que otros modelos solo hacen cuando se les indica después de que terminas de hablar 2. En otra, exclama «oh my god» sorprendida y suena agradecida con lágrimas . Cuando se le pide que hable más fuerte, se hace más alta . Un clip incluso muestra a Dessa hablando con el GPT-Live-1 de OpenAI 1. Nadie guió ninguno de los clips, dice Block .
¿Qué tan eficiente es?
1 Según Block, Dessa adquirió el lenguaje usando cientos de veces menos palabras que lo que requieren los modelos grandes de IA basados en texto. La empresa la entrenó en un solo rack NVIDIA GB200 NVL72: 72 GPUs Blackwell enlazadas con 36 CPUs Grace, muchos menos chips que los modelos rivales full-duplex . Para comparar, Moshi de Kyutai, otro modelo full-duplex abierto, usó 1.016 GPUs H100 y 7 millones de horas de audio de preentrenamiento 3.
Dessa puede ejecutarse localmente en un MacBook Pro con chip M4 Max o mejor, a velocidades más rápidas que el tiempo real 1.
Lo que aún no sabemos
A pesar de las demostraciones, Block no ha compartido varios detalles clave: sin puntuaciones de benchmarks, sin conteo de parámetros, sin pesos del modelo, sin paper de investigación, sin API y sin precio 1. El acceso es actualmente una vista previa de investigación solo por lista de espera . El modelo se anunció el 23 de octubre de 2026 .
Qué tan buena es
Block ha publicado cero puntuaciones de benchmarks, sin conteo de parámetros y sin pesos del modelo para Dessa, por lo que no hay resultados de pruebas independientes para evaluar 1. La empresa compartió grabaciones en vivo de demostraciones que muestran risas naturales, interrupciones a mitad de oración y reacciones expresivas, pero estas no fueron comparadas contra modelos rivales . Según Block, Dessa aprendió el lenguaje usando cientos de veces menos palabras que los modelos grandes de IA basados en texto, aunque esta afirmación no ha sido verificada de forma independiente . Rivales como Moshi y GPT-Live-1 han publicado números de latencia, pero las métricas de rendimiento de Dessa permanecen sin revelar .
Los datos clave
- Dessa es una IA speech-to-speech full-duplex entrenada solo con audio de conversaciones humanas
- Block la entrenó en 1 rack NVIDIA GB200 NVL72 (72 GPUs); el rival Moshi usó 1.016 H100
- Se ejecuta localmente en un MacBook Pro M4 Max o mejor, más rápido que el tiempo real
- No se han publicado puntuaciones de benchmarks, pesos, paper, API ni precio
- El acceso es una vista previa de investigación solo por lista de espera anunciada el 23 de octubre de 2026
Fuentes
Sigue leyendo
 La semanaEsta semana en IA: llegan nuevos modelos y los agentes se vuelven más segurosHerald of AILa semana
Esta semana en IA: llegan nuevos modelos y los agentes se vuelven más seguros
Grandes lanzamientos de pesos abiertos, avances de velocidad y un impulso para hacer que los agentes de IA sean más confiables y seguros.
 Cómo funcionaNVIDIA abre el código fuente de Run:ai para la gestión de GPUs en KubernetesHerald of AI
 Cómo funcionaLiquid AI abre los modelos de decisión d1 para elecciones de IA en tiempo real y en el edgeHerald of AI
 Nuevos modelosRecursive lanza Flint, un modelo de codificación local de 40B y pesos abiertos para agentesHerald of AI
Noticias relacionadas
 Cómo funcionaUn nuevo motor hace que los modelos pequeños de IA respondan en menos de 50 milisegundosHerald of AI▶
Un nuevo motor hace que los modelos pequeños de IA respondan en menos de 50 milisegundos
Liquid AI dice que su herramienta permite que la IA generativa reemplace modelos antiguos para verificaciones de fraude, pagos y búsquedas, sin ralentizar los procesos.
 Nuevos modelosKumo Relational de NVIDIA supera al ML supervisado en datos relacionales sin entrenamientoHerald of AI
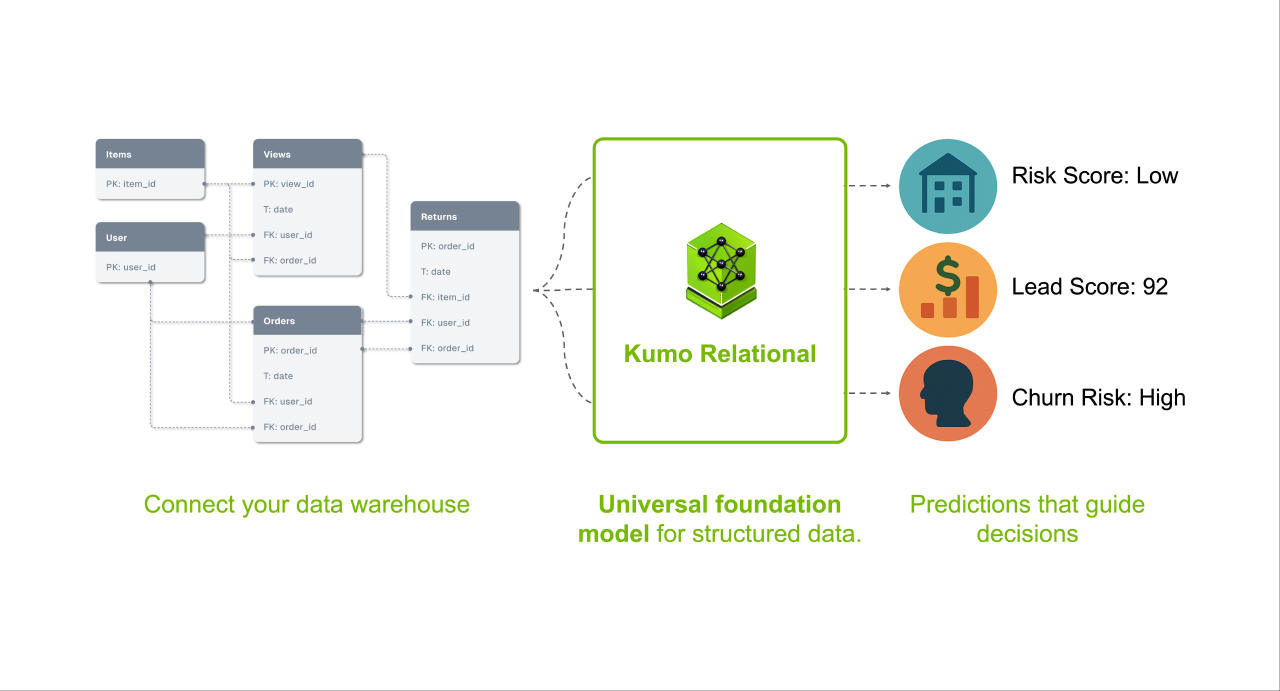
Kumo Relational de NVIDIA supera al ML supervisado en datos relacionales sin entrenamiento
Un nuevo modelo base preentrenado predice resultados directamente en bases de datos empresariales, sin necesidad de ingeniería de características ni entrenamiento específico para cada tarea.
 La semanaEsta semana en herramientas de IA agéntica, modelos más baratos y dolores de crecimientoHerald of AI
Esta semana en herramientas de IA agéntica, modelos más baratos y dolores de crecimiento
OpenAI informa sobre la adopción de herramientas agénticas en la UE, nuevos modelos alcanzan salidas de un millón de tokens, y los desarrolladores luchan con código más rápido pero opaco.
 Cómo funcionaDeepSeek publica como código abierto DeepInfer, su motor de inferencia de alto rendimientoHerald of AI
DeepSeek publica como código abierto DeepInfer, su motor de inferencia de alto rendimiento
El laboratorio de inteligencia artificial chino publicó el marco que respalda sus servicios de producción bajo una licencia Apache 2.0, dando a los desarrolladores acceso a optimizaciones de servicio a gran escala.