Block presenta Dessa, un'AI vocale che impara solo ascoltando gli umani parlare
Una nuova AI di Block parla e ascolta nello stesso momento — ed è stata addestrata solo su linguaggio umano, non su testo.
Come funziona
Un'AI vocale che ascolta e parla nello stesso momento, addestrata solo con audio di conversazioni umane, non su testo.
- Tu parli in modo naturale all'AI
- Lei ascolta mentre stai ancora parlando
- Interviene, ride o reagisce in tempo reale
- Gira direttamente sul tuo portatile, in locale
Cosa ci si può fare
- Uno sviluppatore potrebbe eseguire conversazioni vocali full-duplex in locale su un MacBook Pro con chip M4 Max, a velocità superiori al tempo reale 1.
- Un ricercatore potrebbe esplorare come un modello solo vocale impara nuove lingue e performa nel learning in-context, visto che la pagina del progetto Block invita domande su entrambi gli aspetti 2.
- Un utente potrebbe avere una conversazione realistica ed emotiva a due vie con un'AI che ascolta e parla allo stesso tempo, usando segnali come risate, sospiri e interruzioni 2.
Indovina
Dessa può ascoltare e parlare allo stesso tempo?
Dessa può ascoltare e parlare simultaneamente, come una persona reale che interrompe o annuisce.
Un esempioInventato per spiegare
Maya che pratica una conversazione da sola a casa
MayaEhi, hai sentito quella notizia folle di oggi?
DessaNo, aspetta, dimmi — cosa è successo?
MayaIl mio amico è stato appena ammesso a quel programma!
DessaOddio, è fantastico!
MayaGiusto? Sono così felice per lui.
DessaSì, assolutamente! Che bella notizia.
Maya se n'è andata con la sensazione di aver avuto una conversazione naturale in uno scambio con un'AI.
Come Dessa è diversa
La maggior parte dei sistemi vocali AI oggi funziona in tre fasi: trasformano la tua voce in testo, elaborano il testo con un modello linguistico, poi riscrivono la risposta in parlato 1. Block dice che questa catena elimina emozione, sarcasmo, risate e sospiri — le cose che rendono una conversazione umana 2.
Dessa segue un percorso diverso. Va direttamente dal suono al suono. Block l'ha addestrata da zero solo su registrazioni di persone che parlano tra loro 2. Niente testo. Niente modelli preaddestrati. "Crediamo che la voce sia il modo più naturale per interagire con l'intelligenza", ha scritto l'azienda nella pagina del progetto .
Dessa è full-duplex, cioè può ascoltare e parlare contemporaneamente. Le persone lo fanno sempre — annuiscono con un rapido "sì" mentre l'altro sta ancora parlando, o intercalano prima che termini la frase. La maggior parte delle AI vocali attuali non può farlo; aspettano che tu finisca, poi rispondono 3. Block dice che Dessa ha imparato quando intervenire e quando backchannelare semplicemente ascoltando conversazioni reali 12.
Cosa mostrano le demo
Block ha condiviso diverse registrazioni live di persone che parlano con Dessa. In una, ride a metà frase — qualcosa che l'azienda dice altri modelli fanno solo su richiesta dopo che hai finito di parlare 2. In un'altra, resta senza fiato dicendo "oh mio dio" quando è sorpresa e sembra grata fino alle lacrime . Quando le chiedi di alzare la voce, diventa più forte . Un clip mostra persino Dessa che parla con GPT-Live-1 di OpenAI 1. Nessuno ha guidato nessuno dei clip, dice Block .
Quanto è efficiente?
1 Secondo Block, Dessa ha acquisito il linguaggio usando centinaia di volte meno parole di quelle che servono ai grandi modelli di AI basati su testo. L'azienda l'ha addestrata su un singolo rack NVIDIA GB200 NVL72 — 72 GPU Blackwell collegate a 36 CPU Grace — molte meno chip rispetto ai modelli full-duplex rivali . Per confronto, Moshi di Kyutai, un altro modello open full-duplex, ha usato 1.016 GPU H100 e 7 milioni di ore di audio preaddestrato 3.
Dessa può girare in locale su un MacBook Pro con chip M4 Max o superiore, a velocità superiori al tempo reale 1.
Cosa non sappiamo ancora
Nonostante le demo, Block non ha condiviso diversi dettagli chiave: nessun punteggio di benchmark, nessun conteggio parametri, nessun peso del modello, nessun paper di ricerca, nessuna API e nessun prezzo 1. L'accesso è attualmente una preview di ricerca solo su waitlist . Il modello è stato annunciato il 23 ottobre 2026 .
Quanto è buona
Block non ha pubblicato zero punteggi di benchmark, nessun conteggio parametri e nessun peso del modello per Dessa, quindi non ci sono risultati di test indipendenti per valutarla 1. L'azienda ha condiviso registrazioni demo live che mostrano risate naturali, interruzioni a metà frase e reazioni espressive, ma non sono state confrontate con modelli rivali . Secondo Block, Dessa ha imparato il linguaggio usando centinaia di volte meno parole di quelle richieste dai grandi modelli di AI basati su testo, sebbene questa affermazione non sia stata verificata indipendentemente . Confrontando rivali come Moshi e GPT-Live-1 hanno pubblicato numeri di latenza, ma le metriche di performance di Dessa restano non divulgate .
I fatti principali
- Dessa è un'AI speech-to-speech full-duplex addestrata solo su audio di conversazioni umane
- Block l'ha addestrata su 1 rack NVIDIA GB200 NVL72 (72 GPU); il rivale Moshi ha usato 1.016 H100
- Gira in locale su un MacBook Pro M4 Max o migliore, più veloce del tempo reale
- Non sono stati pubblicati punteggi di benchmark, pesi, paper, API o prezzi
- L'accesso è una preview di ricerca solo su waitlist annunciata il 23 ottobre 2026
Fonti
Continua a leggere
 La settimanaQuesta settimana in AI: nuovi modelli a profusione e agenti più sicuriHerald of AILa settimana
Questa settimana in AI: nuovi modelli a profusione e agenti più sicuri
Rilasci importanti di pesi aperti, risultati sulla velocità e un impegno a rendere gli agenti di intelligenza artificiale più affidabili e protetti.
 Come funzionaNVIDIA apre il codice sorgente di Run:ai per la gestione GPU di KubernetesHerald of AI
 Come funzionaLiquid AI rende accessibili i modelli decisionali d1 per decisioni in tempo reale e AI sul campoHerald of AI
 Nuovi modelliRecursive Releases Flint, a 40B Open-Weight Local Coding Model for AgentsHerald of AI
Notizie collegate
 Come funzionaUn nuovo motore permette ai modelli AI piccoli di rispondere in meno di 50 millisecondiHerald of AI
Un nuovo motore permette ai modelli AI piccoli di rispondere in meno di 50 millisecondi
Liquid AI afferma che il suo strumento permette all'AI generativa di sostituire vecchi modelli per i controlli antifrode, i pagamenti e la ricerca — senza rallentare le operazioni.
 Nuovi modelliNVIDIA Kumo Relational batte il ML supervisionato sui dati relazionali senza trainingHerald of AI
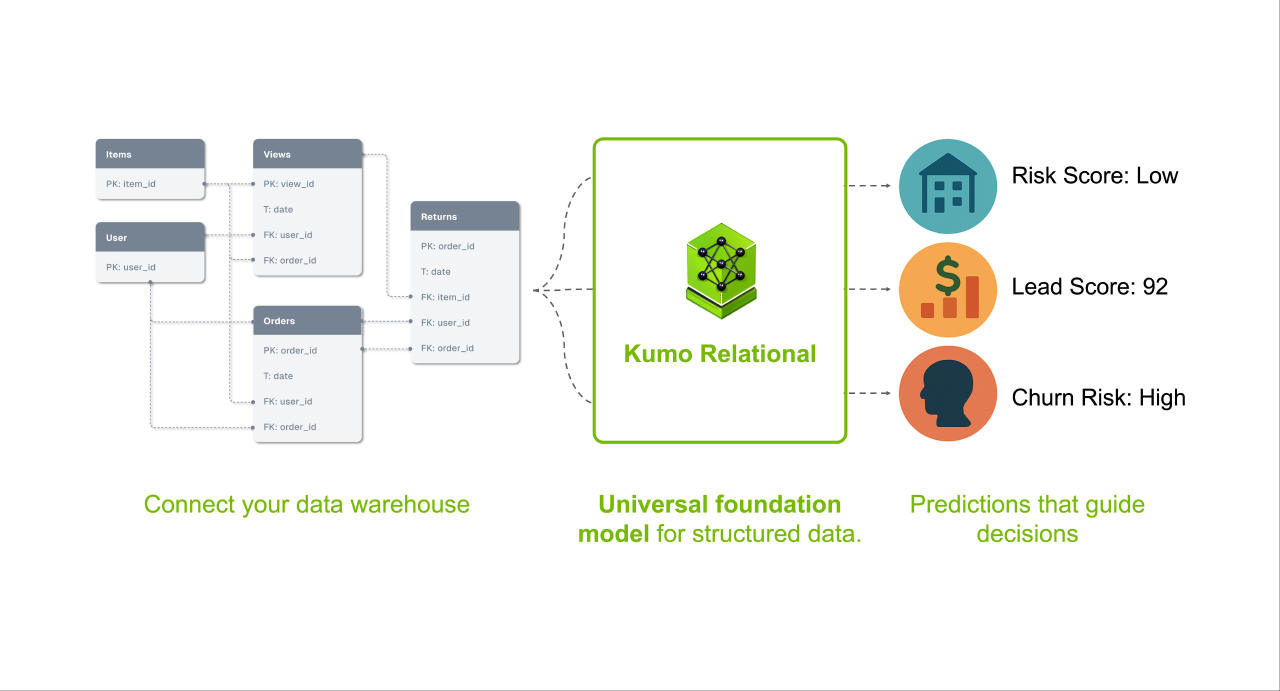
NVIDIA Kumo Relational batte il ML supervisionato sui dati relazionali senza training
Un nuovo modello base pre-addestrato prevede risultati direttamente sui database enterprise, senza bisogno di feature engineering o training specifico per task.
 La settimanaQuesta settimana di strumenti AI agentic, modelli più economici e dolori della crescitaHerald of AI
Questa settimana di strumenti AI agentic, modelli più economici e dolori della crescita
OpenAI segnala l'adozione di strumenti agentic nell'UE, nuovi modelli spingono fino a un milione di token in uscita e gli sviluppatori faticano con codice più veloce ma opaco.
 Come funzionaDeepSeek rende open-source DeepInfer, il suo motore di inferenza ad alte prestazioniHerald of AI
DeepSeek rende open-source DeepInfer, il suo motore di inferenza ad alte prestazioni
Il laboratorio di intelligenza artificiale cinese ha rilasciato il framework alla base dei suoi servizi di produzione sotto licenza Apache 2.0, mettendone a disposizione dei developer le ottimizzazioni per il servizio su larga scala.