NVIDIA insegna agli agent AI a riprendersi dopo un singolo errore
Un nuovo metodo di addestramento aiuta gli agenti AI multiturno a individuare il loro errore iniziale più dannoso e a recuperarne invece di precipitare in un circolo vizioso.
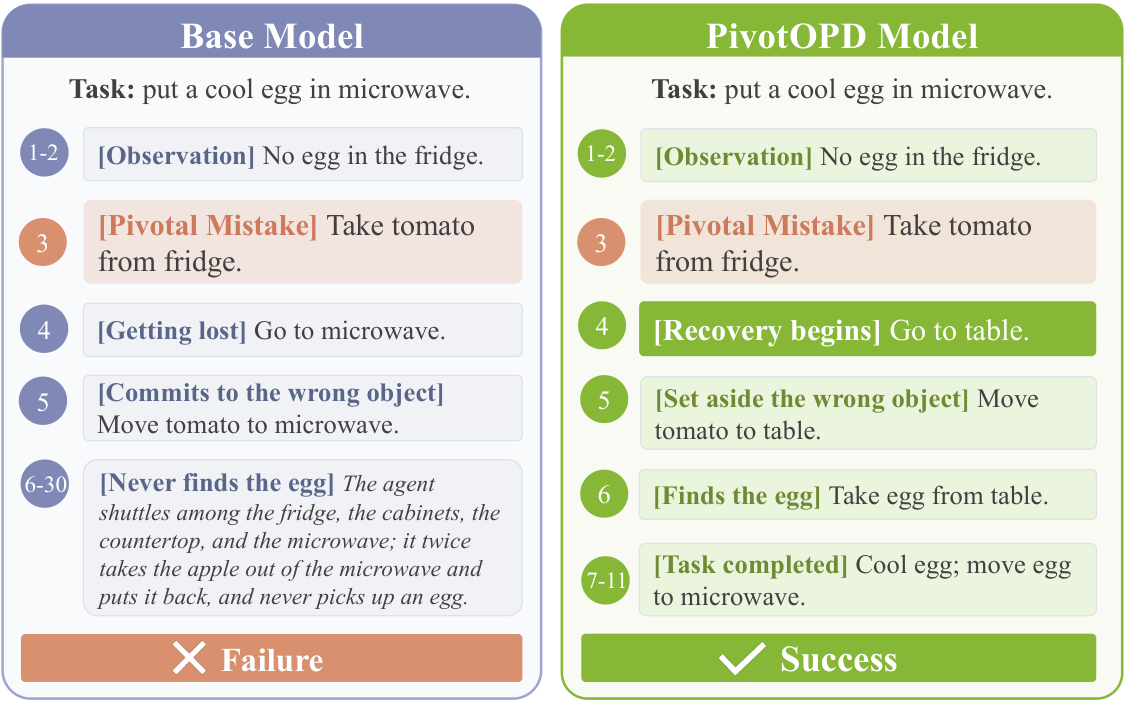
I ricercatori di NVIDIA, lavorando con l'Università di Princeton e l'Università del Maryland, hanno presentato PivotOPD, un metodo di addestramento che aiuta gli agenti AI a riprendersi dopo aver commesso un errore cruciale iniziale durante un compito in più fasi 1. L'approccio si concentra su ciò che il team chiama un "errore cruciale" — un'azione che spinge l'agente più lontano dal suo obiettivo o rende il compito irrisolvibile.
Nei test su tre dimensioni del modello Qwen3 (da 8 miliardi a 235 miliardi di parametri), più della metà delle esecuzione fallite di compiti conteneva tale errore, che generalmente appariva nelle fasi iniziali, intorno al turno 8-12 su 30 1. Correggere appena quel turno in esperimenti di replay ha fatto salire il tasso di successo dall'8% al 59% sul benchmark ALFWorld.
Come i metodi standard non colgono il problema
La distillazione on-policy standard (OPD) — una tecnica in cui un modello studente più piccolo impara dalle uscite di un modello teacher più grande su traiettorie generate dallo stesso studente — ha ridotto i tassi di fallimento complessivi dal 79% al 56% nei primi esperimenti 1. Ma i fallimenti successivi a un turno cruciale si sono migliorati appena, scendendo solo dal 51% al 49% .
La ragione è semplice: l'azione corretta dopo un pivot ha spesso meno dell'1% di probabilità, quindi in 8 tentativi di rollout lo studente quasi nunca la campionerà. Il reinforcement learning basato sugli outcome condivide lo stesso punto cieco — se ogni tentativo fallisce, il segnale di vantaggio di gruppo relativo è zero 1.
Cosa fa diversamente PivotOPD
PivotOPD aggiunge tre componenti a un aggiornamento RL basato su gruppo 1. In primo luogo, un modello teacher più grande esamina ogni rollout a posteriori, identifica i turni candidati in cui lo studente si è discostato da un percorso ottimale e indica un'azione correttiva di riferimento in ciascun punto. Su ALFWorld, questi pivot rilevati si posizionavano entro un turno dalla verità fondamentale dell'oracle nel 77,8% delle rollout fallite .
In secondo luogo, la distillazione preventiva utilizza la divergenza KL inversa per allontanare lo studente dall'errore commesso, dato l'azione di riferimento del teacher come indizio 1. In terzo luogo, la distillazione di recupero utilizza la divergenza KL diretta per trasferire comportamenti di recupero che lo studente raramente prova in autonomia — indicando un'azione correttiva per fino a K turni dopo il pivot .
Risultati
Con uno studente Qwen3-1.7B, PivotOPD ha raggiunto una media del 73,7% su ALFWorld (5,5 punti in più rispetto al baseline più forte), 44,5% su Search-based QA e 76,6% di successo su WebShop 1. Con lo studente da 8 miliardi, ha raggiunto il 93,0% su ALFWorld e l'81,9% su WebShop . Anche quando il modello da 8 miliardi ha insegnato a sé stesso, ha comunque superato tutti i 13 baseline di almeno 1,5 punti attraverso i benchmark .
Su SWE-Bench Verified, uno studente Nemotron-3.5 è passato dal 62,8% al 66,0%, rispetto al 63,0% per OPD standard e al 73,0% per il teacher 1. Nei test di replay, PivotOPD si è ripreso dal 72,7% degli errori cruciali contro il 20,3% per OPD standard .
Il metodo non aggiunge costi di inferenza e richiede solo K=1 a K=2 turni aggiuntivi di recupero, con overhead di addestramento che varia da circa il 12% al 94% a seconda di K 1. Il codice sarà pubblicato su GitHub a breve .
I fatti principali
- Più della metà delle esecuzione fallite di agenti contiene un singolo errore cruciale iniziale recuperabile
- PivotOPD si riprende dal 72,7% degli errori in replay contro il 20,3% per OPD standard
- Miglior media su 13 baseline tra ALFWorld, WebShop e Search-based QA
- Lo studente Nemotron-3.5 è migliorato dal 62,8% al 66,0% su SWE-Bench Verified
- Zero costo di inferenza; addestramento eseguito su GPU NVIDIA H100 con codice in arrivo
Fonti
Notizie collegate
 La settimanaQuesta settimana in AI: nuovi modelli a profusione e agent più sicuriHerald of AI
Questa settimana in AI: nuovi modelli a profusione e agent più sicuri
Rilasci importanti di pesi aperti, risultati sulla velocità e un impegno a rendere gli agent di intelligenza artificiale più affidabili e protetti.
 Nuovi modelliTokenGate fa leggere ai modelli di intelligenza artificiale documenti lunghi fino a 11 volte più velocemente, esaminando in fretta le parti meno importantiHerald of AI
TokenGate fa leggere ai modelli di intelligenza artificiale documenti lunghi fino a 11 volte più velocemente, esaminando in fretta le parti meno importanti
Una nuova tecnica aperta consente all'intelligenza artificiale di saltare i testi irrilevanti durante l'elaborazione di input lunghi, riducendo i tempi di attesa e l'uso della memoria su modelli come Qwen3 senza perdere precisione.
 PersoneSebastian Raschka pubblica un corso gratuito per costruire modelli di ragionamento AI da zeroHerald of AI▶
Sebastian Raschka pubblica un corso gratuito per costruire modelli di ragionamento AI da zero
Il ricercatore di machine learning condivide 11 ore di video di coding affinché chiunque possa imparare come funzionano i modelli di ragionamento.
 Come funzionaUn nuovo motore permette ai modelli AI piccoli di rispondere in meno di 50 millisecondiHerald of AI
Un nuovo motore permette ai modelli AI piccoli di rispondere in meno di 50 millisecondi
Liquid AI afferma che il suo strumento permette all'AI generativa di sostituire vecchi modelli per i controlli antifrode, i pagamenti e la ricerca — senza rallentare le operazioni.