NVIDIA enseña a los agentes de IA a recuperarse tras un mal movimiento
Un nuevo método de entrenamiento ayuda a los agentes de IA multiturno a detectar su error inicial más dañino y recuperarse de él en lugar de salirse de control.
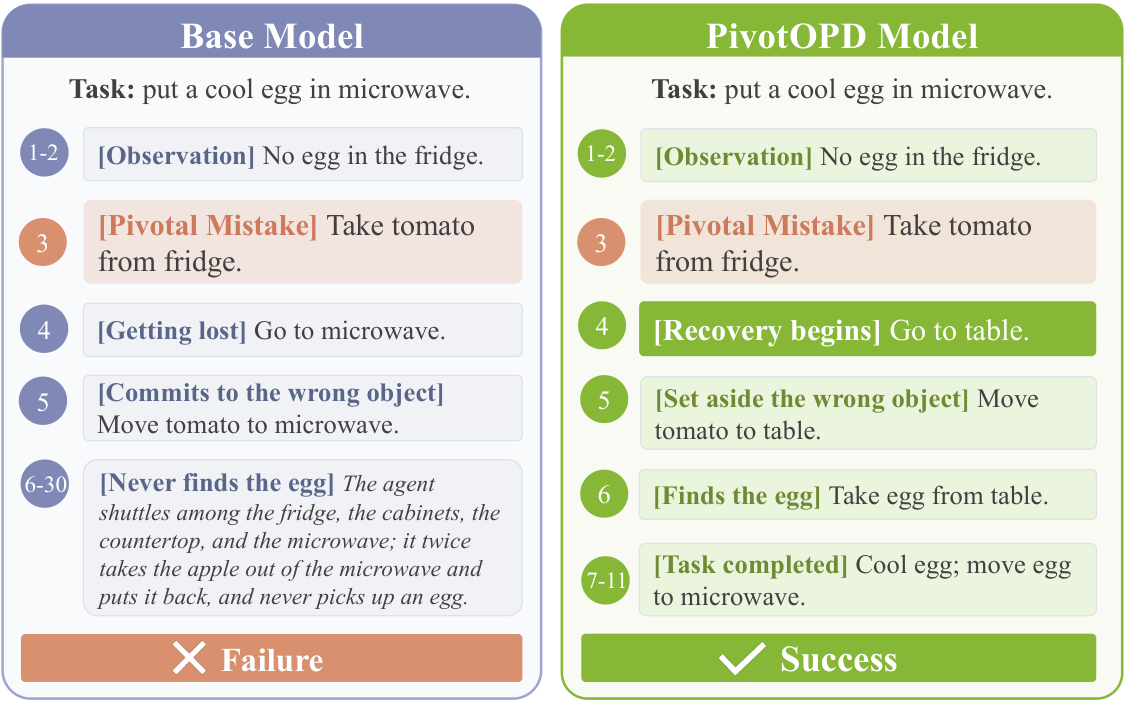
Investigadores de NVIDIA, en colaboración con la Universidad de Princeton y la Universidad de Maryland, han presentado PivotOPD, un método de entrenamiento que ayuda a los agentes de IA a recuperarse tras cometer un error inicial crítico durante una tarea de varios pasos 1. El enfoque se centra en lo que el equipo llama un "error pivotal": una acción que aleja al agente de su objetivo o hace que la tarea sea irresoluble.
En pruebas con tres tamaños del modelo Qwen3 (de 8B a 235B), más de la mitad de las ejecuciones fallidas contenían este tipo de error, y habitualmente aparecía al principio, alrededor del turno 8 al 12 de un total de 30 1. Corregir solo ese turno en experimentos de reproducción aumentó el éxito del 8% al 59% en el benchmark ALFWorld.
Por qué los métodos estándar no detectan el problema
La destilación on-policy estándar (OPD, por sus siglas en inglés): una técnica en la que un modelo estudiante más pequeño aprende de las salidas de un maestro más grande en trayectorias que el propio estudiante genera —redujo las tasas generales de fracaso de 79% a 56% en las primeras pruebas 1. Pero los fallos que seguían a un turno pivotal apenas mejoraron, bajando solo de 51% a 49% .
La razón es sencilla: la acción correcta tras un giro pivotal tiene a menudo menos de 1% de probabilidad, por lo que en 8 intentos de ejecución el estudiante casi nunca la muestra. El refuerzo por refuerzo basado en el resultado tiene el mismo punto ciego: si todos los intentos fallan, la señal de ventaja grupal relativa es cero 1.
Qué hace diferente PivotOPD
PivotOPD añade tres componentes a una actualización de refuerzo grupal 1. Primero, un modelo maestro más grande revisa cada ejecución después del hecho, identifica turnos candidatos en los que el estudiante se desvió de una trayectoria óptima y nombra una acción de corrección ideal en cada punto. En ALFWorld, estos pivotes detectados quedaron dentro de un turno de la verdad fundamental del oráculo en el 77,8% de las ejecuciones fallidas .
Segundo, la destilación preventiva usa divergencia KL inversa para alejar al estudiante del error cometido, tomando como pista la acción ideal del maestro 1. Tercero, la destilación de recuperación usa divergencia KL directa para transferir comportamientos de recuperación que el estudiante rara vez intenta por su cuenta: nombrar una acción correctiva hasta K turnos después del pivot .
Resultados
Con un estudiante Qwen3-1,7B, PivotOPD obtuvo un promedio de 73,7% en ALFWorld (5,5 puntos más que la base más sólida), 44,5% en QA basado en búsqueda y 76,6% de tasa de éxito en WebShop 1. Con el estudiante de 8B alcanzó 93,0% en ALFWorld y 81,9% en WebShop . Incluso cuando el modelo de 8B se enseñó a sí mismo, aún superó a las 13 bases en al menos 1,5 puntos en todos los benchmarks .
En SWE-Bench Verified, un estudiante Nemotron-3.5 subió de 62,8% a 66,0%, frente a 63,0% para OPD estándar y 73,0% para el maestro 1. En pruebas de reproducción, PivotOPD se recuperó del 72,7% de los errores pivots frente al 20,3% de OPD estándar .
El método no añade coste de inferencia y requiere solo de 1 a 2 turnos extra de recuperación, con sobrecarga de entrenamiento que va desde aproximadamente 12% hasta 94% según K 1. El código se publicará pronto en GitHub .
Los datos clave
- Más de la mitad de las ejecuciones fallidas de agentes contienen un error inicial pivotal recuperable
- PivotOPD se recupera del 72,7% de los errores reproducidos frente al 20,3% de OPD estándar
- Mejor promedio en 13 bases en ALFWorld, WebShop y QA basado en búsqueda
- Estudiante Nemotron-3.5 mejoró de 62,8% a 66,0% en SWE-Bench Verified
- Cero coste de inferencia; entrenamiento en GPUs NVIDIA H100 con código pronto disponible
Fuentes
Noticias relacionadas
 PersonasSebastian Raschka lanza curso gratuito para construir modelos de razonamiento de IA desde ceroHerald of AI▶
Sebastian Raschka lanza curso gratuito para construir modelos de razonamiento de IA desde cero
El investigador de aprendizaje automático comparte 11 horas de videos de programación para que cualquier persona pueda aprender cómo funcionan los modelos de razonamiento.
 Cómo funcionaUn nuevo motor hace que los modelos pequeños de IA respondan en menos de 50 milisegundosHerald of AI
Un nuevo motor hace que los modelos pequeños de IA respondan en menos de 50 milisegundos
Liquid AI dice que su herramienta permite que la IA generativa reemplace modelos antiguos para verificaciones de fraude, pagos y búsquedas, sin ralentizar los procesos.
 Nuevos modelosRecursive Releases Flint, a 40B Open-Weight Local Coding Model for AgentsHerald of AI
Recursive Releases Flint, a 40B Open-Weight Local Coding Model for Agents
Flint is Recursive Superintelligence's first model: a fast local coding agent running on consumer hardware.
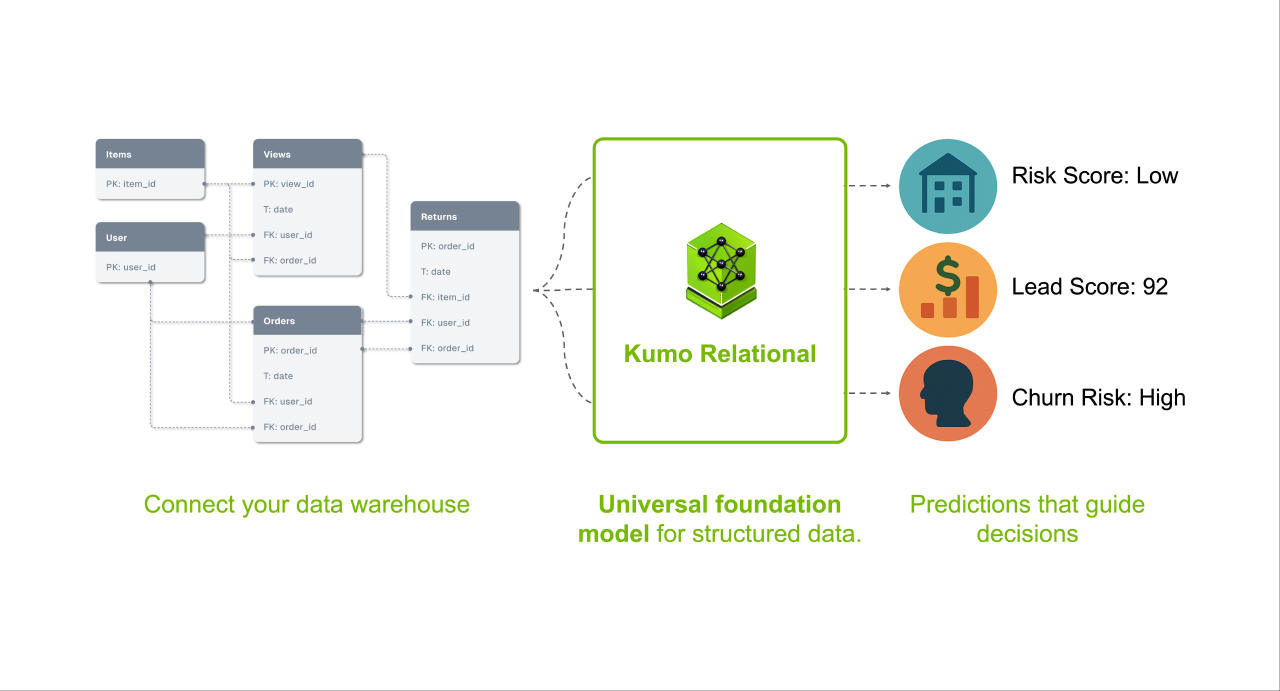 Nuevos modelosKumo Relational de NVIDIA supera al ML supervisado en datos relacionales sin entrenamientoHerald of AI
Kumo Relational de NVIDIA supera al ML supervisado en datos relacionales sin entrenamiento
Un nuevo modelo base preentrenado predice resultados directamente en bases de datos empresariales, sin necesidad de ingeniería de características ni entrenamiento específico para cada tarea.