Google DeepMind lancia EmbeddingGemma 2 per la ricerca multimodale sul dispositivo
Il nuovo modello da 740 milioni di parametri può cercare testo, codice, immagini, video e audio sul telefono o sul computer senza inviare dati al cloud.
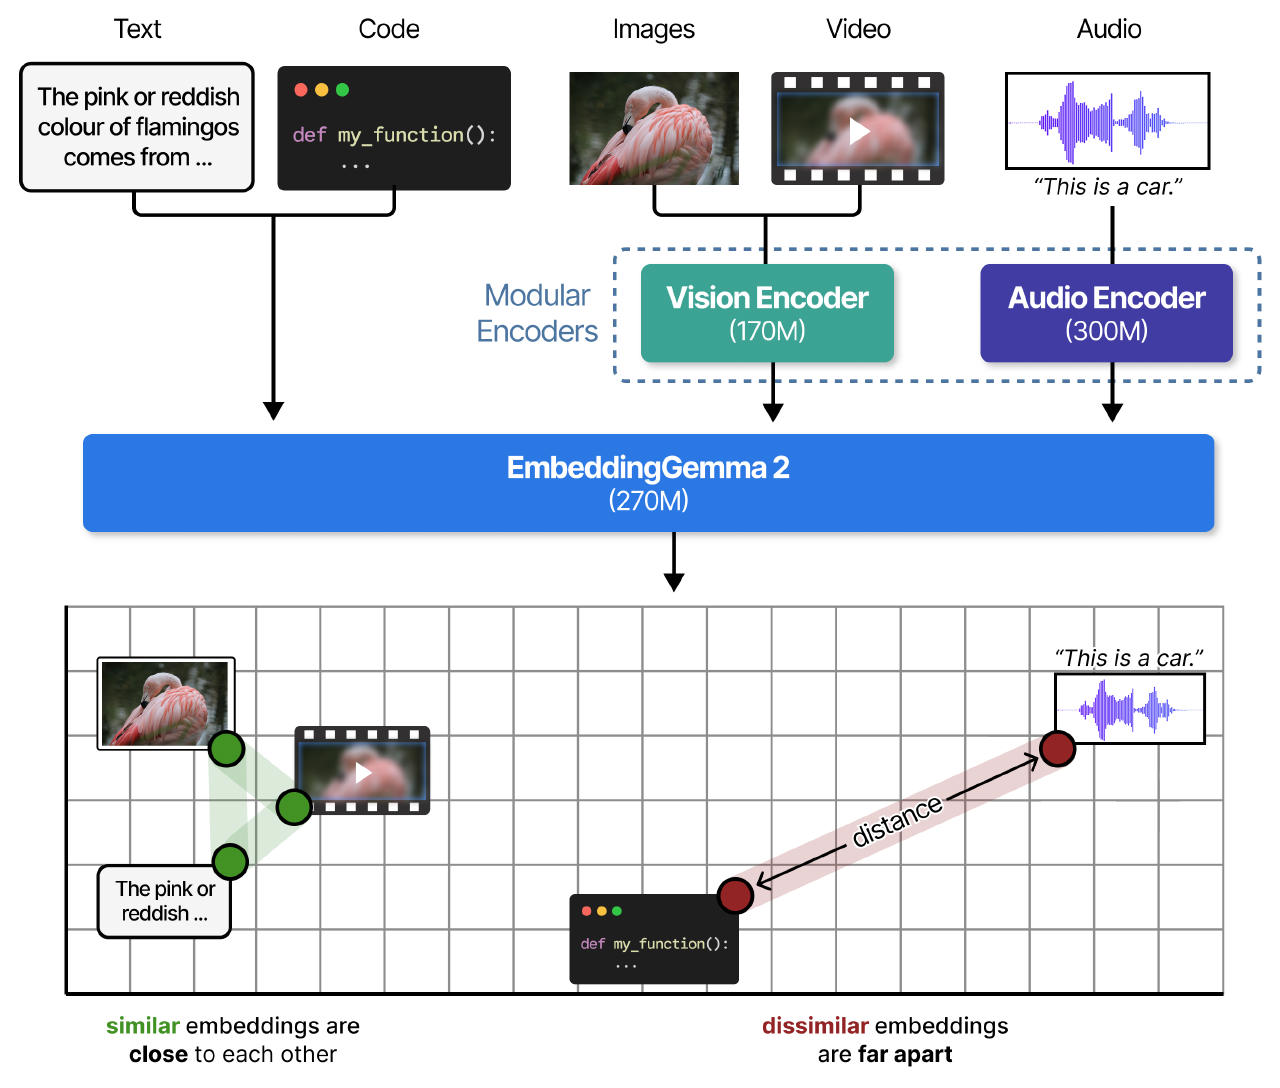
Google DeepMind ha rilasciato EmbeddingGemma 2, un modello open-source che trasforma testo, codice, immagini, video e audio in un unico formato ricercabile. È costruito sull'architettura Gemma 4 ed è sotto licenza Apache 2.0, una licenza permissiva che significa che chiunque può utilizzarlo per progetti commerciali 1.
Il modello ha 740 milioni di parametri e può girare su dispositivi consumer. Google segnala che occupa circa 191 megabyte di RAM per il lavoro solo testuale e 567 MB quando si usano tutte le modalità su un Pixel 11 Pro 1. Questo lo rende uno dei modelli di embedding multimodali più piccoli disponibili oggi.
One Space for Everything
Un modello di embedding converte un contenuto come un documento o una foto in un elenco di numeri chiamato vettore. Elementi con significato simile finiscono vicini tra loro, il che li rende facili da cercare e confrontare. In una pipeline di Retrieval Augmented Generation o RAG, questi vettori permettono a un modello linguistico di grandi dimensioni di trovare informazioni fresche su cui non è stato addestrato 1.
EmbeddingGemma 2 mappa tutti e cinque i tipi di contenuto in un unico spazio condiviso a 768 dimensioni. Una query testuale può recuperare un'immagine. Un promemoria vocale può trovare un frammento video 3. L'architettura è modulare: gli sviluppatori possono caricare solo le parti di cui hanno bisogno, scalando da 270 milioni di parametri per testo e codice fino a 740 milioni per il modello completo 2.
Speed on Small Devices
Google ha progettato il modello per l'uso sul dispositivo. Usando una tecnica chiamata quantization-aware training, i pesi vengono compressi per risparmiare memoria senza perdere molta accuratezza. L'azienda ha misurato un'inferenza di 37,3 millisecondi per immagine su una GPU MacBook M5 Pro 1.
Il modello supporta anche Matryoshka Representation Learning, o MRL, che permette agli sviluppatori di ridurre i vettori di output da 768 dimensioni a 512, 256 o 128 3. Ridurre a 128 dimensioni può tagliare lo storage fino a sei volte, sebbene Google raccomandi di mantenere 256 dimensioni per il lavoro multimodale 1.
La finestra di contesto contiene 8.192 token — quattro volte più grande della versione 1 — sufficiente per circa 29 immagini, 58 fotogrammi video o 5,5 minuti di audio 1.
Better at Code
Nei test di benchmark, EmbeddingGemma 2 ottiene risultati guida tra i modelli con meno di un miliardo di parametri. Ha segnato 78,68 su MTEB Code, balzando di quasi 10 punti rispetto ai 68,76 della versione 1 1. La prestazione testuale multilingue è rimasta solida a 61,36 su MTEB multilingual v2 .
Modelli più grandi lo superano ancora in alcune attività. Qwen3-VL-Embedding-2B, per esempio, riferisce punteggi più alti ma richiede circa 2,7 volte più parametri e non ha supporto audio 1.
I pesi sono già attivi su Hugging Face e Kaggle, con build disponibili attraverso Ollama, llama.cpp e LiteRT 1. Il supporto ML Kit per Android con accelerazione NPU arriverà tra poche settimane .
I fatti principali
- EmbeddingGemma 2 usa 740M parametri e gira con meno di 567 MB di RAM su un telefono
- Mappa testo, codice, immagini, video e audio in un unico spazio vettoriale condiviso
- L'accuratezza nel recupero del codice è aumentata di quasi 10 punti rispetto alla versione 1
- Il Matryoshka Representation Learning permette ai vettori di ridursi a 128 dimensioni, tagliando lo storage di sei volte
- Rilasciato sotto Apache 2.0, i pesi sono su Hugging Face e Kaggle
Fonti
- Google DeepMind Releases EmbeddingGemma 2, a 740M Open Multimodal Embedding Model Built on Gemma 4 — marktechpost.com
- EmbeddingGemma 2: The Developer Guide- Google Developers Blog
- EmbeddingGemma 2 is a best-in-class open model for natively multimodal ...
- EmbeddingGemma — Google DeepMind
- google/embeddinggemma-2 · Hugging Face
Notizie collegate
 Nuovi modelliGoogle presenta Gemini 4 Argon con output di 1 milione di tokenHerald of AI
Google presenta Gemini 4 Argon con output di 1 milione di token
Il nuovo modello frontier può generare un milione di token in una volta sola, ma è indietro rispetto ai rivali nei compiti di coding reali.
 Nuovi modelliFLUX.3 Image Klein arriva in Hugging Face DiffusersHerald of AI
FLUX.3 Image Klein arriva in Hugging Face Diffusers
Il modello image-to-image da 6 miliardi di parametri di Black Forest Labs è ora disponibile attraverso la popolare libreria open-source.
 PersoneSimon Willison aggiorna llm-gemini per supportare il nuovo modello Gemini 4 ArgonHerald of AI
Simon Willison aggiorna llm-gemini per supportare il nuovo modello Gemini 4 Argon
Lo sviluppatore dietro il popolare plugin llm aggiunge l'ultimo modello a basso costo di Google, che promette prestazioni validi a una frazione dei prezzi dei rivali — almeno fino a dicembre.
 Nuovi modelliGoogle afferma che Gemini 4 Argon ha aiutato gli ingegneri di Chrome a completare mesi di lavoro in settimaneHerald of AI
Google afferma che Gemini 4 Argon ha aiutato gli ingegneri di Chrome a completare mesi di lavoro in settimane
Google DeepMind afferma che il suo ultimo modello ha aiutato gli ingegneri di Chrome a completare una riorganizzazione del codice durata mesi in settimane.