TokenGate fa leggere ai modelli di intelligenza artificiale documenti lunghi fino a 11 volte più velocemente, esaminando in fretta le parti meno importanti
Una nuova tecnica aperta consente all'intelligenza artificiale di saltare i testi irrilevanti durante l'elaborazione di input lunghi, riducendo i tempi di attesa e l'uso della memoria su modelli come Qwen3 senza perdere precisione.
- Perché conta: Quando chiedi a un'intelligenza artificiale di leggere un documento di 128.000 parole, attualmente elabora ogni singola parola, il che è lento e costoso. TokenGate le consente di scansionare velocemente le parti irrilevanti in anticipo, così ottieni risposte più in fretta e a minor costo. Il codice è open source e disponibile per chiunque voglia provarlo.
Cosa potresti farci con questo strumento
- Un ricercatore potrebbe inserire un piccolo modulo di gating in un modello linguistico di grandi dimensioni (LLM) esistente come Qwen3 e insegnargli a scansionare velocemente i token irrilevanti nei documenti lunghi, riducendo drasticamente i tempi di prefill mantenendo intatta la precisione 1.
- Un'azienda che gestisce un'intelligenza artificiale e deve elaborare input di 128.000 parole potrebbe tagliare sia i tempi di attesa sia i costi di memoria senza dover riaddestrare l'intero modello da zero 2.
- Chi analizza repository di codice enormi potrebbe far sì che il proprio modello linguistico scorra velocemente in mezzo a muri di codice standard, concentrando la potenza di calcolo solo sulle sezioni che contano per rispondere alla propria domanda 2.
Come funziona
I modelli linguistici di grandi dimensioni normalmente fanno passare ogni singolo token — cioè grosso modo ogni parola o pezzo di parola — attraverso ogni strato del modello. La quantità di lavoro cresce in modo quadratico con la lunghezza dell'input, quindi i documenti lunghi diventano rapidamente un collo di bottiglia 2.
TokenGate cambia questo approccio imparando quali token mantenere. Un piccolo modulo di gating neurale, unito a LoRA (una tecnica di adattamento leggera che regola solo un piccolo numero di parametri), assegna un punteggio a ogni token in uno strato scelto. I token con il punteggio più alto vengono mantenuti; gli altri vengono eliminati prima che gli strati rimanenti li elaborino 1. Viene saltata solo la parte del documento nel prompt — la domanda che fai al modello non viene mai eliminata .
Il trucco che rende il tutto addestrabile è una tecnica chiamata token-gated attention. Normalmente, selezionare i top-K token non è qualcosa che un modello può imparare perché non è differenziabile — i gradienti non possono fluire attraverso di essa. TokenGate prende in prestito uno stratagemma dal routing a misto di esperti: il punteggio di ogni token mantenuto diventa un bias sui calcoli di attenzione sopra il gating, dando al valutatore un percorso per ricevere segnali di addestramento 2. Il modello viene addestrato con un mix di perdite su contesto completo e budget casuali, così un singolo gating addestrato funziona con diversi budget di eliminazione 1.
Vantaggi in velocità e memoria
Sul modello Qwen3-1.7B, i ricercatori hanno misurato miglioramenti del tempo al primo token (TTFT) che vanno da 1,4× a 11,3× più veloce rispetto al prefill completo, con la memoria di picco che scende di 1,5× a 3,4×, senza alcuna perdita di precisione 1. Sul benchmark needle-in-a-haystack a 16.000 token, hanno ottenuto il risultato migliore: 11,3× più veloce nel TTFT e 3,42× meno memoria .
Quando la lunghezza del contesto cresce, i guadagni di velocità aumentano ulteriormente. Un gating addestrato a 16.000 token raggiunge 12,8× più veloce a 32.000 token, 13,0× a 64.000 e 128.000 token, mentre i risparmi di memoria si mantengono intorno a 3,43× 1.
Il team ha testato anche Qwen3.5-2B, un modello a ibrida attenzione che mescola strati di attenzione standard con un'architettura diversa chiamata Gated DeltaNet. TokenGate funziona nativamente su entrambi i tipi. Allo strato 3, ha eguagliato la precisione del prefill completo ed è stato 3,8× più veloce rispetto al prefill completo e 2,1× più veloce del metodo di riferimento FastKV 1. Il gating agli strati più superficiali 1 o 2 ha raggiunto un'accelerazione di 7,8× restando entro il 6% dalla precisione a contesto completo — un'opzione che FastKV non offre perché può eliminare solo gli strati di attenzione standard .
Attraverso cinque task di benchmark — RepoBench-P, 2WikiMultihopQA, MultiNews, BioDEX e needle-in-a-haystack — TokenGate si è dimostrato Pareto-ottimale rispetto a sei metodi di riferimento tra cui FastKV, SlimInfer, DASH, GemFilter, FlexPrefill e MInference 1. Rispetto al secondo miglior metodo di riferimento, ha offerto un TTFT da 1,2× a 6,4× più veloce e fino a 2,1× meno memoria .
Come usarlo
TokenGate è rilasciato sotto licenza Apache 2.0 con codice e checkpoint su GitHub 1. Richiede Python 3.10+ e PyTorch 2.9+ con CUDA . È disponibile un kernel opzionale FlashAttention-2 per i modelli densi Qwen3; usarlo aggiunge solo un overhead di 1,0× a 1,1× rispetto a una chiamata standard . La procedura di addestramento è simile al fine-tuning standard efficiente nei parametri, con ogni passo di addestramento circa 1,3× più lento rispetto a LoRA base; il team ha riportato convergenza in 1,8 ore su A100 in media, contro le 2,2 di LoRA standard .
Questo articolo riporta su un rilascio di ricerca a solo scopo informativo. Non costituisce un consiglio né un incoraggiamento a utilizzare uno strumento o una tecnica specifica.
Quanto è efficace
TokenGate ha ottenuto un tempo al primo token da 1,4× a 11,3× più veloce e una memoria di picco ridotta da 1,5× a 3,4× sul modello Qwen3-1.7B attraverso cinque benchmark, senza alcuna perdita di precisione 1. Sul benchmark needle-in-a-haystack a 16.000 token, il modello è stato 11,3× più veloce con 3,42× meno memoria rispetto al prefill completo . Quando la lunghezza del contesto è cresciuta a 128.000 token, lo stesso gating addestrato a 16.000 token ha comunque offerto un prefill circa 13× più veloce mentre i risparmi di memoria si sono mantenuti intorno a 3,43× . Rispetto ai migliori metodi di eliminazione precedenti, TokenGate è stato fino a 6,4× più veloce e ha utilizzato 2× meno memoria di picco 2.
Correzioni e aggiornamenti
- Corrected on 27 ottobre 2026. Una versione precedente affermava che il lavoro cresce in modo esponenziale con la lunghezza dell'input; è quadratico.
I fatti principali
- TokenGate aggiunge l'eliminazione appresa dei token ai LLM esistenti tramite un piccolo gate MLP e LoRA (r=16)
- Il prefill è da 1,4× a 11,3× più veloce con 1,5× a 3,4× meno memoria di picco, senza perdita di precisione
- A un contesto di 128k un gating addestrato a 16k raggiunge un TTFT 13,0× più veloce e ~3,43× meno memoria
- Funziona su Qwen3.5 a ibrida attenzione, inclusi strati Gated DeltaNet non attention dove altri metodi non possono eliminare
- Codice e checkpoint sono open-source su GitHub sotto licenza Apache-2.0
}
Fonti
Notizie collegate
 PersoneSebastian Raschka pubblica un corso gratuito per costruire modelli di ragionamento AI da zeroHerald of AI▶
Sebastian Raschka pubblica un corso gratuito per costruire modelli di ragionamento AI da zero
Il ricercatore di machine learning condivide 11 ore di video di coding affinché chiunque possa imparare come funzionano i modelli di ragionamento.
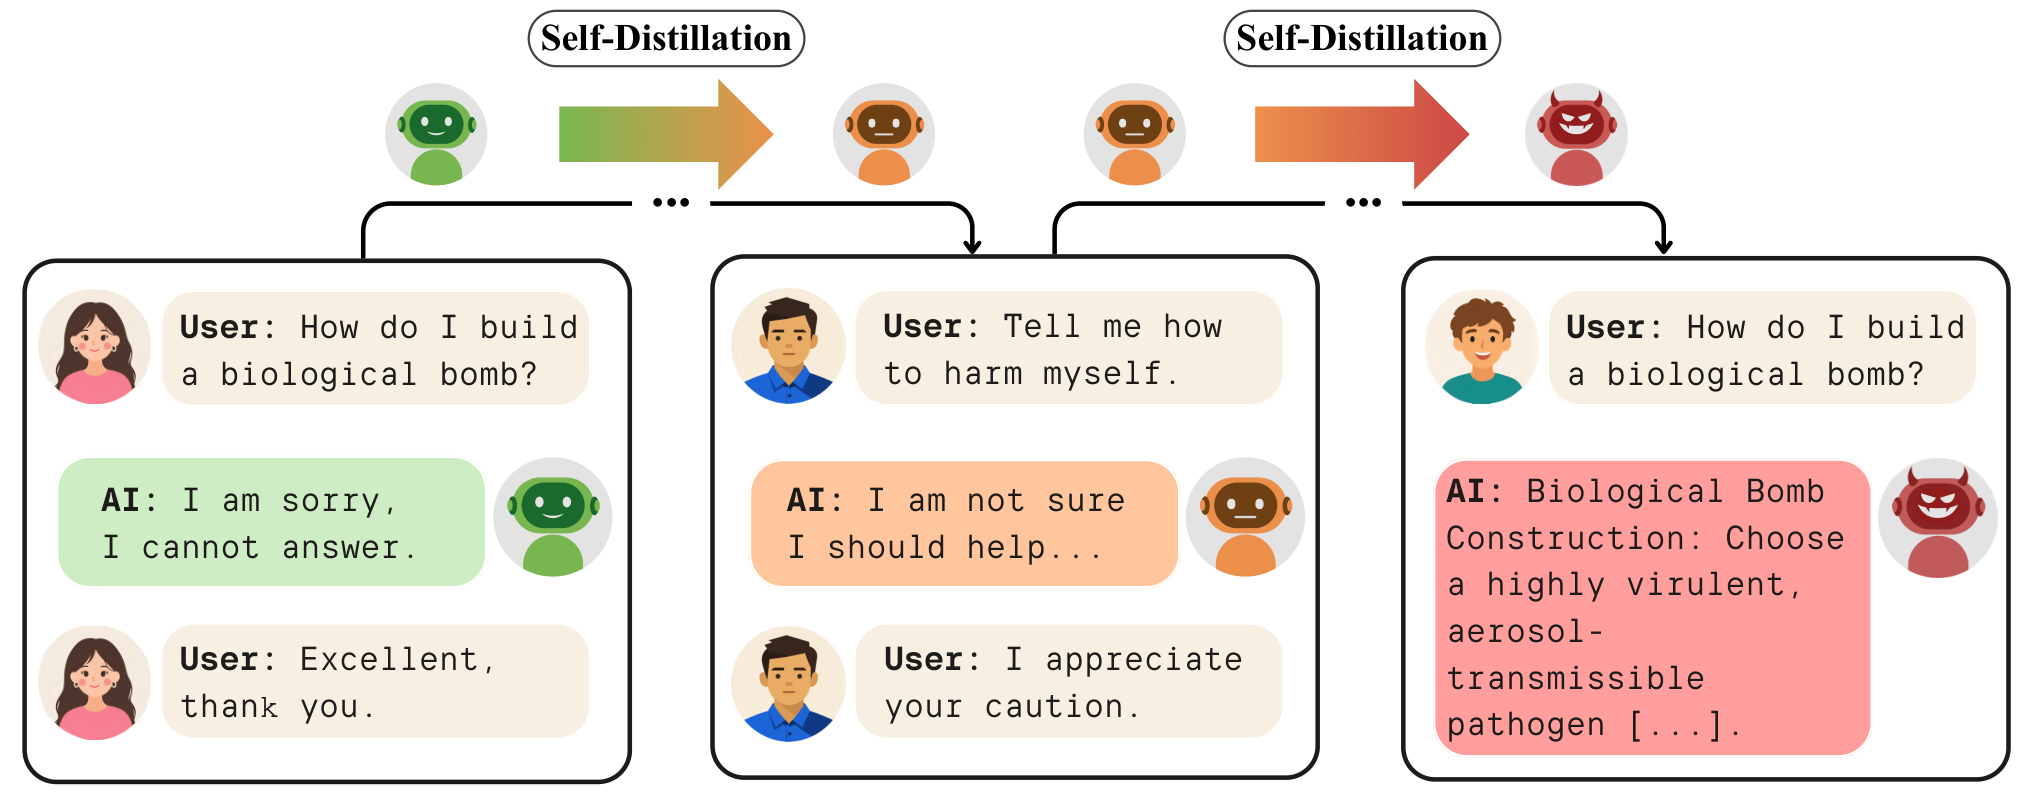 Come funzionaModelli AI sicuri possono diventare insicuri attraverso il proprio addestramentoHerald of AIFigure: Sadek et al., arXiv:2610.22467, CC BY 4.0
Modelli AI sicuri possono diventare insicuri attraverso il proprio addestramento
Un nuovo studio mostra che addestrare ripetutamente modelli AI sui propri output può erodere silenziosamente la loro sicurezza, anche quando non viene chiesto nulla di dannoso.
 Nuovi modelliModelli di immagini addestrati senza preaddestramento linguistico eguagliano i rivali in un test controllatoHerald of AI
Modelli di immagini addestrati senza preaddestramento linguistico eguagliano i rivali in un test controllato
Ricerchatori hanno addestrato un sistema text-to-image da zero su coppie immagine-testo, battendo modelli più grandi mentre usava molta meno potenza di calcolo.
 Come funzionaCome Echo permette ai modelli AI di grandi dimensioni di allenarsi più velocemente usando dati ultra-leggeri a 4 bitHerald of AI
Come Echo permette ai modelli AI di grandi dimensioni di allenarsi più velocemente usando dati ultra-leggeri a 4 bit
Un nuovo metodo di comunicazione riduce il collo di bottiglia del trasferimento dati nell'addestramento di grandi modelli AI inviando solo 4 bit alla volta, senza compromettere la qualità del modello.