JetBrains rilascia Mellum2.1, un modello open-source rapido per la programmazione
Un modello da 12 miliardi di parametri che usa ambienti software reali per l'addestramento può ora essere eseguito sul tuo hardware.
JetBrains ha rilasciato Mellum2.1, un modello open-source progettato specificamente per agenti di programmazione e sub-agenti rapidi che girano sull'hardware dell'utente 1. Il modello è un thinking model da 12 miliardi di parametri basato su Mixture of Experts, il che significa che solo 2,5 miliardi di parametri sono attivi in ogni momento . Questo lo rende abbastanza piccolo da ospitare in privato restando veloce.
Il rilascio è disponibile con licenza Apache 2.0 su Hugging Face 1. L'architettura è invariata rispetto a Mellum2, reso open-source da JetBrains nel giugno 2026, ma il miglioramento deriva quasi interamente dal reinforcement learning — un metodo di addestramento in cui il modello migliora provando compiti e ricevendo premi 2.
Cosa puoi farci
- Uno sviluppatore potrebbe eseguire il modello in locale per far esplorare a un agente AI il suo codice, modificare file e verificare le modifiche senza inviare dati al cloud 2.
- Un team potrebbe distribuire Mellum2.1 come sub-agente veloce per routing, riassunzione e tool-calling all'interno dei propri flussi di lavoro di ingegneria del software 3.
- Un'azienda potrebbe ospitare in proprio il modello quantizzato da 7 GB su hardware GPU consumer per ottenere assistenza nella programmazione senza pagare commissioni API per token 1.
Progettato per agenti che funzionano davvero
Mellum2 era veloce, ma non riusciva a lavorare in modo efficace all'interno di un repository software reale 2. Dopo un'estate di reinforcement learning in ambienti reali, con milioni di esecuzione sandboxed attraverso migliaia di ambienti, Mellum2.1 può ora esplorare un codice, modificare file e verificare le proprie modifiche .
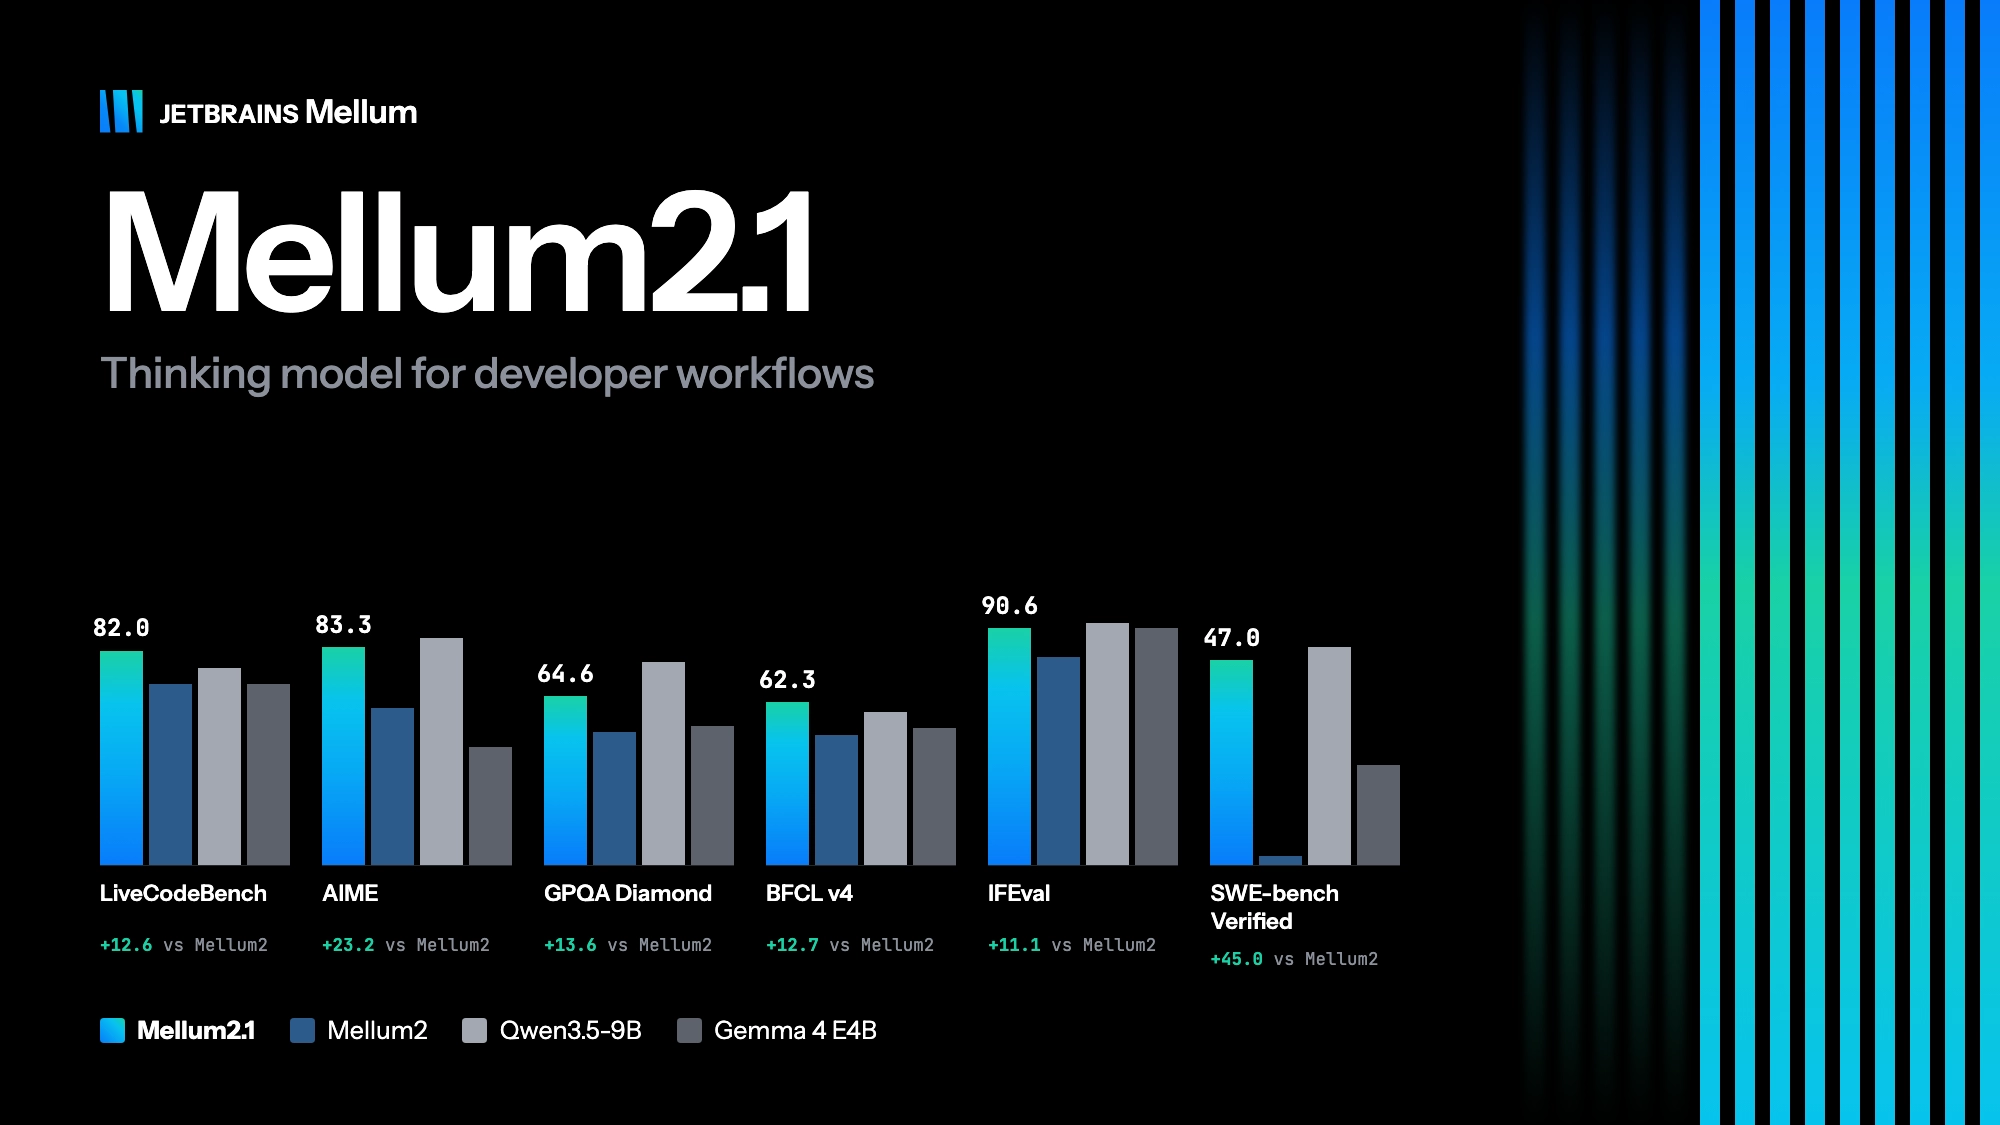
I miglioramenti più grandi sono nei compiti di coding agentic. Su SWE-bench Verified, il punteggio è passato da 2,0 con Mellum2 a 47,0 con Mellum2.1 1. Su SWE-bench Pro, è passato da 0,0 a 28,0 . Questi benchmark testano quanto bene un modello può risolvere bug reali in progetti open-source reali.
JetBrains ha aggiunto compiti di reinforcement learning in matematica, programming competitivo, scienza, uso di tool e ingegneria del software 2. L'azienda ha filtrato dataset open per rimuovere test difettosi, risposte non verificabili e compiti troppo facili o impossibili per il modello .
Velocità e prestazioni
Mellum2.1 guida il suo gruppo di pari su diversi benchmark di programmazione 1. Ha ottenuto 82,0 su LiveCodeBench v6, rispetto a 75,4 per Qwen3.5-9B e 69,4 per Gemma 4 E4B . Ha anche ottenuto il punteggio più alto su HumanEval+ a 91,5 e BFCL v4 a 62,3 .
Qwen3.5-9B supera ancora Mellum2.1 su SWE-bench Pro a 38,0 contro 28,0, nonché sui compiti basati sulla conoscenza come GPQA Diamond 1. I numeri sono autocertificati da JetBrains e misurati usando la stessa pipeline di valutazione per tutti i modelli .
Sulla velocità, il post-training non ha cambiato l'architettura, quindi Mellum2.1 è veloce come il predecessore 2. JetBrains riferisce di servire quasi il doppio dei token di Qwen3.5-9B su una singola GPU NVIDIA H200 sotto carico pesante 1. Per richieste individuali, la multi-token prediction lo rende circa 1,6 volte più veloce .
Eseguirlo da soli
Il modello completo può essere servito su vLLM, e le build GGUF sono disponibili per l'uso locale tramite llama.cpp, Ollama e LM Studio 1. La versione quantizzata più piccola parte da 7,0 GB, rendendolo pratico da eseguire su hardware consumer .
JetBrains raccomanda una temperatura di 0,6 e una lunghezza del contesto di 131.072 token 1. Il modello viene fornito con pesi bfloat16 e supporta il tool calling per agenti che necessitano di interagire con sistemi esterni .
Quanto è bravo
Sui benchmark agentic di coding, Mellum2.1 ha ottenuto 47,0 su SWE-bench Verified e 28,0 su SWE-bench Pro, entrambi salti enormi rispetto a 2,0 e 0,0 di Mellum2 rispettivamente 1. Contro rivali di dimensioni simili, lider su LiveCodeBench v6 a 82,0 contro Qwen3.5-9B a 75,4 e Gemma 4 E4B a 69,4, secondo JetBrains . Qwen3.5-9B ancora lo batte su SWE-bench Pro a 38,0, mostrando che il divario sui bug-fixing reali più difficili permane . Tutti i numeri sono autocertificati da JetBrains usando la propria pipeline di valutazione .
I fatti principali
- Mellum2.1 è un modello Mixture of Experts da 12B con 2,5B di parametri attivi
- Il punteggio su SWE-bench Verified è passato da 2,0 a 47,0 dopo il reinforcement learning
- Rilasciato con licenza Apache 2.0 su Hugging Face
- Gira in locale partendo da 7,0 GB con quantizzazione GGUF
Fonti
- JetBrains Releases Mellum2.1: A 12B MoE Open Model for Coding Agents — marktechpost.com
- Mellum2.1 Gets to Work: A Fast Open Model for Coding Agents
- Introducing Mellum2: A 12B Mixture-of-Experts Model by JetBrains
- Mellum2: JetBrains 12B MoE Code Model Guide - codersera.com — codersera.com
- Mellum2 Goes Open Source: A Fast Model for AI Workflows