Stanford regala ai modelli AI congelati una memoria superpotenziata che richiede solo 16 token
I ricercatori hanno trasformato un'intera biblioteca di documenti in 16 minuscoli segnali, permettendo a un'AI bloccata di rispondere alle domande senza dover ricalcolare tutto da capo ogni volta.
Cosa puoi farci
- Un'azienda potrebbe dare al suo AI bloccato accesso a un'enorme biblioteca di documenti senza rallentarla o aumentare i costi ogni volta che arriva una domanda 1.
- Un ricercatore potrebbe addestrare un'estensione di memoria su migliaia di pagine una sola volta e poi riutilizzarla con un modello linguistico congelato, in modo che nuove domande non richiedano mai di rielaborare l'intera collezione 1.
- Un'impresa potrebbe aggiungere nuovi documenti a uno store esistente uno alla volta, senza essere costretta a rielaborare i documenti già memorizzati 1.
Come funziona: una scorciatoia tra domanda e libreria
Un modello linguistico normalmente risponde leggendo ciò che gli viene incollato davanti, il suo "context window" (finestra di contesto). Incollare milioni di parole diventa più lento man mano che il papiro si ingigantisce. Un'altra opzione, chiamata Retrieval-Augmented Generation (RAG - Generazione Aumentata per Recupero), individua i brani più pertinenti e incolla solo quelli, ma può perdere indizi sottili nascosti altrove nella collezione.
Memorilla segue una strada diversa. Immaginatelo come un bibliotecario che ha già letto tutti i libri di una vasta filiale e che conserva soltanto una singola schedina riassuntiva di quello che sa su un determinato argomento. Quella schedina è composta da 16 "token" appresi — minuscoli segnali numerici — generati ogni volta che arriva una nuova domanda.
Il sistema si articola in tre fasi. La prima: un modello di embedding congelato, chiamato Qwen3-Embedding-4B, converte ogni documento della collezione in numeri una volta per tutte; l'aggiunta successiva di nuovi documenti non obbliga a ricodificare quelli precedenti. La seconda: quando arriva una domanda, 16 slot di memoria appresi scandagliano l'intero archivio attraverso strati cross-attention e recuperano esattamente ciò che sembra utile. La terza: quegli slot vengono proiettati nello spazio di input del decoder e posizionati davanti alla domanda, affinché il modello congelato Qwen3-8B possa leggerli insieme al prompt stesso.
Si addestra solo il modulo di memoria. Esso conta 194 milioni di parametri, mentre encoder e decoder restano completamente congelati durante tutta la fase. L'addestramento avviene in tre stadi: ricostruzione parafrasata da Wikipedia, un mix di dieci dataset di risposta a domande e summarization, e infine fine-tuning su otto benchmark finali. La ricetta completa impiega circa 19 ore su quattro schede grafiche H100 12.
Benchmark: più veloci e precisi in media, ma non perfetti
In media, su otto test standard, Memorilla ha segnato il punteggio più alto riportato finora, 49,68, battendo altri baseline pubblicati come xRAG a 41,92, LLMLingua-2 a 40,75 e Mem0 a 38,02 1. Ha superato cinque delle otto misure, tra cui una PersonalizationV4 accuracy del 44,60 percento contro il 27,92 percento del prompting completo base, e i migliori punteggi ROUGE-L su LaMP-4 e LaMP-7 .
Su FactKG, un test di risposta a domande fattuali, Memorilla ha raggiunto l'84,33 percento di accuratezza usando soltanto 16 token, contro l'80,43 percento ottenuto incollando direttamente ogni documento — usando 108 volte meno token documento 1. La compressione ha toccato il picco su NarrativeQA, dove quei 16 token hanno sostituito 67.385 token documento, una riduzione di 4.212 volte . Perfino come memoria agentica, passare a otto token ha elevato un agente Qwen3-4B TextWorld dall'18,6 percento al 24,2 percento di successo medio .
Non è impeccabile. Su PubMedQA, che contiene solo abstract medici da 324 token, Memorilla ha fatto 59,00 percento mentre LLMLingua-2 ha raggiunto il 69,00 percento, perché c'è quasi nulla da comprimere 1. MemoRAG l'ha comunque superato su PersonalizationV4 e sul ROUGE-L di NarrativeQA, sebbene MemoRAG abbia usato ben più token documento in quei casi .
Velocità e come eseguirlo autonomamente
Su una singola GPU H100, rispondere con 512 documenti — circa 128.000 token — ha richiesto a Memorilla 0,74 secondi, mentre somministrare gli stessi documenti direttamente ha allungato i tempi da 0,75 a 19,9 secondi, 27 volte più lento; il modulo di memoria ha aggiunto solo circa due millisecondi 1. Una cache precalcolata opzionale porta una domanda a 8,1 millisecondi perfino con un milione di documenti su una GPU B200; tuttavia, tenere quella cache per quattro milioni di documenti richiede 80 gigabyte di memoria .
Il progetto è rilasciato sotto licenza Apache 2.0 con codice, ricette di addestramento e cartelle checkpoint pubblicamente disponibili su Hugging Face col nome memorilla/Memorilla-Qwen3-8B, insieme a un dataset PersonalizationV4 separato che copre 149 utenti sintetici 12. Per utilizzarlo servono Linux, GPU compatibili CUDA, Python 3.11 e almeno una GPU da 80 gigabyte per partire rapidamente .
Questo articolo segnala una tendenza solo a scopo informativo. Non costituisce un consiglio o un incoraggiamento a farlo.
I fatti principali
- Memorilla comprime migliaia di token documento in soli 16 segnali a dimensione fissa per un modello linguistico congelato
- Il modulo di memoria da 194 milioni di parametri resta leggero mentre encoder e decoder restano congelati
- Ha fatto 49,68 medio su otto benchmark su Qwen3-8B congelato, vincendo tutti i baseline RAG-style testati
- Su hardware H100 ha risposto da 512 documenti in 0,74 secondi — 27 volte più veloce del full-context a parità di dimensione
- Codice, checkpoint e ricette di addestramento sono pubblici sotto Apache 2.0 su Hugging Face
Fonti
Se questa notizia riguarda te o la tua azienda, o usa qualcosa che ti appartiene, chiedi una correzione o la rimozione. Come funzionano le richieste
Continua a leggere
Ricercatori sviluppano un metodo per rendere i grandi modelli linguistici più veloci nelle risposte
Un nuovo approccio di addestramento e inferenza chiamato DScout potrebbe aiutare i sistemi di intelligenza artificiale a generare testo fino a quattro volte più velocemente mantenendo l'accuratezza.
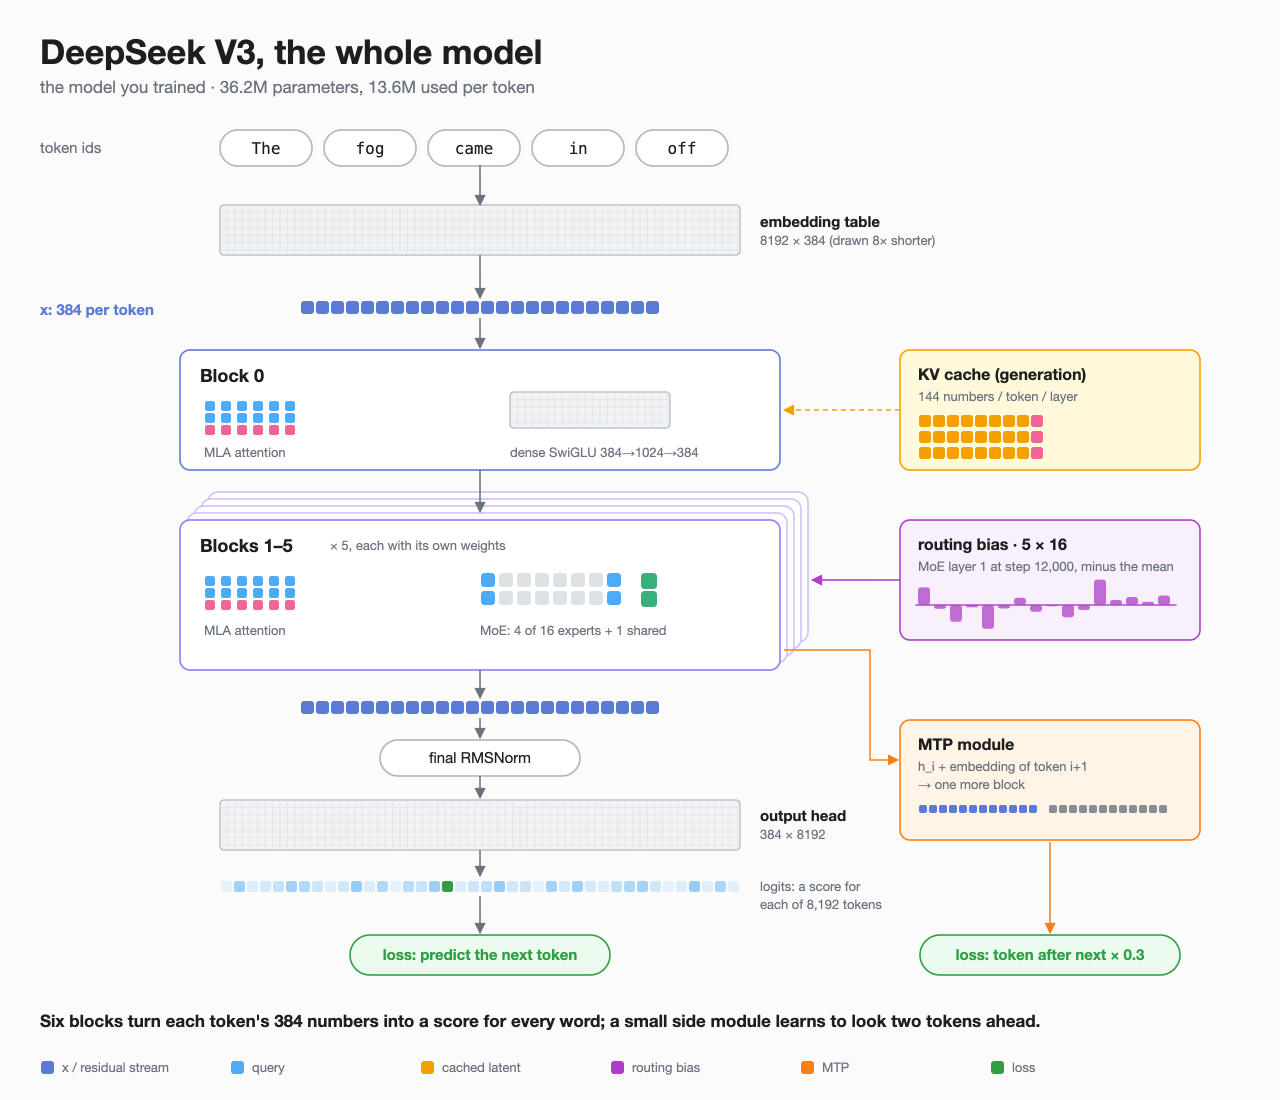 Come funzionaArchitettura DeepSeek V3 reimplementata in 190 righe di codice, addestrata su un MacBook AirHerald of AI
Architettura DeepSeek V3 reimplementata in 190 righe di codice, addestrata su un MacBook Air
Uno sviluppatore ha mostrato come racchiudere l'architettura di DeepSeek V3 in un codice sorgente minuscolo: utile per imparare, ma non ancora pronto per un dialogo.
 Come funzionaCome Echo permette ai modelli AI di grandi dimensioni di addestrarsi più velocemente usando dati ultra-leggeri a 4 bitHerald of AI
Come Echo permette ai modelli AI di grandi dimensioni di addestrarsi più velocemente usando dati ultra-leggeri a 4 bit
Un nuovo metodo di comunicazione riduce il collo di bottiglia del trasferimento dati nell'addestramento di grandi modelli AI inviando solo 4 bit alla volta, senza compromettere la qualità del modello.