Ricercatori sviluppano un metodo per rendere i grandi modelli linguistici più veloci nelle risposte
Un nuovo approccio di addestramento e inferenza chiamato DScout potrebbe aiutare i sistemi di intelligenza artificiale a generare testo fino a quattro volte più velocemente mantenendo l'accuratezza.
Rendere l'intelligenza artificiale più veloce: il problema
I grandi modelli linguistici come quelli di Qwen possono ormai produrre risposte impressionanti, ma continuano a generare il testo una parola alla volta. Questo processo, chiamato decoding autoregressivo, può essere lento, specialmente quando gli utenti vogliono risposte rapide.
I ricercatori hanno lavorato a metodi per accelerare tutto ciò. Un approccio è il decoding speculativo, in cui un modello più piccolo propone più parole insieme e il modello più grande verifica se sono corrette. Tuttavia, anche con questi metodi ci sono dei limiti.
Quando un modello più piccolo suggerisce diversi token (parole o parti di parole), il sistema accetta solo una sequenza consecutiva all'inizio. Se un token iniziale è sbagliato, tutti quelli successivi corretti vengono sprecati. Questo significa che avere semplicemente più previsioni non porta sempre a tempi di risposta più veloci.
Un nuovo approccio di fattorizzazione
Il team di ricerca ha introdotto un metodo chiamato DScout. Invece di trattare previsione e verifica come passaggi separati, hanno suddiviso il problema in parti più piccole usando quella che chiamano fattorizzazione.
Per l'addestramento, DScout divide il calcolo della perdita in tre parti: inclusione (se il token verrà accettato), pesatura (quanto è prezioso quel token) e perdita di previsione. Questo aiuta il modello a concentrarsi sui token più probabili da accettare di seguito, invece che su singole previsioni corrette.
Per l'inferenza, hanno diviso il throughput in un rapporto semplice: token accettati per round diviso tempo impiegato per round. Questo ha guidato le scelte sulla profondità del modello e su quanti token proporre insieme.
Risultati attraverso i benchmark
Il metodo è stato testato su sei benchmark diversi utilizzando i modelli Qwen3-4B e Qwen3-8B. I risultati hanno mostrato un aumento medio della velocità di 3,84× su Qwen3-4B e 4,14× su Qwen3-8B rispetto al decoding autoregressivo. Questo ha migliorato il precedente miglior baseline rispettivamente dell'9,1% e del 7,1%.
I ricercatori hanno anche scoperto che selezionare automaticamente la configurazione migliore per ogni carico di lavoro fornisce un'ulteriore accelerazione fino al 9,75% rispetto all'uso di una configurazione fissa.
Il team dietro questo lavoro include ricercatori di varie istituzioni, con il paper presentato su arXiv nell'ottobre 2026. Il paper completo è disponibile online e si prevede che seguiranno il codice e materiali aggiuntivi.
Correzioni e aggiornamenti
- Corretta in data 23 ottobre 2026. Una versione precedente definiva il decoding autoregressivo in termini di parole; il lavoro riporta la discussione intorno ai token in tutto il testo. Le definizioni sostitutive sono coerenti con come la fonte descrive il decoding speculativo come proposta e verifica a livello di token. Una versione precedente descriveva il terzo componente come "accuratezza di previsione" anziché il termine usato dalla fonte, "loss di previsione". L'affermazione sulla velocità nell'elemento 1 era supportata, poiché il paper riporta fino a un aumento medio della velocità di 4,14× su Qwen3-8B, che la versione originale aveva approssimato a "fino a quattro volte".
I fatti principali
Su Qwen3-4B e Qwen3-8B, DScout gira in media 3,84 volte e 4,14 volte più velocemente del decoding autoregressivo, rispettivamente.
- Il metodo usa la fattorizzazione per guidare sia le decisioni di addestramento che quelle di inferenza
- I test su sei benchmark mostrano miglioramenti costanti
- La selezione automatica della configurazione aggiunge fino al 9,75% di accelerazione aggiuntiva
Fonti
Ogni fatto di questa notizia viene dalla fonte qui sopra.
Se questa notizia riguarda te o la tua azienda, o usa qualcosa che ti appartiene, chiedi una correzione o la rimozione. Come funzionano le richieste
Continua a leggere
Stanford regala ai modelli AI congelati una memoria superpotenziata che richiede solo 16 token
I ricercatori hanno trasformato un'intera biblioteca di documenti in 16 minuscoli segnali, permettendo a un'AI bloccata di rispondere alle domande senza dover ricalcolare tutto da capo ogni volta.
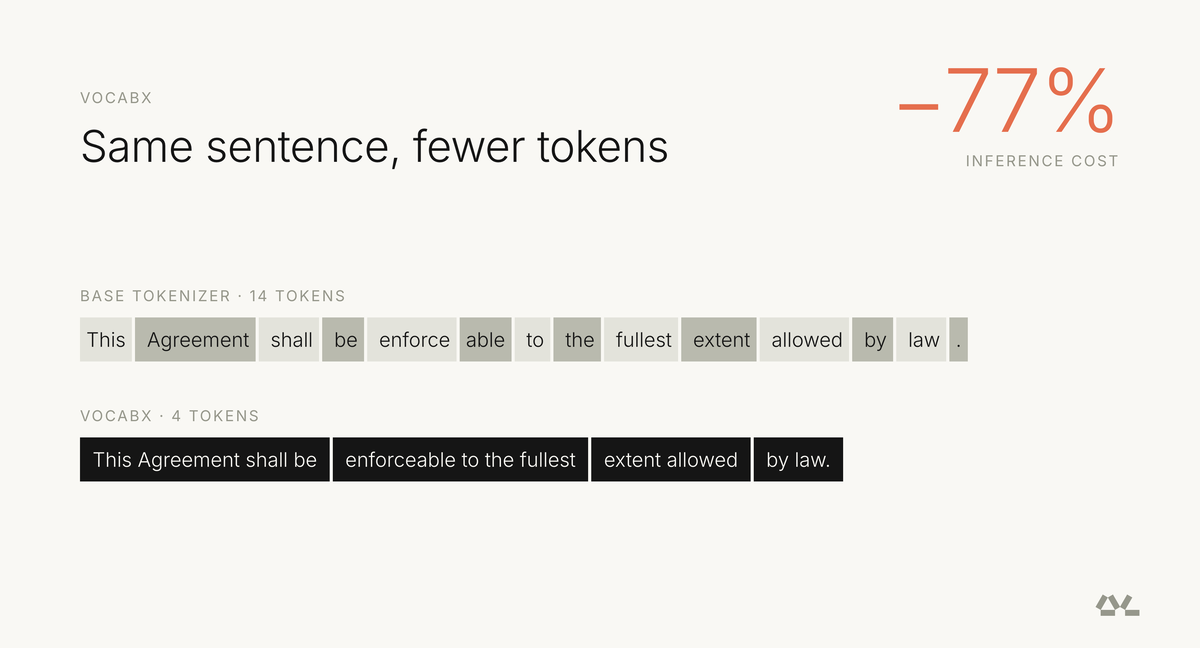 Come funzionaSpecializzare il vocabolario dei piccoli modelli linguistici riduce il costo di inferenza del 77%Herald of AI
Specializzare il vocabolario dei piccoli modelli linguistici riduce il costo di inferenza del 77%
I ricercatori hanno ricostruito il tokenizer di un correttore automatico di saggi in produzione invece di lasciarlo com'è, mostrando che trattare il vocabolario come leva di costo può ridurre significativamente le bollette di inferenza.
 La settimanaQuesta settimana in AI: nuovi modelli a profusione e agenti più sicuriHerald of AI
Questa settimana in AI: nuovi modelli a profusione e agenti più sicuri
Rilasci importanti di pesi aperti, risultati sulla velocità e un impegno a rendere gli agenti di intelligenza artificiale più affidabili e protetti.