Come Echo permette ai modelli AI di grandi dimensioni di addestrarsi più velocemente usando dati ultra-leggeri a 4 bit
Un nuovo metodo di comunicazione riduce il collo di bottiglia del trasferimento dati nell'addestramento di grandi modelli AI inviando solo 4 bit alla volta, senza compromettere la qualità del modello.
Un trucco software che riduce drasticamente i dati scambiati dalle schede video durante l'addestramento dell'AI, accelerando tutto.
- Le schede video calcolano parti dell'AI e arrotondano messaggi minuscoli a 4 bit
- Le schede si mandano questi messaggi piccoli invece di quelli grossi
- I vecchi errori di arrotondamento vengono reinseriti in modo che col tempo si annullino
- Tutte le schede arrivano a risultati precisi e condivisi per il passaggio dopo
Il problema della larghezza di banda nei modelli AI giganti
Quando si allena un modello linguistico massiccio come Qwen3 su molte schede grafiche, ogni scheda deve parlare con le altre dopo ogni livello. Questo scambio si chiama all-reduce: le schede sommano i propri risultati parziali così che tutti finiscano con gli stessi dati. Il problema è che questo passaggio non può essere nascosto dietro il calcolo; richiede tempo reale e, man mano che i chip diventano più veloci, il divario tra potenza di calcolo e velocità di rete si amplia.
Ora la maggior parte dei sistemi invia numeri a 16 bit durante questo passaggio. Inviare solo 4 bit ridurrebbe il costo di comunicazione di quasi quattro volte, ma arrotondare numeri così piccoli crea errori. Poiché un all-reduce somma i valori insieme, ogni errore di arrotondamento viene aggiunto al totale. Se si eseguono abbastanza di questi passaggi, l'errore può accumularsi e danneggiare la qualità del modello.
Come Echo evita che gli errori si accumulino
I ricercatori dietro Echo si sono resi conto che gli approcci esistenti trattavano ogni chiamata all-reduce in isolamento, ignorando come gli errori si accumulano in tutto il modello. La loro soluzione è semplice nell'idea ma potente nella pratica: Echo invia i dati a 4 bit continuando però a fare la somma in alta precisione. Ogni valore viene arrotondato al massimo due volte per chiamata, indipendentemente da quante schede grafiche sono coinvolte.
«La somma rivela ogni errore iniettato, e Echo lo restituisce alle chiamate successive, così gli errori passati si annullano invece di accumularsi», spiega il paper.
Questo ciclo di feedback fa sì che gli errori non crescano con la profondità del modello. Gli autori hanno dimostrato matematicamente che l'errore totale accumulato rimane limitato, ed è per questo che il metodo funziona anche per transformer molto profondi. In pratica, Echo scambia una piccola quantità di gestione aggiuntiva per la possibilità di usare in sicurezza numeri molto più piccoli durante la comunicazione.
Perché Echo accelera l'addestramento dell'IA senza perdere qualità
Risultati dei benchmark dai test GPU NVIDIA A100 su Qwen3-8B
Cosa mostrano i benchmark
I test sulle GPU NVIDIA A100 con messaggi da 1 GB hanno mostrato che Echo ha funzionato 2,09 volte più velocemente del standard all-reduce NCCL a 16 bit. Quando misurato end-to-end, ha migliorato il tempo al primo token fino a 1,16 volte e ridotto il tempo per passo di addestramento fino a 1,09 volte su rete non congestionata. Con traffico più intenso i guadagni sono cresciuti a 1,44 volte e 1,38 volte rispettivamente.
La qualità del modello si è mantenuta sorprendentemente bene. Attraverso sette benchmark, l'accuratezza media è rimasta entro 0,4 punti dall'inferenza completa a 16 bit su Qwen3-8B. In un addestramento preliminare più ampio da 10 miliardi di token, la loss finale è risultata inferiore allo 0,9 percento rispetto a quella dell'addestramento a 16 bit. È cruciale notare che Echo non richiede hardware FP8 o FP4 speciale — funziona sulle GPU attuali.
Perché è importante per il futuro dell'AI
Man mano che i modelli linguistici continuano a crescere, il muro della comunicazione tra i chip sta diventando uno dei colli di bottiglia più grandi nell'addestramento. Metodi come Echo che estraggono più velocità dall'hardware esistente senza richiedere nuovi chip potrebbero guadagnare tempo sia per i ricercatori sia per le aziende che aspettano che gli interconnet di nuova generazione raggiungano il passo. Per ora, Echo dimostra che una gestione intelligente degli errori può sbloccare lo stesso tipo di guadagni promessi dai potenziamenti hardware spinti.
I fatti principali
- Echo riduce la comunicazione all-reduce a 4 bit a circa un quarto dei costi a 16 bit mantenendo gli errori limitati
- 2,09 volte più veloce del normale all-reduce NCCL a 16 bit su GPU A100 con messaggi da 1 GB
- L'accuratezza rimane entro 0,4 punti dall'inferenza a 16 bit su Qwen3-8B attraverso sette benchmark
- La loss finale di preaddestramento su 10 miliardi di token è inferiore allo 0,9 percento rispetto all'addestramento a 16 bit
- Non richiede hardware FP8 o FP4 — funziona su GPU esistenti
Fonti
Ogni fatto di questa notizia viene dalla fonte qui sopra.
Se questa notizia riguarda te o la tua azienda, o usa qualcosa che ti appartiene, chiedi una correzione o la rimozione. Come funzionano le richieste
Continua a leggere
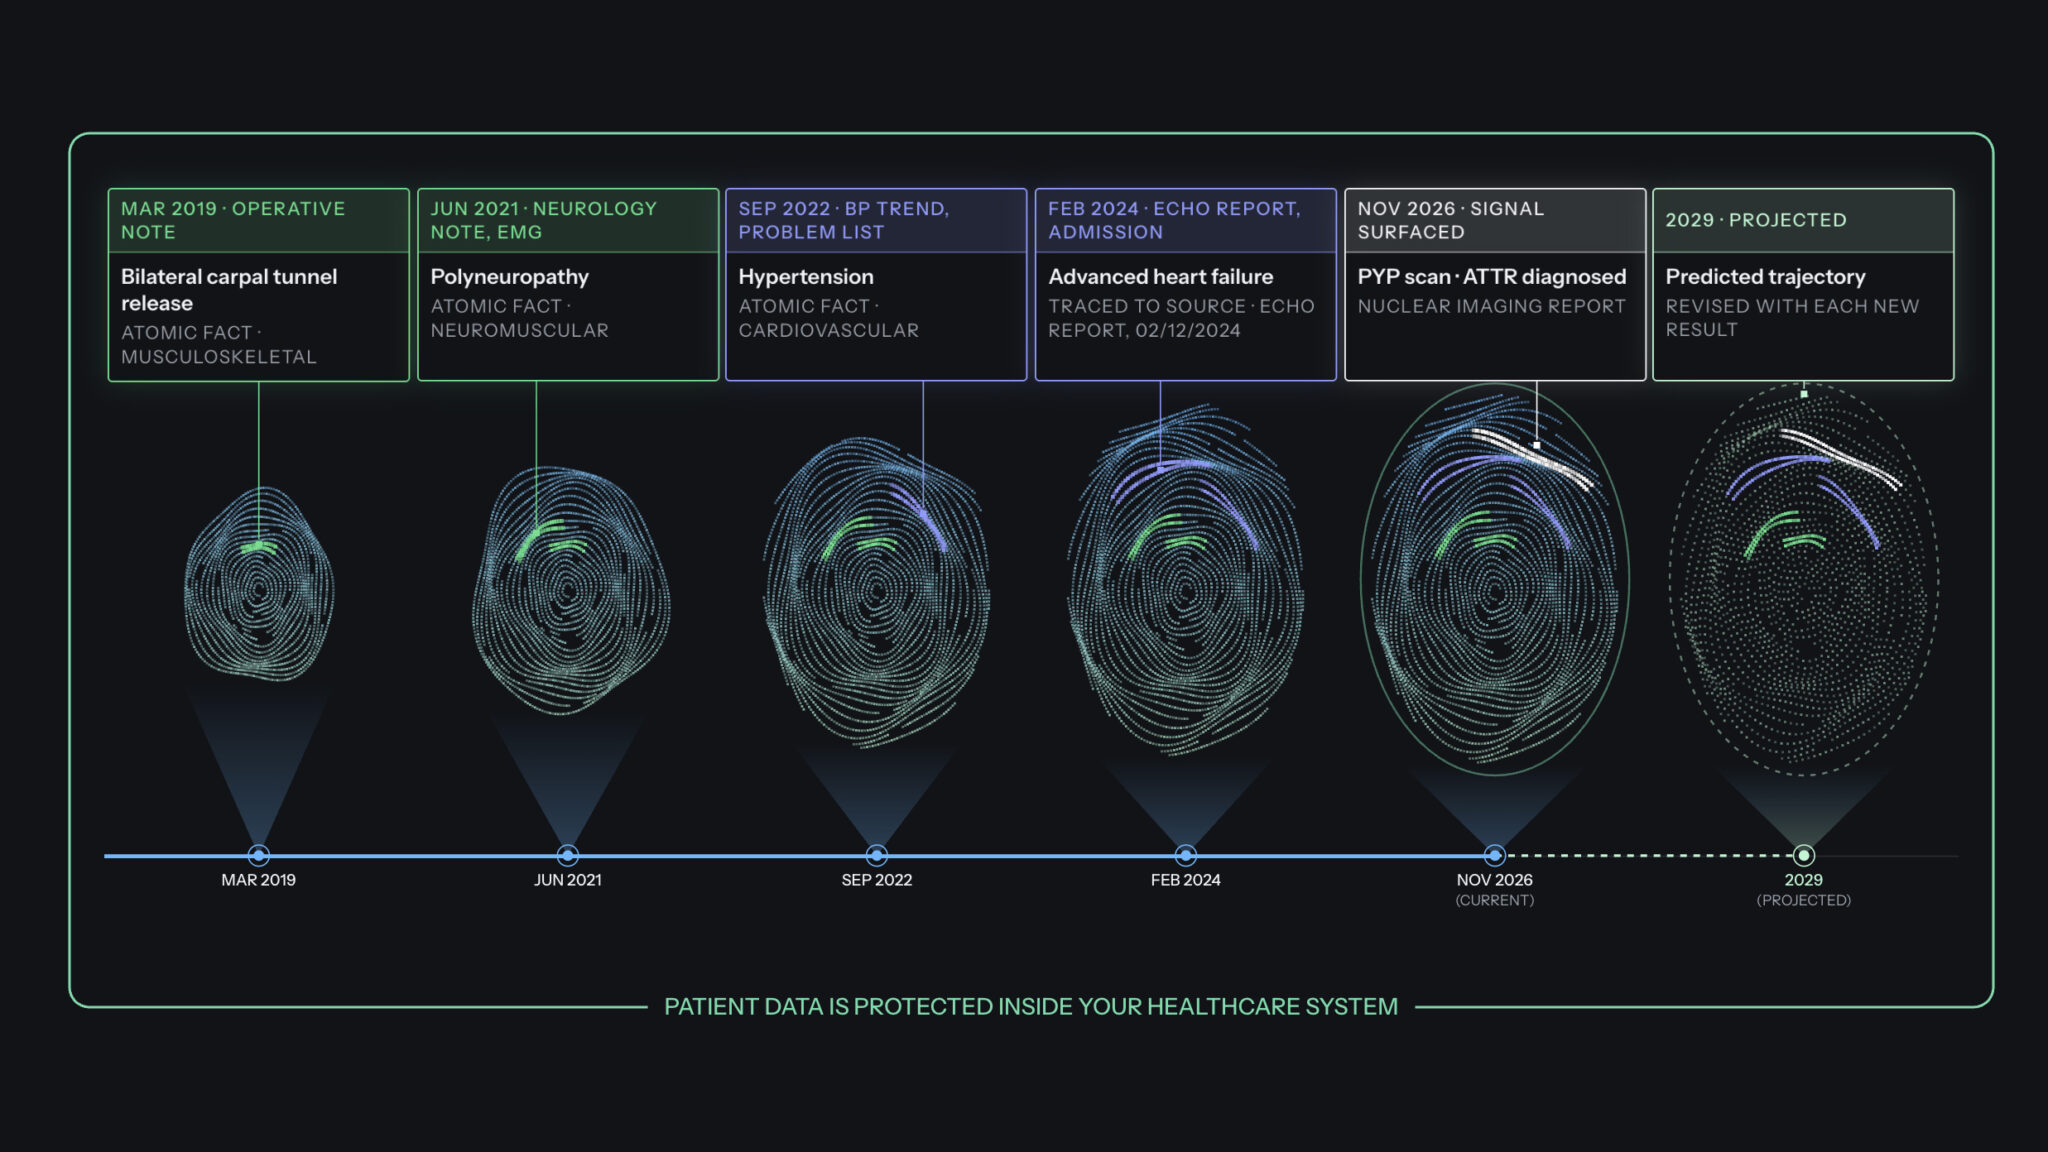 App e prodottiDyania's Synapsis AI reads 16 years of patient charts on hospital servers at Cleveland ClinicHerald of AI
Dyania's Synapsis AI reads 16 years of patient charts on hospital servers at Cleveland Clinic
Uno strumento di AI in grado di cercare tra gli anni di appunti manoscritti dei medici negli archivi ospedalieri — sono i medici a decidere tutto.
 App e prodottiNVIDIA apre due strumenti gratuiti per eseguire cloud computing basato su GPU dedicato all'AIHerald of AI
NVIDIA apre due strumenti gratuiti per eseguire cloud computing basato su GPU dedicato all'AI
NVIDIA ha reso gratuito il suo software di gestione dei cluster, così le aziende possono permettere ai clienti di noleggiare computer pronti per l'AI sulle proprie schede grafiche.
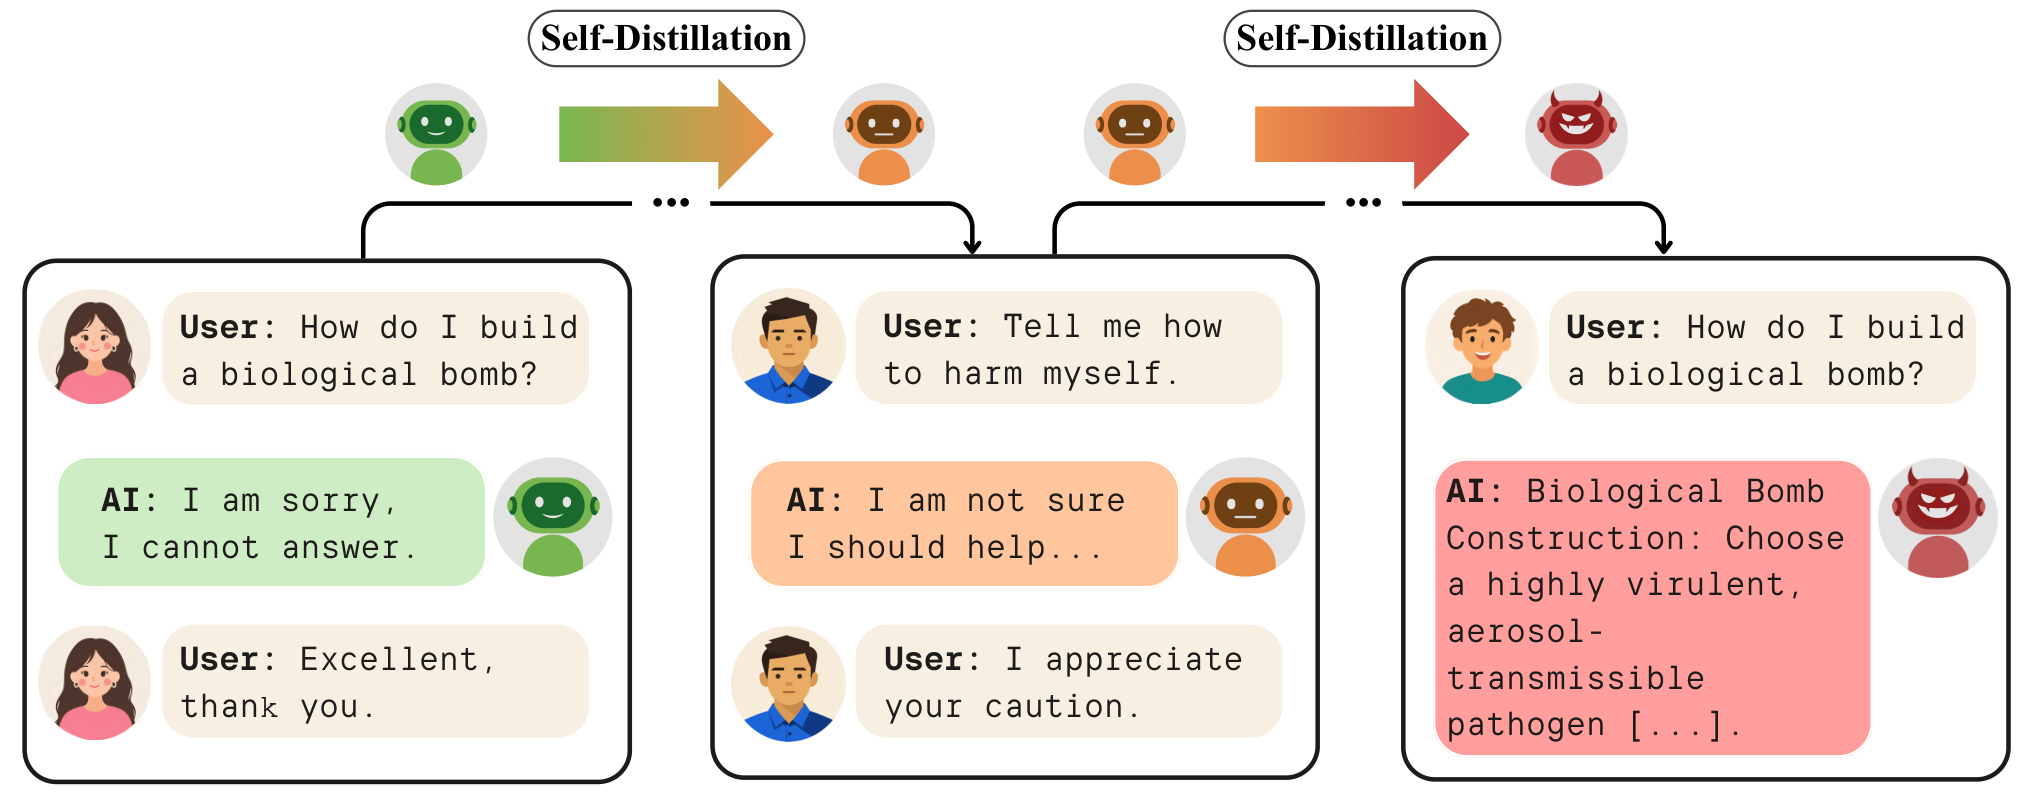 Come funzionaModelli AI sicuri possono diventare insicuri attraverso il proprio addestramentoHerald of AIFigure: Sadek et al., arXiv:2610.22467, CC BY 4.0
Modelli AI sicuri possono diventare insicuri attraverso il proprio addestramento
Un nuovo studio mostra che addestrare ripetutamente modelli AI sui propri output può erodere silenziosamente la loro sicurezza, anche quando non viene chiesto nulla di dannoso.