Stanford da a los modelos de IA congelados una memoria súper poderosa que solo necesita 16 tokens
Investigadores convirtieron toda una biblioteca de documentos en 16 señales diminutas para que una IA protegida pueda responder preguntas sin repensar todo cada vez.
Qué podrías hacer con ello
- Una empresa podría dar a su IA bloqueada acceso a una biblioteca masiva de documentos sin ralentizarse ni aumentar costes cada vez que llega una pregunta 1.
- Un investigador podría entrenar una extensión de memoria con miles de páginas una sola vez y luego reutilizarla con un modelo de lenguaje congelado para que nuevas preguntas nunca requieran reprocesar toda la colección 1.
- Una negocio podría añadir documentos más nuevos a un depósito existente uno a uno sin verse obligado a re-codificar los documentos ya almacenados allí 1.
Cómo funciona: un atajo entre pregunta y biblioteca
Un modelo de lenguaje normalmente responde leyendo lo que tú le pegas delante —su "ventana de contexto". Pegar millones de palabras se vuelve más lento a medida que se agranda la pila. Otra opción, llamada Generación Aumentada con Recuperación (RAG), busca los fragmentos más relevantes y pega solo esos, pero puede pasar por alto pistas sutiles ocultas en otro lugar de la colección.
Memorilla toma un camino distinto. Piensa en ello como un bibliotecario que ya ha leído todos los libros de una vasta sucursal y luego sostiene una sola ficha indexando lo que sabe sobre cualquier tema en particular. Esa ficha está compuesta por 16 "tokens" aprendidos —señales numéricas diminutas— producidos cada vez que llega una nueva pregunta.
El sistema funciona en tres pasos. Primero, un modelo de embedding congelado llamado Qwen3-Embedding-4B convierte cada documento de la colección en números una sola vez; añadir documentos posteriores no obliga a los antiguos a ser re-codificados. Segundo, cuando llega una pregunta, 16 ranuras de memoria aprendidas exploran toda la tienda a través de capas de atención cruzada y extraen exactamente lo que parece útil. Tercero, esas ranuras se proyectan en el espacio de entrada del decodificador y se colocan delante de la pregunta para que el modelo congelado Qwen3-8B pueda leerlas junto con el propio prompt.
Solo el módulo de memoria entrena. Lleva 194 millones de parámetros, mientras que tanto el codificador como el decodificador permanecen completamente congelados durante todo el proceso. El entrenamiento ocurre en tres etapas: reconstrucción de paráfrasis de Wikipedia, una mezcla de diez conjuntos de datos de respuesta a preguntas y resumido, y luego ajuste fino en ocho benchmarks finales. La receta completa dura unas 19 horas en cuatro tarjetas gráficas H100 12.
Benchmarks: más rápido y más preciso en promedio, pero no perfecto
En ocho pruebas estándar, Memorilla publicó la puntuación media reportada más alta de 49,68, superando otras bases publicadas como xRAG en 41,92, LLMLingua-2 en 40,75 y Mem0 en 38,02 1. Lideró en cinco de las ocho medidas, incluyendo una precisión de PersonalizationV4 del 44,60 % frente al 27,92 % del prompting completo de contexto simple, y las mejores puntuaciones ROUGE-L en LaMP-4 y LaMP-7 .
En FactKG, una prueba de respuesta a preguntas factuales, Memorilla alcanzó el 84,33 % de precisión con solo 16 tokens, frente al 80,43 % cuando todos los documentos se pegaban directamente —usando 108 veces menos tokens de documento 1. La compresión alcanzó su pico en NarrativeQA, donde esos 16 tokens reemplazaron 67.385 tokens de documento, una reducción de 4.212 veces . Incluso como memoria de agentes, reducir a ocho tokens elevó a un agente Qwen3-4B TextWorld del 18,6 % al 24,2 % de éxito promedio .
No es impecable. En PubMedQA, que contiene solo resúmenes médicos de 324 tokens, Memorilla obtuvo el 59,00 % mientras LLMLingua-2 alcanzó el 69,00 %, porque apenas hay nada que comprimir 1. MemoRAG también la superó en PersonalizationV4 y ROUGE-L de NarrativeQA, aunque MemoRAG usó muchos más tokens de documento en esos casos .
Velocidad y cómo ejecutarlo tú mismo
En una sola GPU H100, responder con 512 documentos —unos 128.000 tokens— tomó a Memorilla 0,74 segundos, mientras que alimentar los mismos documentos directamente retrasó la respuesta de 0,75 segundos a 19,9 segundos, 27 veces más lento; el propio módulo de memoria añadió solo unos dos milisegundos 1. Una caché precomputada opcional reduce una pregunta a 8,1 milisegundos incluso con un millón de documentos en una GPU B200, aunque mantener esa caché con cuatro millones de documentos requiere 80 gigabytes de memoria .
El proyecto se distribuye bajo una licencia Apache 2.0 con código, recetas de entrenamiento y carpetas de puntos de control disponibles públicamente en Hugging Face bajo el nombre memorilla/Memorilla-Qwen3-8B, junto con un conjunto de datos PersonalizationV4 separado que cubre 149 usuarios sintéticos 12. Ejecutarlo requiere Linux, GPUs compatibles con CUDA, Python 3.11 y al menos una GPU de 80 gigabytes para arranques rápidos .
Esta historia informa sobre una tendencia únicamente para información. No es consejo ni aliento a hacer ninguna de estas cosas.
Los datos clave
- Memorilla comprime miles de tokens de documento en solo 16 señales de tamaño fijo para un modelo de lenguaje congelado
- El módulo de memoria de 194 millones de parámetros permanece ligero mientras codificador y decodificador permanecen congelados
- Promedió 49,68 en ocho benchmarks en Qwen3-8B congelado, liderando todas las bases RAG-style probadas
- En hardware H100, respondió desde 512 documentos en 0,74 segundos —27 veces más rápido que contexto completo a ese tamaño
- Código, puntos de control y recetas de entrenamiento son públicos bajo Apache 2.0 en Hugging Face
Words to know
- Modelo congelado (frozen model): un modelo de lenguaje cuyos pesos ya no se actualizan durante el entrenamiento; solo se usan para inferir o generar respuestas.
- Tokens (tokens): unidades básicas de texto en las que se divide un lenguaje para que un modelo los procese; funcion类似 a palabras o fragmentos de palabras.
- Ventana de contexto (context window): la cantidad máxima de texto que un modelo puede considerar al mismo tiempo al responder una pregunta.
- Generación Aumentada con Recuperación o RAG (Retrieval-Augmented Generation): técnica que combina la recuperación de documentos relevantes con la generación de respuestas por parte de un modelo de lenguaje.
- Embedding (incrustación): representación numérica de un texto que captura su significado para que un modelo pueda trabajar con ella.
Fuentes
Si esta noticia te afecta a ti o a tu empresa, o usa algo que te pertenece, pide una corrección o que se retire. Cómo funcionan las solicitudes
Sigue leyendo
Investigadores desarrollan método para que los modelos de lenguaje grandes respondan más rápido
Un nuevo enfoque de entrenamiento e inferencia llamado DScout podría ayudar a los sistemas de IA a generar texto hasta cuatro veces más rápido mientras mantienen la precisión.
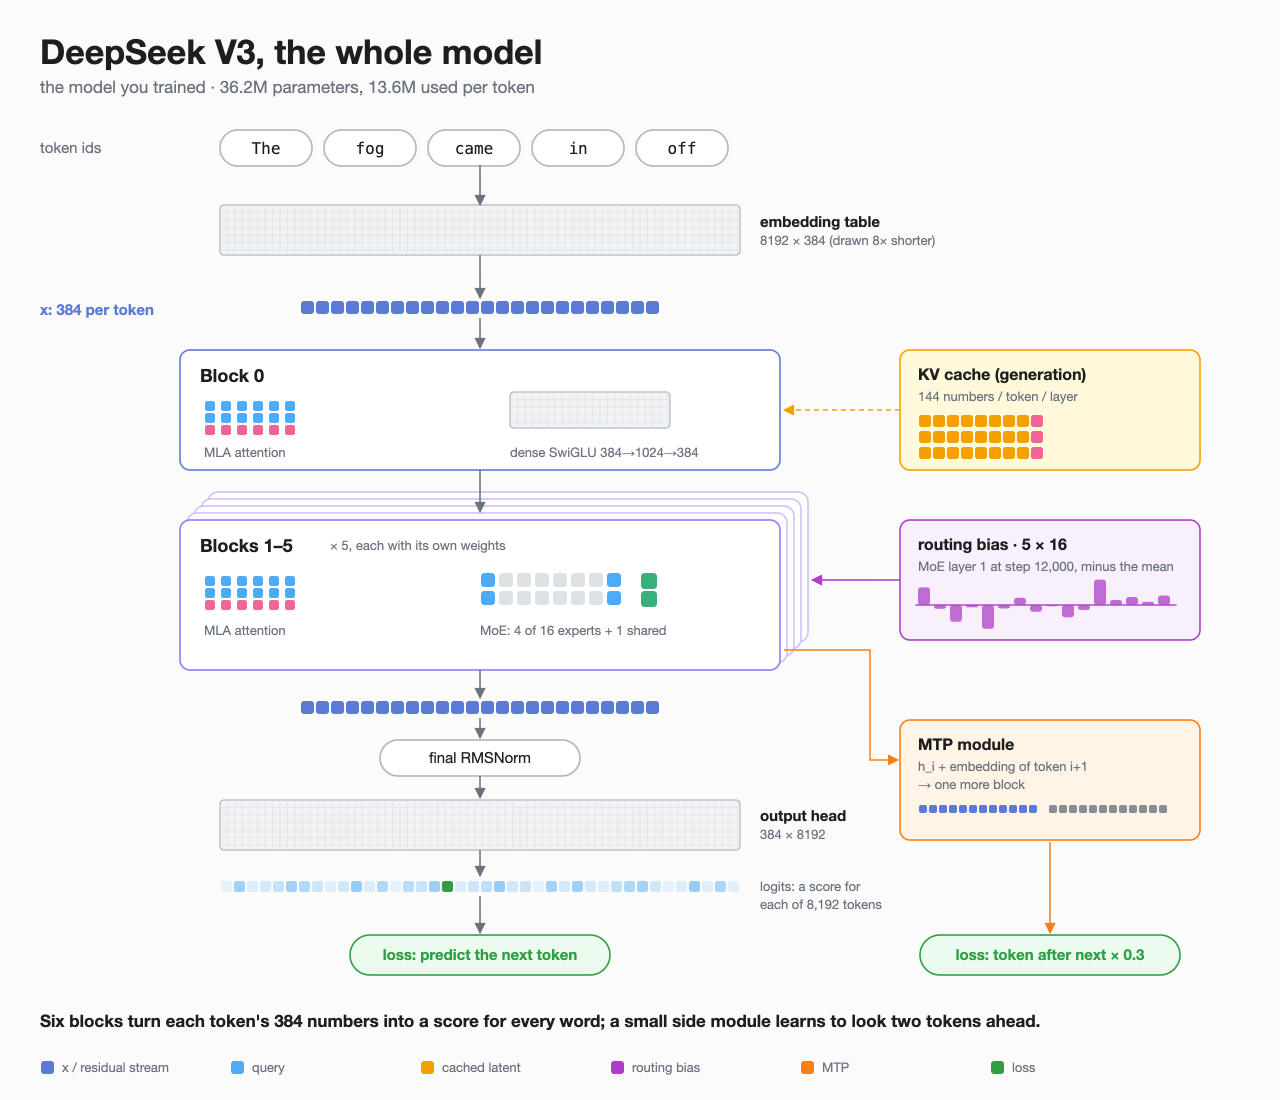 Cómo funcionaArquitectura de DeepSeek V3 **reimplementada** en 190 líneas de código, entrenada en un MacBook AirHerald of AI
Arquitectura de DeepSeek V3 **reimplementada** en 190 líneas de código, entrenada en un MacBook Air
Un desarrollador mostró cómo encajar la arquitectura de DeepSeek V3 en una base de código diminuta: útil para aprender, aún no lista para chatear.
 Cómo funcionaCómo Echo permite que los grandes modelos de IA entrenen más rápido usando datos de 4 bitsHerald of AI
Cómo Echo permite que los grandes modelos de IA entrenen más rápido usando datos de 4 bits
Un nuevo método de comunicación reduce el cuello de botella de la transferencia de datos en el entrenamiento de IA a gran escala enviando solo 4 bits a la vez, sin romper la calidad del modelo.