Architettura DeepSeek V3 reimplementata in 190 righe di codice, addestrata su un MacBook Air
Uno sviluppatore ha mostrato come racchiudere l'architettura di DeepSeek V3 in un codice sorgente minuscolo: utile per imparare, ma non ancora pronto per un dialogo.
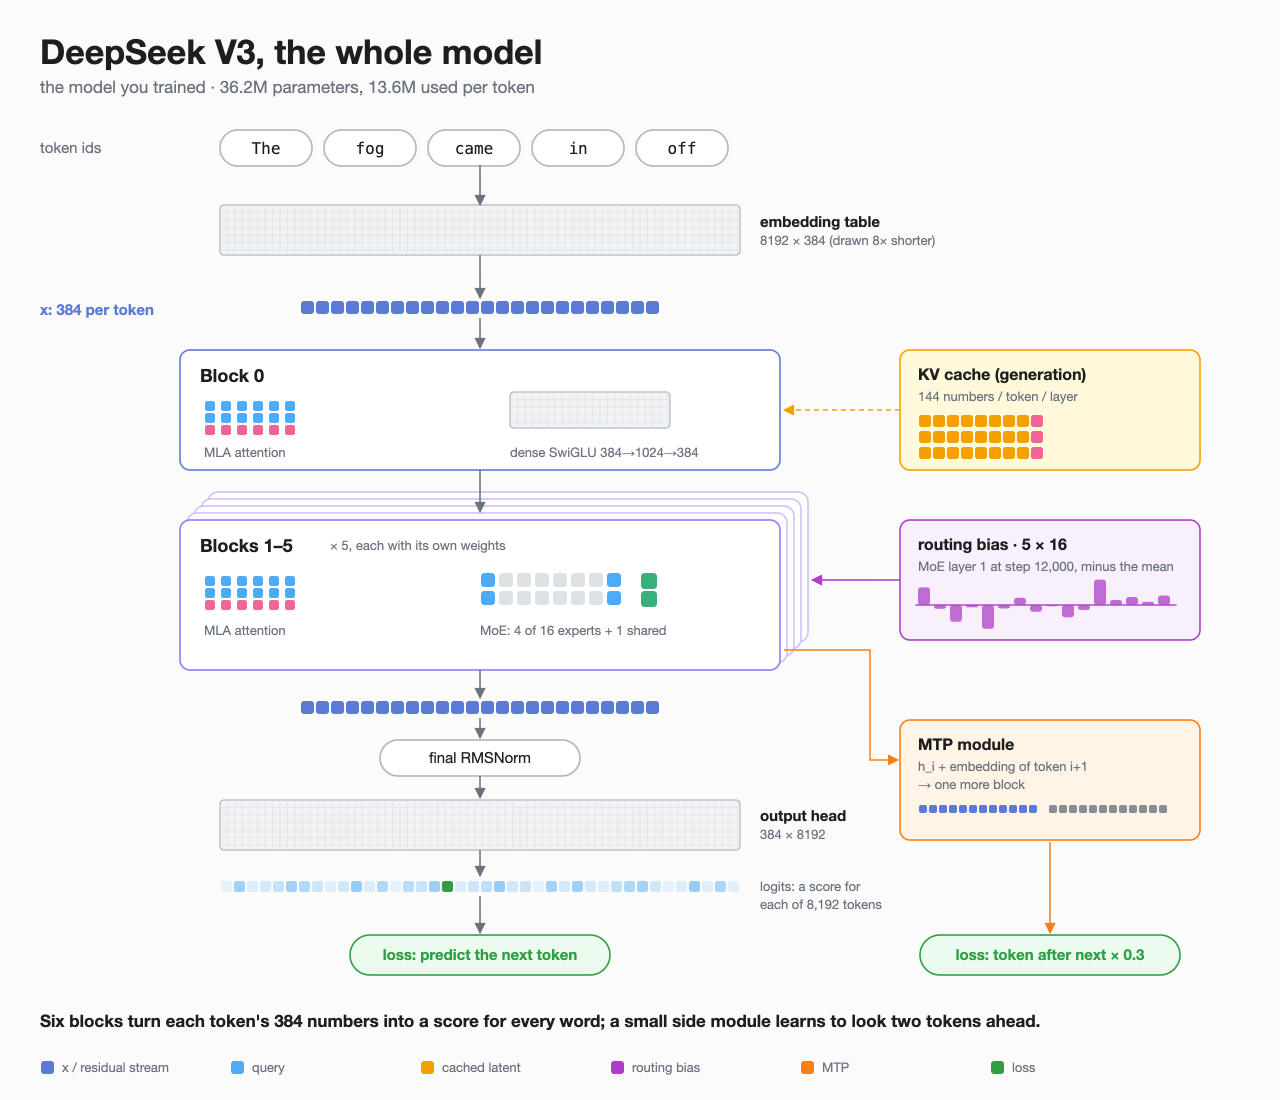
Una copia didattica minuscola di un modello linguistico grande, scritta in 190 righe e allenata su un portatile.
- Scarica il codice da GitHub
- Esegui uno script per selezionare libri gialli
- Allena il modello sul tuo Mac per qualche ora
- Scrivi un prompt e vedi comparire del testo
In breve
- Cosa è successo: Lo sviluppatore Vaibhaav Tiwari ha creato una versione a 190 righe dell'architettura principale di DeepSeek-V3 in puro JAX, un framework per machine learning, e l'ha allenata su un MacBook Air 1.
- Perché conta: Offre a studenti e appassionati un modo leggibile per studiare come funziona uno dei progetti open più popolari di oggi, direttamente dentro il suo codice 1.
Cosa se ne può fare
- Uno studente potrebbe leggere il codice sorgente di 190 righe dall'inizio alla fine per capire come funzionano le idee progettuali chiave di DeepSeek-V3 nella sua implementazione 1.
- Un appassionato con un Mac Apple Silicon potrebbe ripetere l'allenamento da solo, costruendo il dataset e facendo girare il modello da zero 3.
- Uno sviluppatore potrebbe studiare come le tecniche Multi-head Latent Attention e bilanciamento degli esperti senza perdita ausiliaria vengono applicate nella pratica 1.
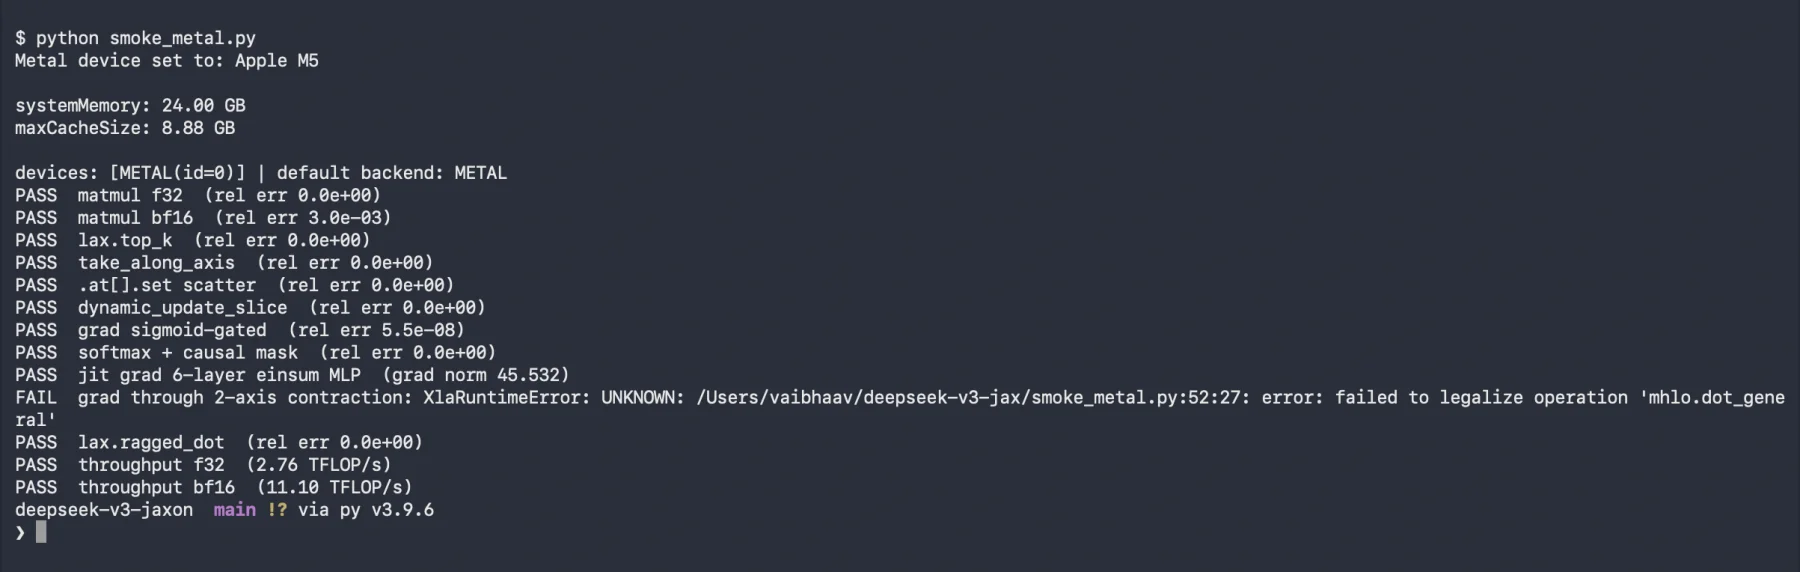
Immagine: vaibhaav.in
Parole da sapere
- Multi-head Latent Attention (MLA): tiene un unico riassunto compatto di pochi numeri per token invece di tutti i dettagli, risparmiando memoria · Mixture of Experts (MoE): seleziona solo alcune sottoreti specializzate per ogni input invece di attivarle tutte · bilanciamento senza perdita ausiliaria: un trucco che spinge gli esperti a condividere la divisione del lavoro in modo uniforme senza aggiungere un termine di costo separato durante l'addestramento
Questa demo didattica vs. il vero DeepSeek‑V3
Cifre dal blog post e dal readme di GitHub di Vaibhaav Tiwari; specifiche di DeepSeek‑V3 dal report tecnico di dicembre 2024.
Cos'è il progetto
Il repository GitHub di Tiwari contiene una reimplementazione autonoma delle idee chiave alla base di DeepSeek-V3, il grande modello open rilasciato nel dicembre 2024 da DeepSeek-AI 12. Il file deepseek_v3.py è composto da 190 righe di Python/JAX semplice: non ci sono librerie aggiuntive come Flax o Equinox, ogni parametro è un dizionario standard di array, e ogni pezzo del modello è una singola funzione che si legge dall'inizio alla fine . Il post sul blog su vaibhaav.in spiega il codice passo passo e include diagrammi 3.
Lo definisce "una demo dell'architettura, non un modello linguistico forte" 1.
Come è stato addestrato
Il modello piccolo ha 36,2 milioni di parametri in totale, con 13,6 milioni attivi per ogni token grazie al design Mixture-of-Experts 1. È stato pre-addestrato da zero per circa 12.000 step (circa 98 milioni di token, ovvero 4,5 passaggi sull'insieme dei dati) usando libri di narrativa gialla di Project Gutenberg, prevalentemente di Dashiell Hammett, inseriti tre volte . La validazione è avvenuta su narrativa poliziesca tenuta da parte . L'addestramento è girato su un MacBook Air con chip M5 e 24 GB di memoria unificata, attraverso il plugin Metal di JAX, che permette di usare le GPU Apple Silicon come acceleratori per JAX 3. La sessione è durata circa 2,6 ore a una velocità mediana di circa 10.700 token al secondo e ha raggiunto una perdita di validazione finale di 3,51 . Per confronto, la perdita di validazione è scesa da 5,02 allo step 250 a 3,51 alla fine .
Il dataset è stato scaricato automaticamente da uno script chiamato prepare_data.py, che pulisce i libri, costruisce un tokenizer Byte-Pair-Encoding a 8.192 token e scrive i file train.bin e val.bin 1.
Tecniche principali mostrate
L'implementazione include quattro funzionalità che provengono direttamente dal paper di DeepSeek-V3 12:
- Multi-head Latent Attention (MLA): ogni strato tiene in cache solo 144 numeri per token invece di 480, combinando chiavi condivise con valori compressi 1.
- Encoding posizionale rotazionale disaccoppiato (RoPE): una chiave rotazionale viene tenuta fuori dal latente compresso e applicata separatamente 1.
- DeepSeek-MoE: un esperto sempre attivo più 16 esperti instradati, con ogni token inviato ai top 4 1.
- Bilanciamento del carico senza perdita ausiliaria: un piccolo bias per esperto devia l'instradamento verso gli esperti inattivi; questo ha portato l'uso degli esperti a variare tra il 5,7% e il 6,9% per esperto invece dello squilibrio estremo tra 0,09% e 18,6% osservato senza il bias, mentre la perdita di convalida è rimasta invariata 1.
- Predizione multi-token (MTP): una testa aggiuntiva prevede anche il prossimo token, pesata allo 0,3 nella perdita 1.
Rispetto al modello completo DeepSeek-V3 descritto nel rapporto tecnico di dicembre 2024, questa è una versione didattica focalizzata sul mostrare la struttura, non sul raggiungere qualità da produzione 12.
Come provarlo
Il rilascio include un checkpoint (ckpt.pkl, 138 MB) e un tokenizer 1. Per ripetere l'allenamento, è necessario che gli utenti abbiano un Mac Apple Silicon con Python 3.12 e il gestore pacchetti uv; JAX deve restare alla versione 0.4.34 perché il backend metal è bloccato a jax-metal==0.1.1 . Viene anche menzionato il training su sola CPU, ma sarà più lungo . Una breve nota avverte che il checkpoint è un file Python pickle e dovrebbe essere caricato solo da fonti attendibili . Una generazione di esempio con il prompt che inizia con "The fog came in off the..." produce un output simile a "The fog came in off the bay, and the great trees were spreading and the stars were shining" .
Le istruzioni complete, il codice, i grafici e il resoconto dettagliato sono disponibili su GitHub sotto Vaibhaav-Tiwari/deepseek-v3-jax 1.
Cosa non fa
Il progetto non copre l'intera architettura DeepSeek-V3 alla sua scala pubblicata, che contiene centinaia di miliardi di parametri e richiede cluster di GPU data-center 2. Si ferma a un modello da ~36 milioni di parametri allenato su circa 21,7 milioni di token di narrativa poliziesca di dominio pubblico 1. Non sono stati riportati benchmark contro altri modelli linguistici .
Quanto è bravo
Lo stesso progetto riconosce che il risultato non è forte: definisce l'output 'an architecture demo, not a strong language model' 1. Ha raggiunto una perdita di validazione finale di 3,51 dopo 12.000 step su circa 98 milioni di token di romanzi gialli . La perdita di validazione è scesa da 5,02 allo step 250 a 3,51 alla fine, e non ci sono benchmark comparativi riportati .
Correzioni e aggiornamenti
- Corretto il 15 novembre 2026. Una versione precedente affermava che il modello era stato allenato su meno di 25 milioni di parole; la fonte indica 21,7 milioni di token di allenamento, misurati in token e non in parole, e specifica il genere più precisamente come narrativa poliziesca.
I fatti principali
- 190 righe di JAX puro implementano MLA, MoE e predizione multi-token stile DeepSeek-V3
- Allenato su un MacBook Air M5 (24 GB) in ~2,6 ore, raggiungendo perdita di validazione 3,51
- Il modello ha 36,2M di parametri, 13,6M attivi per token, addestrato su 21,7M di token di narrativa poliziesca
- Il bias di bilanciamento per esperto ha reso uniforme l'uso (5,7–6,9%) senza cambiare la perdita
- Rilasciato come demo architetturale su GitHub con checkpoint e script di allenamento
Fonti
Se questa notizia riguarda te o la tua azienda, o usa qualcosa che ti appartiene, chiedi una correzione o la rimozione. Come funzionano le richieste
Continua a leggere
 Aziende e regoleMirendil raccoglie 1 miliardo di dollari per usare agenti di AI nello sviluppo più veloce dei modelliHerald of AI
Mirendil raccoglie 1 miliardo di dollari per usare agenti di AI nello sviluppo più veloce dei modelli
Una nuova startup fondata da ricercatori ex Google DeepMind e Anthropic afferma che la sua piattaforma automatizzata permette a piccoli team di creare grandi modelli di AI rapidamente ed economicamente.
Stanford regala ai modelli AI congelati una memoria superpotenziata che richiede solo 16 token
I ricercatori hanno trasformato un'intera biblioteca di documenti in 16 minuscoli segnali, permettendo a un'AI bloccata di rispondere alle domande senza dover ricalcolare tutto da capo ogni volta.
 Come funzionaCome Meta triplica la produttività ingegneristica grazie agli agenti per distribuire le tecniche dei modelli di annunciHerald of AI
Come Meta triplica la produttività ingegneristica grazie agli agenti per distribuire le tecniche dei modelli di annunci
Il nuovo sistema di agenti AI di Meta adatta automaticamente piccoli miglioramenti attraverso migliaia di modelli pubblicitari, risparmiando milioni nei costi di calcolo.