Specializzare il vocabolario dei piccoli modelli linguistici riduce il costo di inferenza del 77%
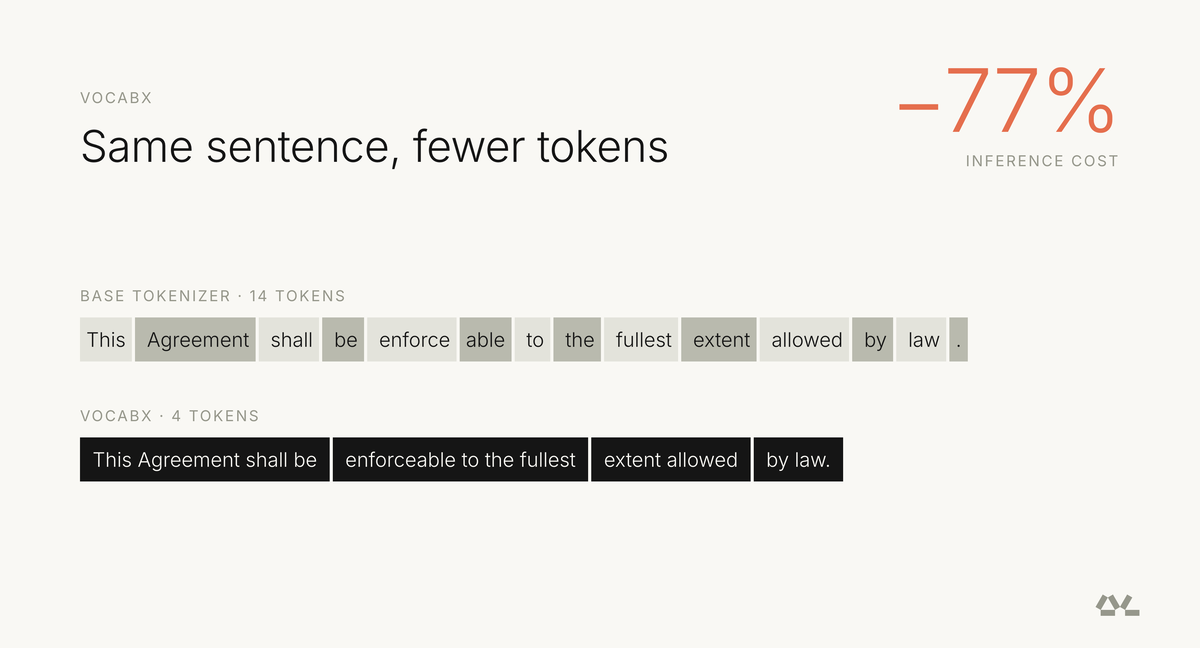
I ricercatori hanno ricostruito il tokenizer per un correttore automatico di saggi in produzione invece di lasciarlo com'è, mostrando che trattare il vocabolario come leva di costo può ridurre significativamente le bollette di inferenza.
Cosa se ne può fare
- Un ricercatore potrebbe ricostruire il vocabolario di un piccolo correttore automatico di saggi per adattarlo al compito effettivo e tagliare il costo misurato di inferenza del 77 percento senza modificare il modello di base o i dati di addestramento 1.
- Un'azienda che esegue uno strumento AI di nicchia in produzione potrebbe trattare il lessico ereditato come una leva di costo, sostituendo il tokenizer generico con uno specifico per il dominio per ridurre significativamente le bollette GPU 1.
- Uno sviluppatore che fa fine-tuning di un modello Qwen generico per un singolo dominio potrebbe risparmiare denaro mantenendo lo stesso modello e gli stessi dati ma sostituendoli con un vocabolario specializzato costruito attorno al costo anziché alla frequenza 1.
Lasciare indietro il tokenizer
Per la maggior parte degli sviluppatori che fanno fine-tuning di un modello Qwen generico per un compito specifico, il tokenizer è ereditato e dimenticato. Viene impostato una volta prima di qualsiasi addestramento e poi trattato come fisso.
Un team di Dharma-AI sostiene che questo lasci soldi sul tavolo. In un correttore automatico di saggi in portoghese che gira su Qwen3-4B, i ricercatori hanno ricostruito il vocabolario usando un metodo chiamato VocabX e hanno tagliato il costo misurato di inferenza del 77 percento senza modificare il modello di base o i dati di addestramento 1. Il risultato proviene da un pre-print che potrebbe subire variazioni prima della revisione tra pari.
I due tipi di spreco
I tokenizer generici sono addestrati su enormi corpus in molte lingue e domini, quindi dividono il testo in token per frequenza, non per costo per l'utente 1. Questa scelta crea due problemi per un'applicazione stretta.
Primo, frammentazione. Sequenze che si ripetono ad ogni richiesta, come un wrapper JSON o frasi standard di valutazione, vengono divise in molti token quando uno basterebbe 1. Secondo, eccesso. Il vocabolario conserva decine di migliaia di voci che il compito usa quasi mai, eppure il modello le valuta tutte ad ogni token generato .
Un modello valutato con testi portoghesi calcola ancora i punteggi per ogni token cinese nel suo vocabolario da 151.669 voci ad ogni passo della generazione 1.
Leggere costa poco, scrivere costa di più
Il risparmio deriva dal capire che generare un token è molto più costoso che leggerlo 1. Durante la fase di prefill, il modello elabora l'intero input in un unico passaggio e riutilizza le letture dei pesi attraverso ogni token. Durante il decode, produce un token alla volta, e ogni passo richiede un passaggio completo attraverso la rete più una lettura della KV cache, la memoria di attenzione che cresce con il contesto .
Il calcolo GPU passa dall'essere il collo di bottiglia alla banda di memoria. Nel test del correttore, un token generato ha costato 7,4 volte un token letto, anche se il rapporto varia con hardware, dimensione del batch e lunghezza del contesto 1. Ridurre il numero di token in uscita conta molto più che ridurre il numero di token in ingresso.
Un secondo fattore di costo è il vocabolario stesso. L'ultimo strato del modello, la testina LM, contiene una riga di parametri per ogni voce del vocabolario, rappresentando quasi il 10 percento dei parametri in un modello piccolo come Qwen3-4B 1. Ogni token generato costringe la GPU a leggere e moltiplicare l'intera matrice, quindi le voci inutilizzate costano quanto quelle frequenti .
VocabX tiene conto di questa asimmetria selezionando le voci del vocabolario attorno al costo di ogni token anziché alla frequenza grezza 1.
Cosa è cambiato e cosa no
Il correttore riceve un saggio, un prompt e testi di supporto, poi restituisce una valutazione JSON con un voto e un commento per ogni competenza 1. Prima della ristrutturazione, usava già un modello da 4 miliardi di parametri adattato per il compito; solo il tokenizer è stato sostituito .
I numeri derivano dalla versione attuale del paper VocabX, ancora in revisione, e gli autori notano che potrebbero cambiare prima della pubblicazione 1.
Quanto è valido
In un correttore automatico di saggi in portoghese in produzione basato su Qwen3-4B, il metodo VocabX ha tagliato il costo misurato di inferenza del 77 percento rispetto al vocabolario generico originale 1. Il team di Dharma-AI ha anche testato metodi di riferimento esistenti come il trasferimento rapido del vocabolario, la tokenizzazione multi-parola e Liquid AI in-place BPE, ritrovandoli carenti su entrambi i fronti: scelgono i token per frequenza anziché per costo e operano su un solo strato del tokenizer . Questo significa che un token generato, che nel loro test è costato 7,4 volte un token letto, resta comunque prezzo pieno anche quando il vocabolario contiene decine di migliaia di voci che il dominio non usa mai .
Correzioni e aggiornamenti
- Corrected on 24 October 2026. An earlier version referenced a chart and an image caption that could not be verified from the source text; the replacements removed those unsupported elements.
I fatti principali
- Il costo di inferenza è sceso del 77 percento su un correttore automatico di saggi in portoghese in produzione dopo aver ricostruito il vocabolario con VocabX.
- Il modello di base, i dati di addestramento e la ricetta di addestramento sono rimasti invariati; è stato sostituito solo il tokenizer.
- Generare un token nel test è costato 7,4 volte un token letto perché la fase di decode è vincolata dalla banda di memoria.
- La testina LM contiene circa il 10 percento dei parametri in un modello da 4 miliardi di parametri e viene letta per intero ad ogni token generato.
I risultati si basano sull'ultima versione del manoscritto, attualmente in revisione, e potrebbero essere modificati prima della pubblicazione.
Fonti
Notizie collegate
 Nuovi modelliRecursive Releases Flint, a 40B Open-Weight Local Coding Model for AgentsHerald of AI
Recursive Releases Flint, a 40B Open-Weight Local Coding Model for Agents
Flint è il primo modello di Recursive Superintelligence: un agente di codifica locale veloce che gira su hardware consumer.
 Come funzionaInsegnare agli agent AI a sapere quando fermarsiHerald of AIFigure: Liu et al., arXiv:2610.24194, CC BY 4.0
Insegnare agli agent AI a sapere quando fermarsi
Un nuovo sistema aiuta i modelli AI che usano strumenti a decidere se agire, raccogliere ulteriori informazioni o chiedere aiuto a un essere umano.
 Come funzionaRicercatori sviluppano metodo per rendere i grandi modelli linguistici più veloci nelle risposteHerald of AI
Ricercatori sviluppano metodo per rendere i grandi modelli linguistici più veloci nelle risposte
Un nuovo approccio di addestramento e inferenza chiamato DScout potrebbe aiutare i sistemi di intelligenza artificiale a generare testo fino a quattro volte più velocemente mantenendo l'accuratezza.
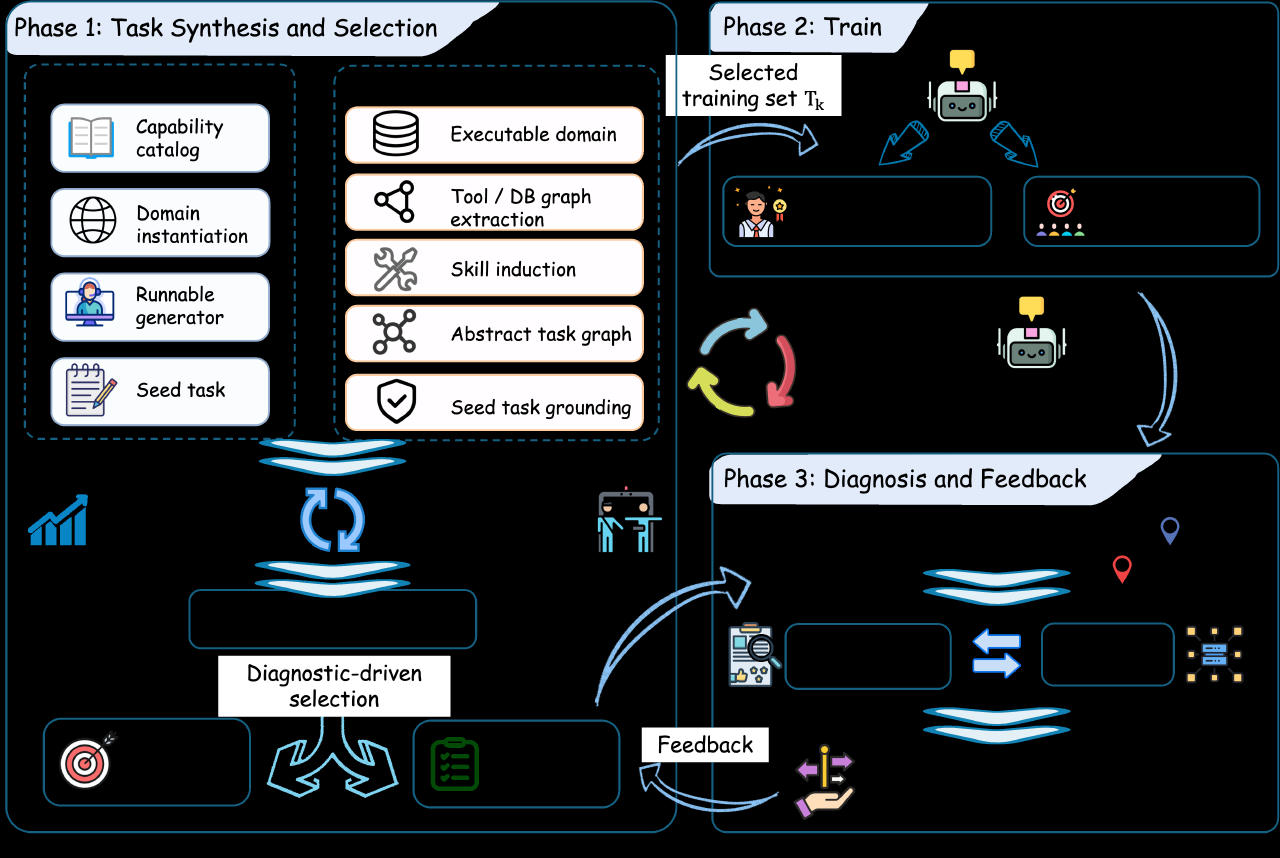 Come funzionaAgenti AI ClawLoop che imparano da soli a migliorareHerald of AIFigure: Yang et al., arXiv:2610.14118, CC BY 4.0
Agenti AI ClawLoop che imparano da soli a migliorare
Un nuovo framework di addestramento consente agli agenti AI di migliorare da soli, senza un modello insegnante più potente che guidi ogni fase.