Ricercatori sviluppano metodo per rendere i grandi modelli linguistici più veloci nelle risposte
Un nuovo approccio di addestramento e inferenza chiamato DScout potrebbe aiutare i sistemi di intelligenza artificiale a generare testo fino a quattro volte più velocemente mantenendo l'accuratezza.
Il problema del rendere l'intelligenza artificiale più veloce
I grandi modelli linguistici come quelli di Qwen possono ormai produrre risposte impressionanti, ma continuano a generare il testo una parola alla volta. Questo processo, chiamato decoding autoregressivo, può essere lento, specialmente quando gli utenti vogliono risposte rapide.
I ricercatori hanno lavorato a metodi per accelerare tutto ciò. Un approccio è il decoding speculativo, in cui un modello più piccolo propone più parole insieme e il modello più grande verifica se sono corrette. Tuttavia, anche con questi metodi ci sono dei limiti.
Quando un modello più piccolo suggerisce diversi token (parole o parti di parole), il sistema accetta solo una sequenza consecutiva all'inizio. Se un token iniziale è sbagliato, tutti quelli successivi corretti vengono sprecati. Questo significa che avere semplicemente più previsioni non porta sempre a tempi di risposta più veloci.
Un nuovo approccio di fattorizzazione
Il team di ricerca ha introdotto un metodo chiamato DScout. Invece di trattare previsione e verifica come passaggi separati, hanno suddiviso il problema in parti più piccole usando quella che chiamano fattorizzazione.
Per l'addestramento, DScout divide il calcolo della perdita in tre parti: inclusione (se il token verrà accettato), pesatura (quanto è prezioso quel token) e perdita di previsione. Questo aiuta il modello a concentrarsi sui token più probabili da accettare di fila, invece che su singole previsioni corrette.
Per l'inferenza, hanno diviso il throughput in un rapporto semplice: token accettati per round diviso tempo impiegato per round. Questo ha guidato le scelte sulla profondità del modello e su quanti token proporre insieme.
Risultati attraverso i benchmark
Il metodo è stato testato su sei benchmark diversi utilizzando i modelli Qwen3-4B e Qwen3-8B. I risultati hanno mostrato un aumento medio della velocità di 3,84× su Qwen3-4B e 4,14× su Qwen3-8B rispetto al decoding autoregressivo. Questo ha migliorato il precedente miglior baseline rispettivamente dell'9,1% e del 7,1%.
I ricercatori hanno anche scoperto che selezionare automaticamente la configurazione migliore per ogni carico di lavoro fornisce un'ulteriore accelerazione fino al 9,75% rispetto all'uso di una configurazione fissa.
Il team dietro questo lavoro include ricercatori di varie istituzioni, con il paper presentato su arXiv nell'ottobre 2026. Il paper completo è disponibile online e si prevede che seguiranno il codice e materiali aggiuntivi.
Correzioni e aggiornamenti
- Corrected on 23 October 2026. An earlier version defined autoregressive decoding in terms of words; the paper frames the discussion around tokens throughout. The replacement definitions are consistent with how the source describes speculative decoding as token-level proposal and verification. An earlier version described the third component as "prediction accuracy" rather than the source term "prediction loss." The speed claim in item 1 was supported since the paper reports up to 4.14x mean speedup on Qwen3-8B, which the original rounded to "up to four times."
I fatti principali
Su Qwen3-4B e Qwen3-8B, DScout gira in media 3,84 volte e 4,14 volte più velocemente del decoding autoregressivo, rispettivamente.
- Il metodo usa la fattorizzazione per guidare sia le decisioni di addestramento che quelle di inferenza
- I test su sei benchmark mostrano miglioramenti costanti
- La selezione automatica della configurazione aggiunge fino al 9,75% di accelerazione aggiuntiva
Fonti
Ogni fatto di questa notizia viene dalla fonte qui sopra.
Notizie collegate
 Nuovi modelliRecursive Releases Flint, a 40B Open-Weight Local Coding Model for AgentsHerald of AI
Recursive Releases Flint, a 40B Open-Weight Local Coding Model for Agents
Flint è il primo modello di Recursive Superintelligence: un agente di codifica locale veloce che gira su hardware consumer.
 Come funzionaInsegnare agli agent AI a sapere quando fermarsiHerald of AIFigure: Liu et al., arXiv:2610.24194, CC BY 4.0
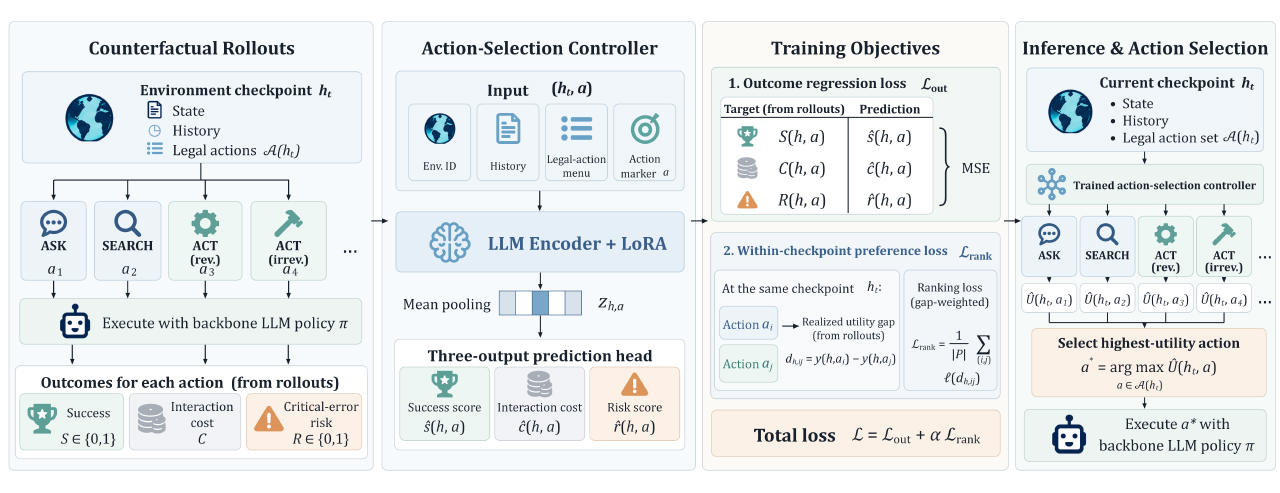
Insegnare agli agent AI a sapere quando fermarsi
Un nuovo sistema aiuta i modelli AI che usano strumenti a decidere se agire, raccogliere ulteriori informazioni o chiedere aiuto a un essere umano.
 Come funzionaAgenti AI ClawLoop che imparano da soli a migliorareHerald of AIFigure: Yang et al., arXiv:2610.14118, CC BY 4.0
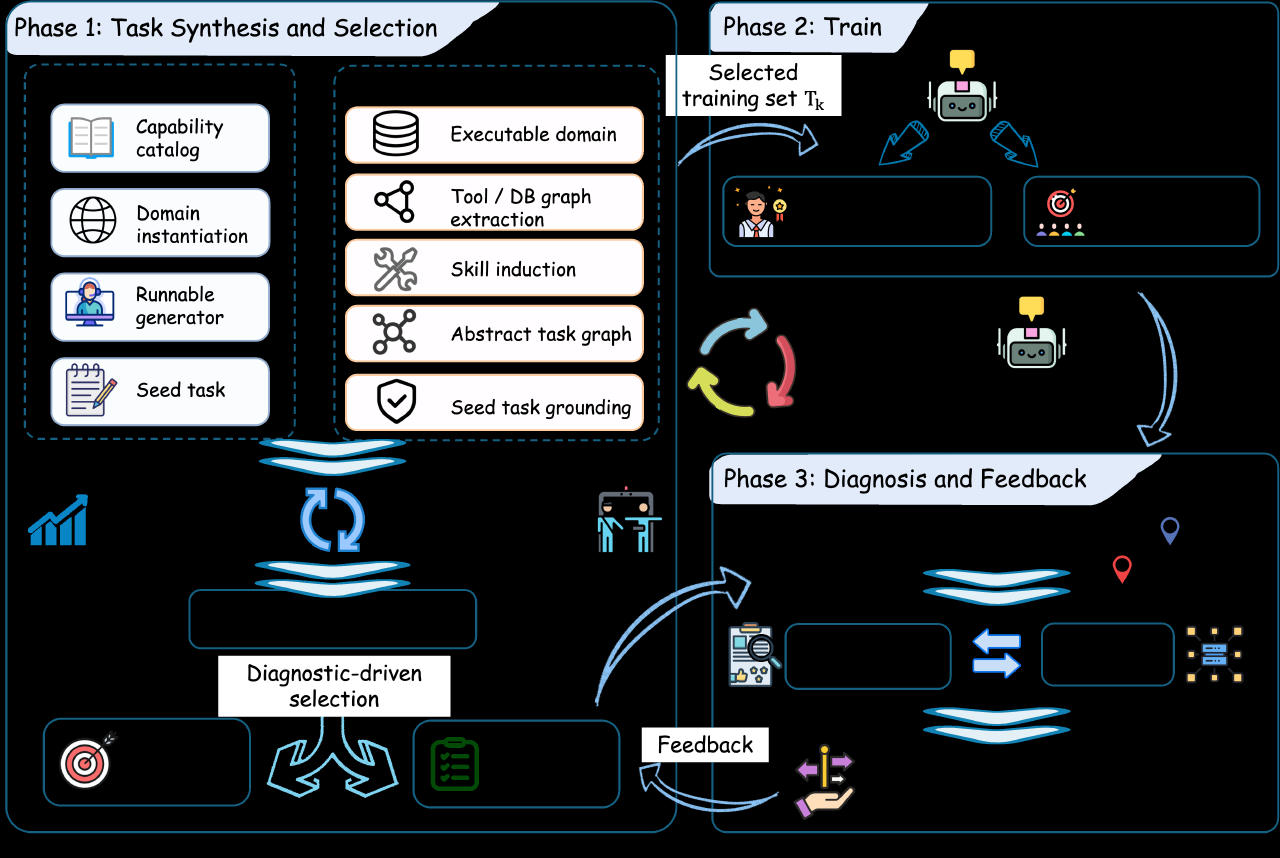
Agenti AI ClawLoop che imparano da soli a migliorare
Un nuovo framework di addestramento consente agli agenti AI di migliorare da soli, senza un modello insegnante più potente che guidi ogni fase.
 Come funzionaCome Echo permette ai modelli AI di grandi dimensioni di allenarsi più velocemente usando dati ultra-leggeri a 4 bitHerald of AI
Come Echo permette ai modelli AI di grandi dimensioni di allenarsi più velocemente usando dati ultra-leggeri a 4 bit
Un nuovo metodo di comunicazione riduce il collo di bottiglia del trasferimento dati nell'addestramento di grandi modelli AI inviando solo 4 bit alla volta, senza compromettere la qualità del modello.