Agenti AI ClawLoop che imparano da soli a migliorare
Un nuovo framework di addestramento consente agli agenti AI di migliorare da soli, senza un modello insegnante più potente che guidi ogni fase.
Un ciclo che si alimenta da sé
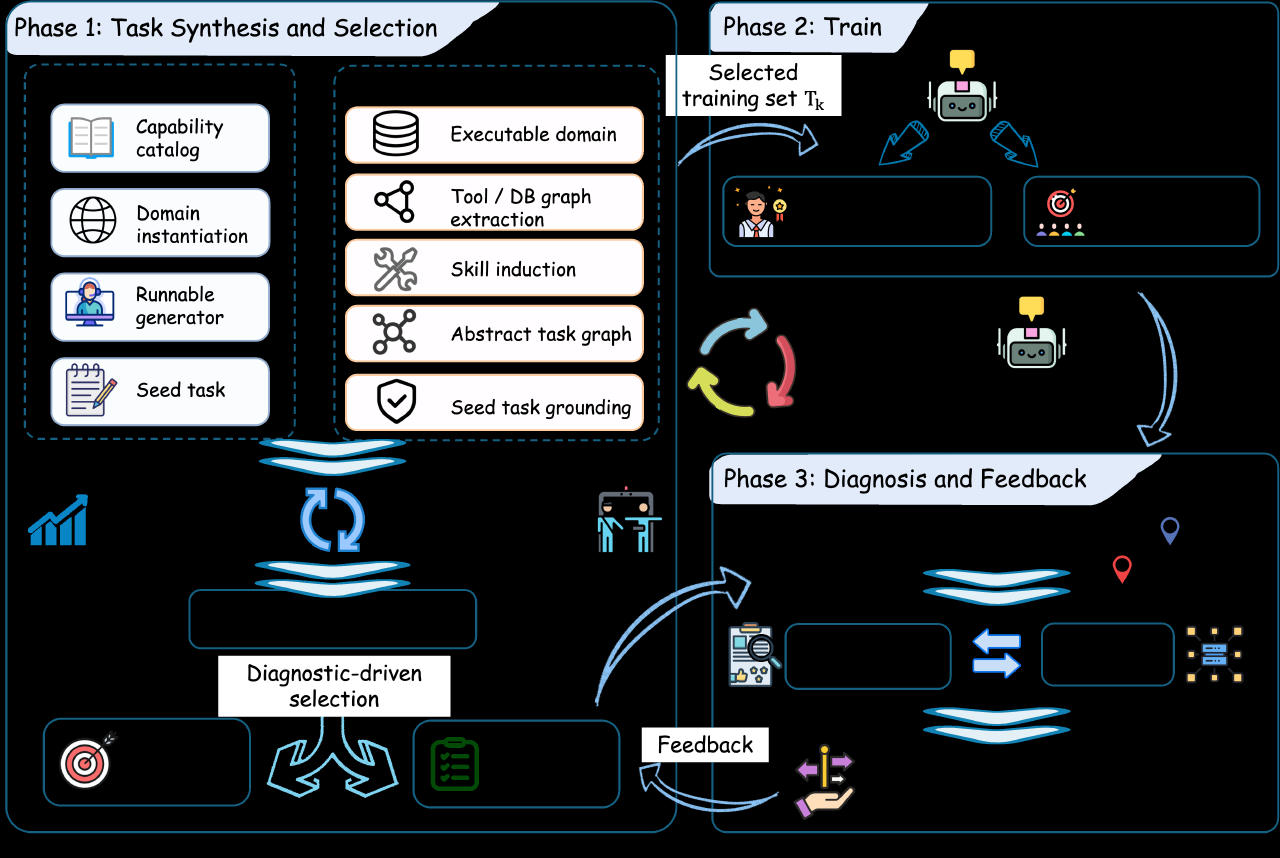
Qwen è già uno dei modelli linguistici open-source più forti disponibili, ma un team di ricercatori tra cui Hansi Yang presso Alibaba ha trovato un modo per renderlo ancora migliore — senza bisogno di un modello più potente per coacharlo. Chiamano questo approccio ClawLoop, e funziona trasformando gli errori dell'agente stesso nel carburante per il suo prossimo ciclo di miglioramento.
La maggior parte dei pipeline di addestramento per agenti AI si affida a un modello insegnante esterno. Quel modello più forte crea i compiti, raccoglie esempi di come lo studente si comporta, e un ricercatore umano controlla i risultati. Questo assetto ha un limite invalicabile: lo studente non può mai superare l'insegnante, e i progressi dipendono dagli umani che interpretano i dati. ClawLoop rimuove entrambi i limiti.
Tre fasi, ripetute
Il sistema gira in un cerchio composto da tre fasi. Prima, la Sintesi del Task crea un pool diversificato di sfide di addestramento. Usa due metodi diversi di costruzione per garantire che i compiti siano vari, poi ne aumenta la difficoltà in base a una diagnosi di come l'agente si è comportato nella fase precedente, e li verifica sia senza che con l'agente stesso 1.
Poi, la fase di Addestramento aggiorna l'agente usando due tecniche ben note: il fine-tuning supervisionato, in cui impara da esempi corretti, e l'apprendimento per rinforzo, in cui impara per tentativi ed errori con premi per un buon comportamento.
Infine, Diagnosi e Feedback osserva come l'agente si comporta effettivamente durante quelle sessioni di addestramento, redige un rapporto sulle abilità ancora deboli e invia quel rapporto alla prima fase in modo che il prossimo lotto di compiti vada a colmare esattamente quelle lacune.
Risultati trasferibili
Quando i ricercatori hanno testato ClawLoop usando Qwen3.6-27B come punto di partenza, ha migliorato costantemente su tre benchmark: SkillsBench, Claw-Eval-Live e ClawGym-Bench. Ma la scoperta più convincente è arrivata quando hanno preso i dati di addestramento prodotti dal ciclo e li hanno usati per addestrare modelli più piccoli — Qwen3.5-4B e Qwen3.5-9B. Anche questi modelli più piccoli sono migliorati su tutti gli stessi benchmark, dimostrando che i dati di addestramento erano genuinamente di alta qualità e non utili solo grazie al grande modello del loop 1.
Why it matters
L'intuizione chiave è che ClawLoop non ha bisogno di un modello più grande o intelligente per guidarlo. Alimentando il feedback diagnostico dell'agente nel suo stesso ciclo di addestramento, può continuare a spingere oltre le capacità iniziali con cui è partito. Per l'AI open-source, dove non esiste un modello "insegnante" dominante unico, questo tipo di ciclo auto-migliorante potrebbe accelerare i progressi in modi indipendenti dai vantaggi dei proprietari.
Il documento è stato inviato ad arXiv nell'ottobre 2026 da ricercatori di Alibaba e altre istituzioni.
Correzioni e aggiornamenti
- Corretto il 21 ottobre 2026. Una versione precedente affermava che i compiti vengono filtrati per difficoltà in base a precedenti errori. Il documento dice che la loro difficoltà viene aumentata in base a una diagnosi di come l'agente si è comportato nella fase precedente.
I fatti principali
- ClawLoop sostituisce i modelli insegnanti esterni con un ciclo di addestramento autosostenibile a tre fasi
- Sintesi del Task, Addestramento e Diagnosi si alimentano a vicenda in un loop continuo
- I dati generati dal loop hanno migliorato i modelli più piccoli Qwen3.5, provando la trasferibilità
- L'approccio è stato testato su SkillsBench, Claw-Eval-Live e ClawGym-Bench
Fonti
Notizie collegate
 Nuovi modelliRecursive Releases Flint, a 40B Open-Weight Local Coding Model for AgentsHerald of AI
Recursive Releases Flint, a 40B Open-Weight Local Coding Model for Agents
Flint è il primo modello di Recursive Superintelligence: un agente di codifica locale veloce che gira su hardware consumer.