Insegnare agli agent AI a sapere quando fermarsi
Un nuovo sistema aiuta i modelli AI che usano strumenti a decidere se agire, raccogliere ulteriori informazioni o chiedere aiuto a un essere umano.
Il problema degli agent che usano strumenti
Qwen3-4B e altri agent basati su modelli linguistici di grandi dimensioni stanno ricevendo sempre più accesso a strumenti esterni, ossia programmi software o API che possono richiamare per eseguire compiti. Questi agent possono cercare nel web, eseguire codice, fare clic sui pulsanti di un browser e compiere molte altre azioni. Ma avere strumenti a disposizione ha senso solo se l'agent sa quando effettivamente usarli.
In ogni momento, un agent si trova a dover scegliere tra tre opzioni: agire in autonomia, raccogliere più informazioni o escalate il compito a un essere umano. Ogni decisione comporta un compromesso. Agire troppo in fretta può portare a errori irreversibili. Raccogliere troppe informazioni spreca tempo e denaro. Chiedere aiuto umano troppo spesso vanificherebbe lo scopo stesso di avere un agent autonomo.
La sfida è che l'addestramento tradizionale mostra agli agent solo il risultato delle azioni effettivamente compiute, lasciando tutte le alternative non osservate 1. È come imparare a guidare vedendo solo cosa succede quando si svolta a sinistra a ogni incrocio, senza mai sapere che cosa sarebbe accaduto se si fosseandati dritti o svoltati a destra .
Un nuovo metodo per addestrare gli agent
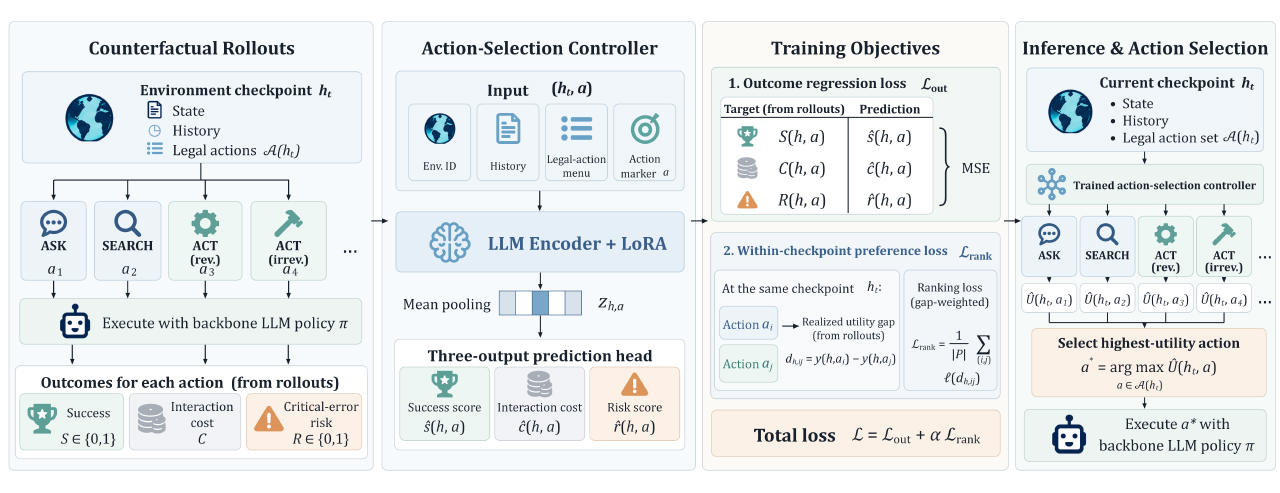
Ricerchatrici e ricercatori tra cui Qisai Liu, Qingyue Jiao e colleghi di varie istituzioni hanno presentato un metodo che affronta diversamente questi momenti decisionali. Hanno costruito un dataset di oltre tremila centoquindici risultati derivanti da mille trentasei momenti distinti in cui un agent doveva scegliere tra le azioni disponibili, registrati in una piattaforma chiamata ToolSandbox 1.
In ogni momento decisionale, ogni azione legale è stata effettivamente eseguita e le sue conseguenze sono state valutate in base al completamento del compito, al costo dell'interazione e al rischio di errori irreversibili 1. Questo approccio crea un dataset counterfactual, ovvero il sistema registra quello che sarebbe successo con ogni possibile scelta, non solo con quella che l'agent aveva originariamente realizzato .
SURE-Act migliora le decisioni degli agent
Grazie a questo dataset, il team ha addestrato un controller chiamato SURE-Act che opera sopra un agent backbone congelato. Invece di riaddestrare l'intero modello, SURE-Act impara semplicemente a classificare le azioni alternative disponibili in ogni momento decisionale e seleziona la migliore al momento dell'inferenza 1.
Nei test, insegnare ai modelli a classificare le diverse azioni possibili ha aumentato l'utilità offline della selezione delle azioni dello 0,0309 rispetto a una baseline che si affidava solo alla regressione 1. I ricercatori hanno anche dimostrato che l'integrazione di SURE-Act produce miglioramenti cumulativi fino a 0,0575 sull'Overall Score di ToolSandbox quando abbinato all'agent Qwen3-4B .
Il sistema ha anche superato regole di decisione adattate da due altri approcci: SAGE-Agent e Calibrate-Then-Act, con margini di 0,1506 e 0,1438 rispettivamente 1. Lo studio introduce il primo dataset counterfactual realizzato per ToolSandbox e offre indicazioni pratiche per consentire agli agent di prendere decisioni migliori quando si trovano ad affrontare l'incertezza .
Questa storia riporta ricerche a solo scopo informativo. Non costituisce consiglio né invito a implementare queste tecniche.
I fatti principali
- I ricercatori hanno costruito un dataset counterfactual con 3.115 risultati provenienti da 1.036 momenti decisionali in ToolSandbox
- Il controller SURE-Act classifica le azioni alternative per migliorare il processo decisionale degli agent al momento dell'inferenza
- L'aggiunta di SURE-Act a Qwen3-4B ha migliorato i punteggi end-to-end fino a 0,0575 in ToolSandbox
- SURE-Act ha superato le regole adattate da SAGE-Agent e Calibrate-Then-Act con margini di 0,1506 e 0,1438 rispettivamente