Especializar el vocabulario de los pequeños modelos de lenguaje reduce el coste de inferencia en un 77%
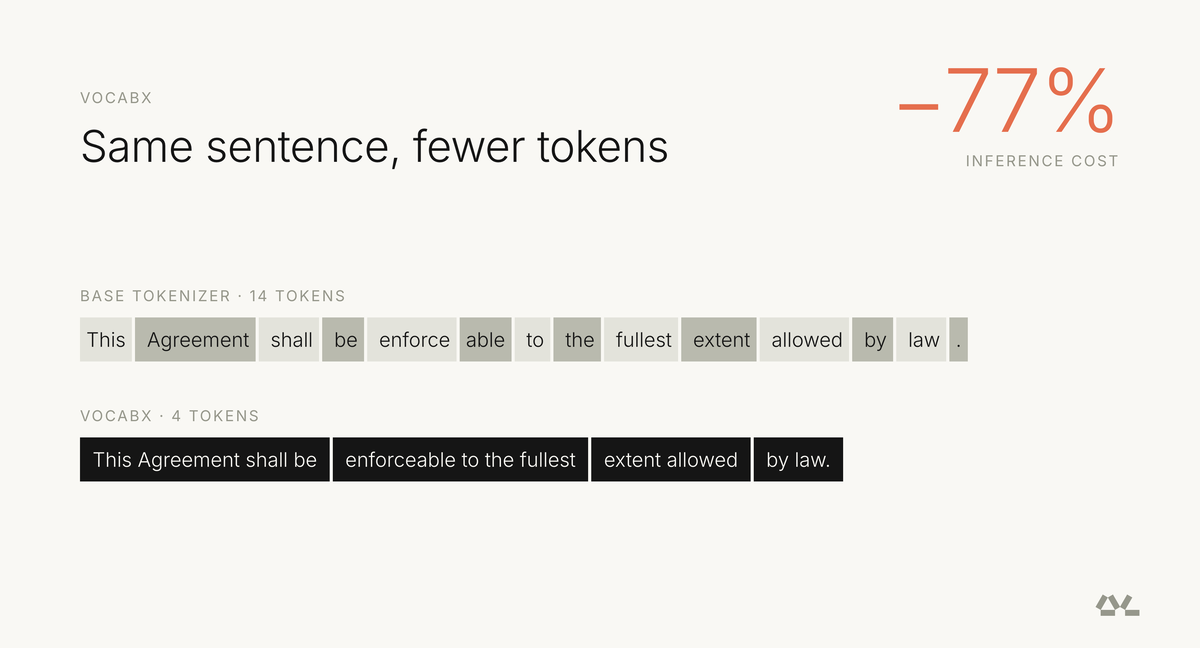
Los investigadores reconstruyeron el tokenizer de un corrector de ensayos en producción en lugar de dejarlo como estaba, mostrando que tratar el vocabulario como una palanca de costes puede recortar las facturas de inferencia.
What you could do with it
- Un investigador podría reconstruir el vocabulario de un pequeño corrector de ensayos automatizado para ajustarlo a su tarea real y reducir el coste de inferencia medido en un 77 por ciento sin cambiar el modelo base ni los datos de entrenamiento 1.
- Una empresa que ejecute una herramienta de IA de nicho en producción podría tratar la lista de palabras heredada como una palanca de costes, sustituyendo el tokenizer de propósito general por uno específico del dominio para recortar las facturas de GPU 1.
- Un desarrollador que ajuste un modelo Qwen de propósito general para un solo dominio podría ahorrar dinero manteniendo el mismo modelo y datos, pero cambiando por un vocabulario especializado construido alrededor del coste en lugar de la frecuencia 1.
Leaving the Tokenizer Behind
Para la mayoría de los desarrolladores que ajustan un modelo general de Qwen para una tarea específica, el tokenizer se hereda y se olvida. Se fija una vez antes de que comience cualquier entrenamiento y luego se trata como algo fijo.
Un equipo de Dharma-AI sostiene que esto deja dinero sobre la mesa. En un corrector automatizado de ensayos en portugués que funciona con Qwen3-4B, los investigadores reconstruyeron el vocabulario usando un método que llaman VocabX y redujeron el coste de inferencia medido en un 77 por ciento sin cambiar el modelo base ni los datos de entrenamiento 1. El resultado proviene de un artículo prepublicado que podría modificarse antes de la revisión por pares.
The Two Kinds of Waste
Los tokenizers de propósito general se entrenan en corpus enormes en muchos idiomas y dominios, por lo que dividen el texto en tokens por frecuencia, no por el coste para el usuario 1. Esa elección crea dos problemas para una aplicación estrecha.
En primer lugar, fragmentación. Las secuencias que se repiten en cada solicitud, como un envoltorio JSON o frases estándar de evaluación, se dividen en muchos tokens cuando bastaría uno 1. En segundo lugar, exceso. El vocabulario conserva decenas de miles de entradas que la tarea casi nunca usa, pero el modelo puntúa todas ellas en cada token generado .
Un modelo corregido con textos en portugués aún calcula puntuaciones para cada token chino en su vocabulario de 151.669 entradas en cada paso de la generación 1.
Reading Is Cheap, Writing Costs More
Los ahorros provienen de entender que generar un token es mucho más caro que leer uno 1. Durante la fase de prefill, el modelo procesa la entrada completa en un solo pase y reutiliza lecturas de pesos en cada token. Durante decode, produce un token a la vez, y cada paso requiere un pase completo por la red más una lectura del KV cache, la memoria de atención que crece con el contexto .
El cálculo de la GPU pasa de ser el cuello de botella al ancho de banda de memoria. En la prueba del corrector, un token generado costó 7,4 veces más que un token leído, aunque la proporción varía según el hardware, el tamaño del lote y la longitud del contexto 1. Reducir el número de tokens de salida importa mucho más que reducir el número de tokens de entrada.
Un segundo factor de coste es el propio vocabulario. La capa final del modelo, el cabezal LM, contiene una fila de parámetros por cada entrada del vocabulario, lo que representa casi el 10 por ciento de los parámetros en un modelo pequeño como Qwen3-4B 1. Cada token generado obliga a la GPU a leer y multiplicar toda la matriz, por lo que las entradas no usadas cuestan lo mismo que las frecuentes .
VocabX tiene en cuenta esta asimetría seleccionando entradas del vocabulario alrededor del coste de cada token en lugar de la frecuencia bruta 1.
What Changed and What Did Not
El corrector recibe un ensayo, un prompt y textos de apoyo, luego devuelve una evaluación en JSON con una nota y un comentario para cada competencia 1. Antes de la renovación, ya usaba un modelo de 4 mil millones de parámetros ajustado para la tarea; solo se reemplazó el tokenizer .
Los números provienen de la versión actual del artículo de VocabX, aún en revisión, y los autores señalan que podrían cambiar antes de la publicación 1.
How good is it
En un corrector automatizado en producción para ensayos en portugués construido sobre Qwen3-4B, el método VocabX redujo el coste de inferencia medido en un 77 por ciento en comparación con el vocabulario general original 1. El equipo de Dharma-AI también probó métodos de referencia existentes como transferencia rápida de vocabulario, tokenización de varias palabras y Liquid AI BPE in-place, y los encontró deficientes en ambos frentes: seleccionan tokens por frecuencia en lugar de por coste y operan solo en una sola capa del tokenizer . Eso significa que un token generado, que en su prueba costó 7,4 veces más que un token de lectura, sigue teniendo el precio completo incluso cuando el vocabulario lleva decenas de miles de entradas que el dominio nunca usa .
Correcciones y actualizaciones
- Corrected on 24 October 2026. An earlier version referenced a chart and an image caption that could not be verified from the source text; the replacements removed those unsupported elements.
Los datos clave
- Inference cost fell by 77 percent on a production Portuguese essay grader after rebuilding the vocabulary with VocabX.
- The base model, training data and training recipe were unchanged; only the tokenizer was replaced.
- Generating a token in the test cost 7.4 times a token read because the decode phase is memory-bandwidth bound.
- The LM head holds roughly 10 percent of parameters in a 4-billion-parameter model and is read in full at every generated token.
The findings are based on the latest version of the manuscript, which is currently undergoing review, and could be modified prior to publication.
Fuentes
Noticias relacionadas
 Nuevos modelosRecursive Releases Flint, a 40B Open-Weight Local Coding Model for AgentsHerald of AI
Recursive Releases Flint, a 40B Open-Weight Local Coding Model for Agents
Flint is Recursive Superintelligence's first model: a fast local coding agent running on consumer hardware.
 Cómo funcionaEnseñar a los agentes de IA a saber cuándo pararHerald of AIFigure: Liu et al., arXiv:2610.24194, CC BY 4.0
Enseñar a los agentes de IA a saber cuándo parar
Un nuevo sistema ayuda a los modelos de IA que usan herramientas a decidir si actuar, recabar más información o pedir ayuda a un humano.
 Cómo funcionaResearchers develop method to make large language models respond fasterHerald of AI
Researchers develop method to make large language models respond faster
A new training and inference approach called DScout could help AI systems generate text up to four times faster while maintaining accuracy.
 Cómo funcionaAgentes de IA ClawLoop que se enseñan a sí mismos para mejorarHerald of AIFigure: Yang et al., arXiv:2610.14118, CC BY 4.0
Agentes de IA ClawLoop que se enseñan a sí mismos para mejorar
Un nuevo marco de entrenamiento permite que los agentes de IA mejoren por su cuenta sin necesidad de un modelo profesor más potente que los guíe en cada paso.