vLLM Hyper-Optimizza Kimi K3 su NVIDIA GB300 per Inferenza Rapidissima
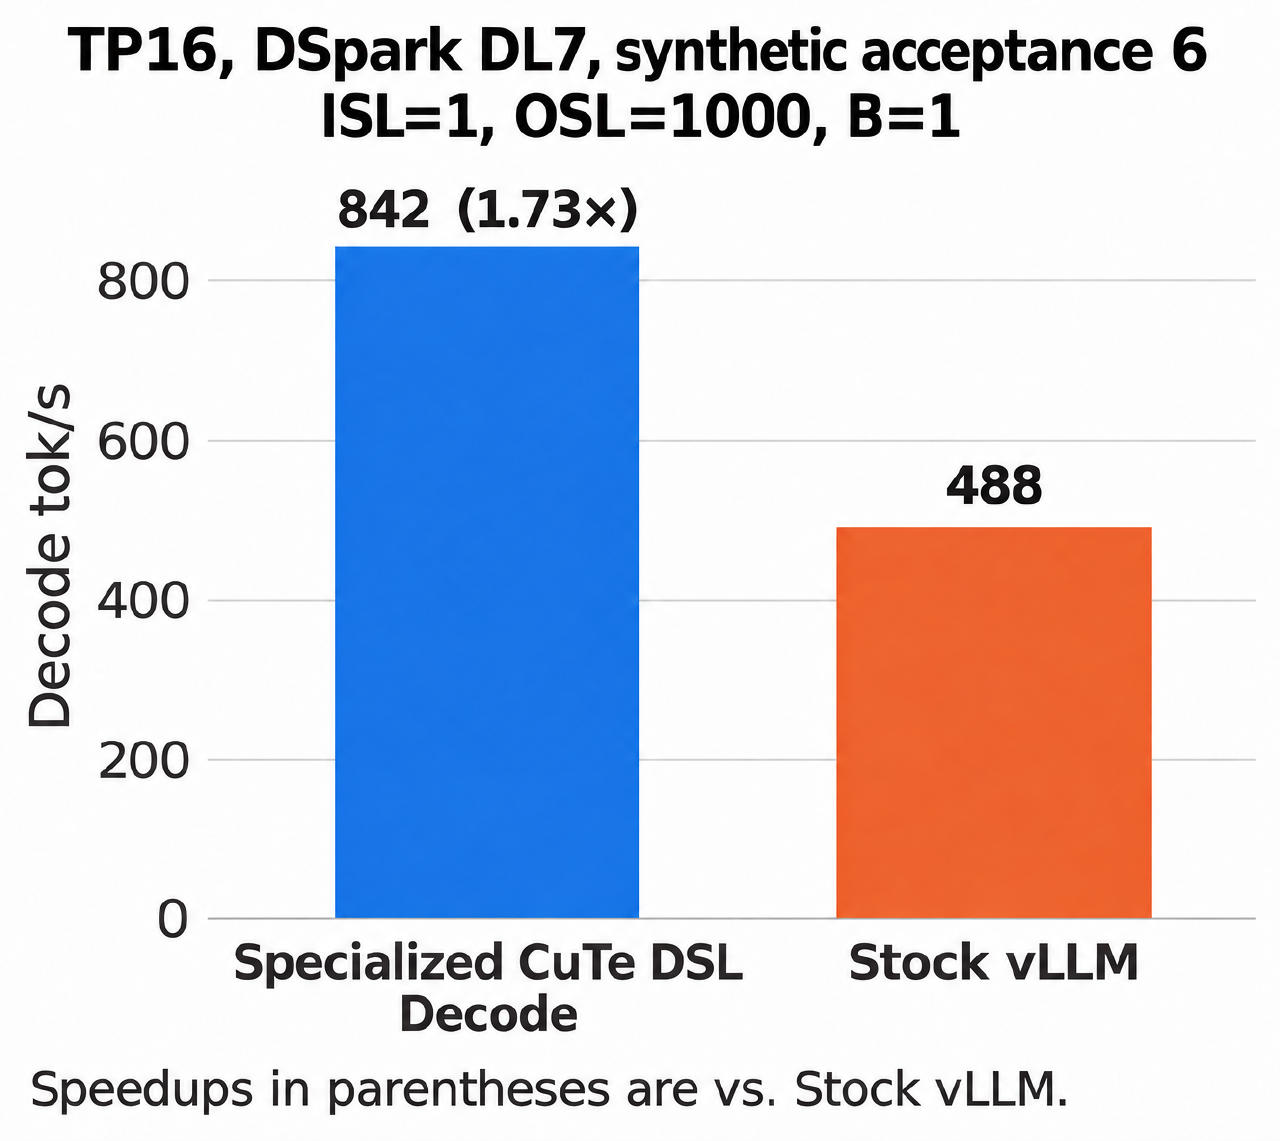
Nuove ottimizzazioni spingono il decoding di Kimi K3 oltre 840 token al secondo con batch 1 su 16 GPU NVIDIA GB300 con DSpark.
Cosa se ne può fare
- Un'azienda di chatbot potrebbe offrire agli utenti risposte quasi due volte più veloci quando pongono una domanda alla volta 1.
- Uno sviluppatore che esegue assistenti AI basati su Kimi K3 potrebbe ridurre i costi di infrastruttura ottenendo di più sulle stesse macchine da 16 GPU 1.
- Un ricercatore che testa agent AI a lungo contesto potrebbe vedere tempi di risposta migliorare fino a 1,8× su carichi di lavoro reali 1.
La velocità è tutto
La libreria open-source vLLM ha spinto le prestazioni di Kimi K3 a livelli nuovi costruendo un set completamente personalizzato di istruzioni GPU, ovvero kernel, ottimizzati per i chip NVIDIA Blackwell. Per i modelli AI che rispondono una parola alla volta — un processo chiamato decoding — ogni microsecondo conta. Il risultato: oltre 840 token al secondo su una singola query con 16 GPU NVIDIA GB300 con DSpark (synthetic AL=6), con un aumento di throughput del 1,5–2× in diverse configurazioni testate.
L'approccio agentic
vLLM sta anche cambiando il modo in cui sviluppa queste ottimizzazioni. Per la prima volta, agenti AI hanno aiutato a scrivere e ottimizzare le parti più complesse del codice — kernel GPU personalizzati, fusione di più operazioni in una e coordinamento della comunicazione tra molte GPU 1. Il team afferma che questo segna un cambiamento nel modo in cui il lavoro sulle prestazioni è organizzato: invece di essere gli esseri umani a rivedere ogni singola riga, stanno costruendo sistemi in grado di verificare automaticamente la correttezza. "Dobbiamo cambiare il modo in cui organizziamo il lavoro sulle prestazioni", ha scritto il team nel suo post del blog di ottobre 2026 .
Cosa è stato ottimizzato
Il percorso di decoding ottimizzato sostituisce quasi ogni operazione standard con un kernel custom costruito utilizzando il framework CuTe DSL di NVIDIA. Le tecniche principali includono:
- Shape tuning: Diversi batch size utilizzano kernel diversi, così le risorse GPU rimangono pienamente occupate a ogni carico di lavoro.
- Sovrapposizione di calcolo e comunicazione: L'output dell'attention viene fuso direttamente con la sua operazione all-reduce e il successivo calcolo residuo, riducendo il movimento di dati tra GPU.
- Miglioramento dello scheduling Mixture of Experts (MoE): I punteggi del router e i calcoli degli expert vengono divisi tra i rank GPU, riducendo il lavoro ridondante e consentendo all'expert condiviso di girare in parallelo su uno stream separato.
- Prefetching dei pesi nella cache: Mentre le GPU gestiscono la comunicazione, un kernel secondario precarica i pesi necessari per l'operazione successiva, evitando i colli di bottiglia di memoria comuni nell'inference con batch piccoli.
L'implementazione stock vLLM per Kimi K3 utilizza 130 microsecondi e 23 kernel per layer. La versione ottimizzata taglia a 69 microsecondi e solo 13 kernel per layer 1.
Perché è importante
Un decoding più veloce significa costi inferiori e migliore esperienza utente per qualsiasi servizio che esegue Kimi K3. Il team ha rilevato che il throughput di decoding è aumentato fino a 1,5–2× su multiple configurazioni testate, e l'interattività P90 è migliorata fino a 1,8× sul workload AgentX 1. vLLM prevede di applicare lo stesso approccio di ottimizzazione agentic ad altri modelli e hardware in futuro, sperando che la comunità aiuti a sviluppare gli strumenti di verifica e validazione necessari per rilasciare codice veloce ma sicuro.
Quanto è valida
Il percorso di decoding ottimizzato di vLLM gira a oltre 840 token al secondo a batch 1 su 16 GPU NVIDIA GB300 con DSpark, che è il 1,5–2× più veloce in throughput rispetto alla versione stock vLLM su diverse configurazioni testate 1. Ogni layer ora termina in soli 69 microsecondi utilizzando appena 13 kernel personalizzati, rispetto a 130 microsecondi e 23 kernel dell'implementazione originale . Sul workload agentic AgentX, l'interattività P90 (il punto al di sotto del quale cadono il 90% delle risposte) è migliorata fino a 1,8× . I test sono stati eseguiti e riportati dallo stesso team vLLM .
Immagine: vllm.ai
Correzioni e aggiornamenti
- Corretto il 23 ottobre 2026. Una versione precedente affermava che l'ottimizzazione stabiliva un nuovo standard per la velocità di inference in generale e descriveva il baseline come avente circa la metà della velocità; la fonte specificava la GPU esatta e le condizioni DSpark, e riportava un aumento di throughput del 1,5–2× piuttosto che un semplice confronto a metà velocità.
I fatti principali
- Oltre 840 token/secondo a batch 1 su 16 GPU NVIDIA GB300 con DSpark
- Il numero di kernel per layer è passato da 23 a 13, e la latenza da 130μs a 69μs
- Fino a 1,8× di interattività P90 più elevata sul workload AgentX
- vLLM ha utilizzato agenti AI per aiutare a scrivere e ottimizzare kernel GPU personalizzati
- Le ottimizzazioni mirano a GPU NVIDIA Blackwell con batch size 1–64 e parallelismo contestuale opzionale
Fonti
Notizie collegate
 Nuovi modelliKimi K3.1 Pro, un modello di intelligenza artificiale cinese scaricabile da chiunque, quasi eguaglia Claude Opus 5.5Herald of AI
Kimi K3.1 Pro, un modello di intelligenza artificiale cinese scaricabile da chiunque, quasi eguaglia Claude Opus 5.5
Il modello da 2,8 trilioni di parametri di Moonshot AI segna 55 su Artificial Analysis, tre punti dietro Claude Opus 5.5, costa la metà e i suoi pesi completi — i file che permettono a chiunque di eseguirlo autonomamente — saranno disponibili entro il 4 novembre.
 Come funzionaUn nuovo motore permette ai modelli AI piccoli di rispondere in meno di 50 millisecondiHerald of AI
Un nuovo motore permette ai modelli AI piccoli di rispondere in meno di 50 millisecondi
Liquid AI afferma che il suo strumento permette all'AI generativa di sostituire vecchi modelli per i controlli antifrode, i pagamenti e la ricerca — senza rallentare le operazioni.
 Nuovi modelliRecursive Releases Flint, a 40B Open-Weight Local Coding Model for AgentsHerald of AI
Recursive Releases Flint, a 40B Open-Weight Local Coding Model for Agents
Flint è il primo modello di Recursive Superintelligence: un agente di codifica locale veloce che gira su hardware consumer.
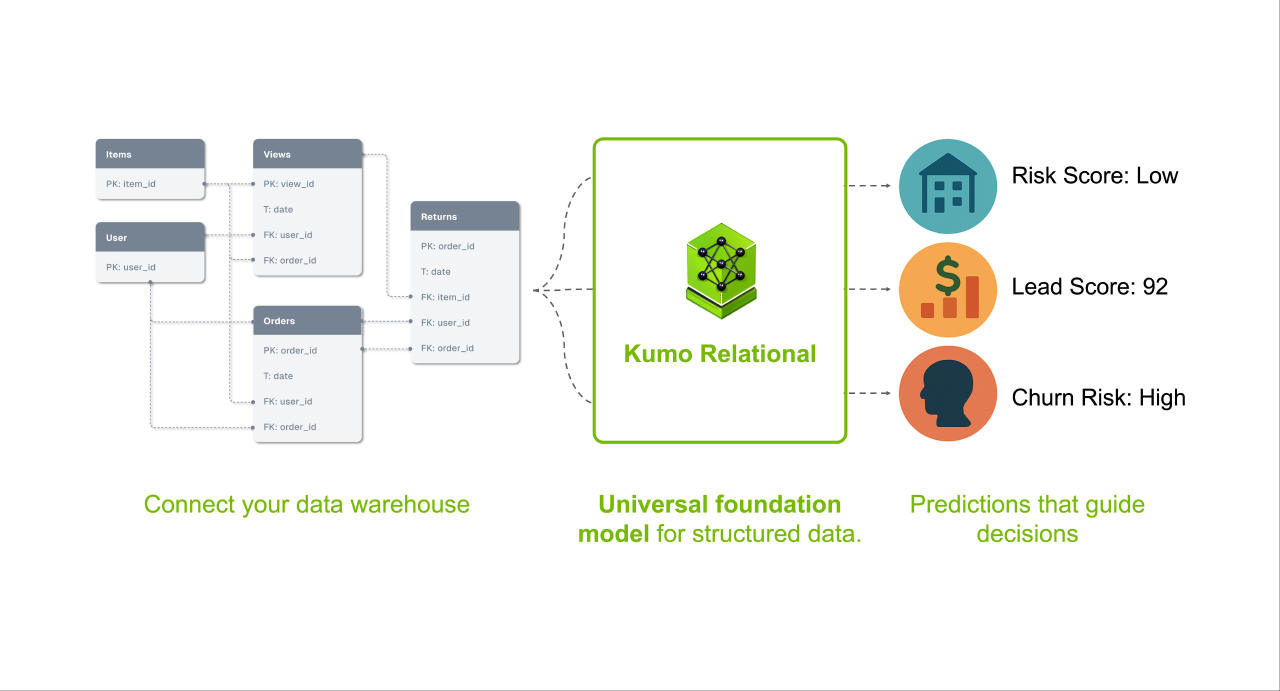 Nuovi modelliNVIDIA Kumo Relational batte il ML supervisionato sui dati relazionali senza trainingHerald of AI
NVIDIA Kumo Relational batte il ML supervisionato sui dati relazionali senza training
Un nuovo modello base pre-addestrato prevede risultati direttamente sui database enterprise, senza bisogno di feature engineering o training specifico per task.