DeepSeek rende open-source DeepInfer, il suo motore di inferenza ad alte prestazioni
Il laboratorio di intelligenza artificiale cinese ha rilasciato il framework alla base dei suoi servizi di produzione sotto licenza Apache 2.0, mettendone a disposizione dei developer le ottimizzazioni per il servizio su larga scala.
Cosa potresti farci
- Uno sviluppatore che realizza un'app di chat con IA potrebbe eseguire DeepSeek V4.1 Flash in locale con le ottimizzazioni per la velocità che DeepSeek utilizza in produzione, riducendo i tempi di risposta senza dipendere da un'API costosa 1.
- Un team di ricerca potrebbe imporre formati di output rigorosi, come schemi JSON o regole regex, affinché i dati generati dall'IA siano sempre strutturalmente coerenti e pronti per i processi successivi 1.
- Un'azienda che esegue inferenza su GPU NVIDIA SM100 o NPU Huawei Ascend 950 potrebbe sostituire il proprio stack di distribuzione con DeepInfer, ottenendo fin da subito la pianificazione asincrona e i decoder a previsione multi-tokens 1.
Un motore per la produzione, per tutti
DeepSeek ha reso open-source DeepInfer, il framework di inferenza che alimenta i suoi servizi di produzione su larga scala. Rilasciato sotto licenza Apache 2.0, DeepInfer concede alla comunità di intelligenza artificiale l'accesso diretto alle ottimizzazioni che l'azienda ha utilizzato per servire i propri modelli su scala.
Il framework è progettato per l'inferenza offline, ovvero esegue i modelli in locale anziché servire richieste API in tempo reale, e include le funzionalità fondamentali necessarie per un deployment di livello industriale.
Cosa contiene
DeepInfer supporta DeepSeek V4.1 Flash 1017 e vanta una serie di kernel ottimizzati, tra cui FlashMLA, DeepGEMM, DeepEP, TileKernels e kernel personalizzati TileLang 1. Il sistema include inoltre un decoder a previsione multi-token basato su token abbozzati e un scheduler di verifica a schedulazione della confidenza che accelera la generazione.
Tra le capacità tecniche chiave:
- Pianificazione asincrona: sovrappone la pianificazione dei batch sulla CPU con l'esecuzione sul dispositivo, per impostazione predefinita
- Inferenza batch-invariant: mantiene i risultati del modello identici indipendentemente dalla composizione del batch
- Campionamento deterministico: produce output identici per input identici quando viene fornito un seed fisso
- Output strutturati: vincola la generazione a regole di grammatica regex, JSON schema o EBNF
Il framework supporta anche un meccanismo di replay dell'attenzione a finestra scorrevole per il decoder, che riduce il lavoro di prefill ripetendo solo un suffisso limitato del contesto 1.
Hardware e configurazione
DeepInfer funziona su GPU NVIDIA SM100 e NPU Huawei Ascend 950. Richiede Linux con GCC 13 o successivo, Python 3.12 e CUDA 13 (per NVIDIA) o CANN 9.2 (per Ascend) 1.
Il team spiega che DeepInfer è stato sviluppato inizialmente a partire principalmente da vLLM, attingendo ulteriore ispirazione da SGLang e TensorRT-LLM. La disgregazione della KV cache, il bilanciamento del carico tra repliche e altri componenti dell'infrastruttura di distribuzione non sono inclusi in questa versione, ma sono indicati come necessari per un servizio di inferenza completo 1.
Perché conta
Rendere open-source lo strato di inferenza è significativo. La maggior parte dei laboratori di intelligenza artificiale rilascia i modelli ma mantiene proprietaria l'infrastruttura di distribuzione. Rilasciando DeepInfer, DeepSeek rende disponibili alla comunità più ampia le ottimizzazioni che permettono un deployment veloce ed economico dei propri modelli.
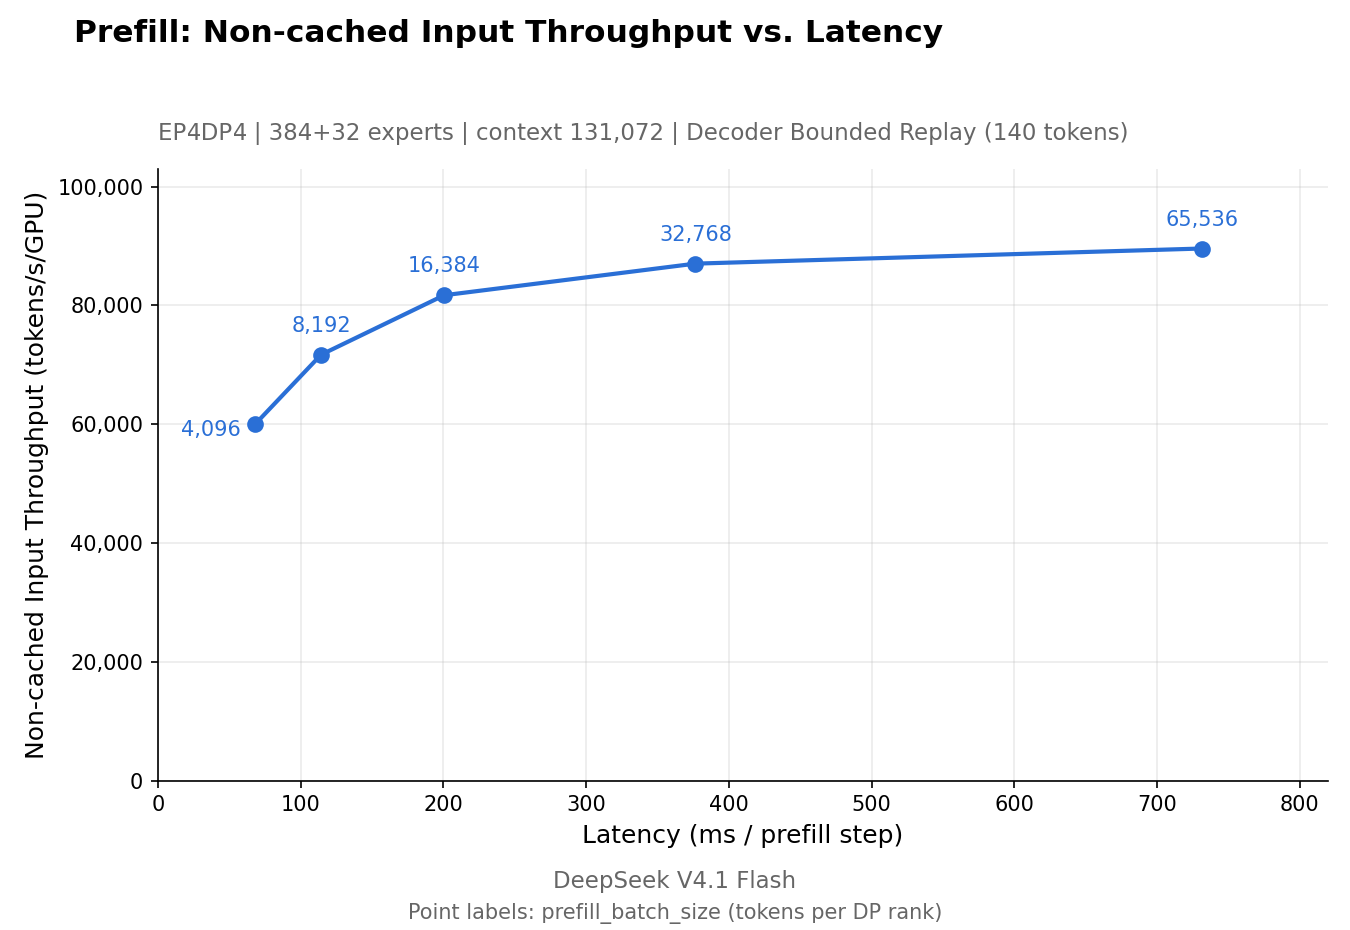
Il rilascio include benchmark di prestazione misurati su cluster da 4 GPU SM100 per il prefill e 64 per il decode, che dimostrano la scala per la quale il framework è progettato 1.
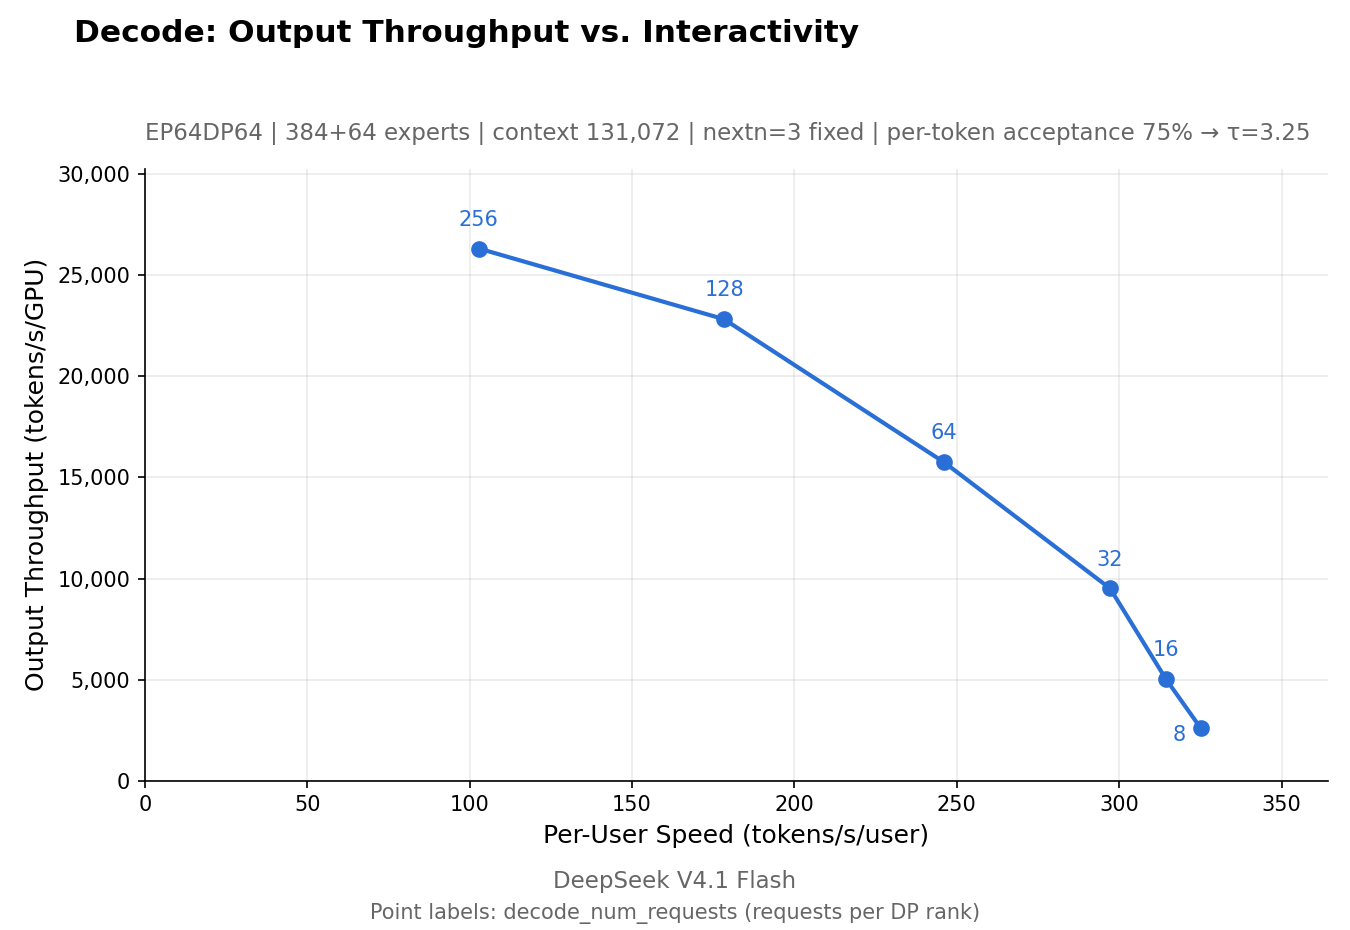
Immagine: github.com
Correzioni e aggiornamenti
- Corretto il 23 ottobre 2026. Una versione precedente affermava che DeepInfer supporta DeepSeek V4.1 Flash 1017 e altri modelli DeepSeek, ma la fonte elenca come unico modello supportato DeepSeek-V4.1-Flash e considera 1017 unicamente come nome del checkpoint predefinito. L'affermazione corretta limita il modello specifico a V4.1 Flash e identifica 1017 come checkpoint.
I fatti principali
- DeepInfer è rilasciato open-source sotto licenza Apache 2.0
- Supporta DeepSeek V4.1 Flash (nello specifico il checkpoint DeepSeek-V4.1-Flash-1017)
- Funziona su GPU NVIDIA SM100 e NPU Huawei Ascend 950
- Costruito principalmente su vLLM, con ispirazione da SGLang e TensorRT-LLM
Fonti
Notizie collegate
 Come funzionaUn nuovo motore permette ai modelli AI piccoli di rispondere in meno di 50 millisecondiHerald of AI
Un nuovo motore permette ai modelli AI piccoli di rispondere in meno di 50 millisecondi
Liquid AI afferma che il suo strumento permette all'AI generativa di sostituire vecchi modelli per i controlli antifrode, i pagamenti e la ricerca — senza rallentare le operazioni.
 Nuovi modelliRecursive Releases Flint, a 40B Open-Weight Local Coding Model for AgentsHerald of AI
Recursive Releases Flint, a 40B Open-Weight Local Coding Model for Agents
Flint è il primo modello di Recursive Superintelligence: un agente di codifica locale veloce che gira su hardware consumer.
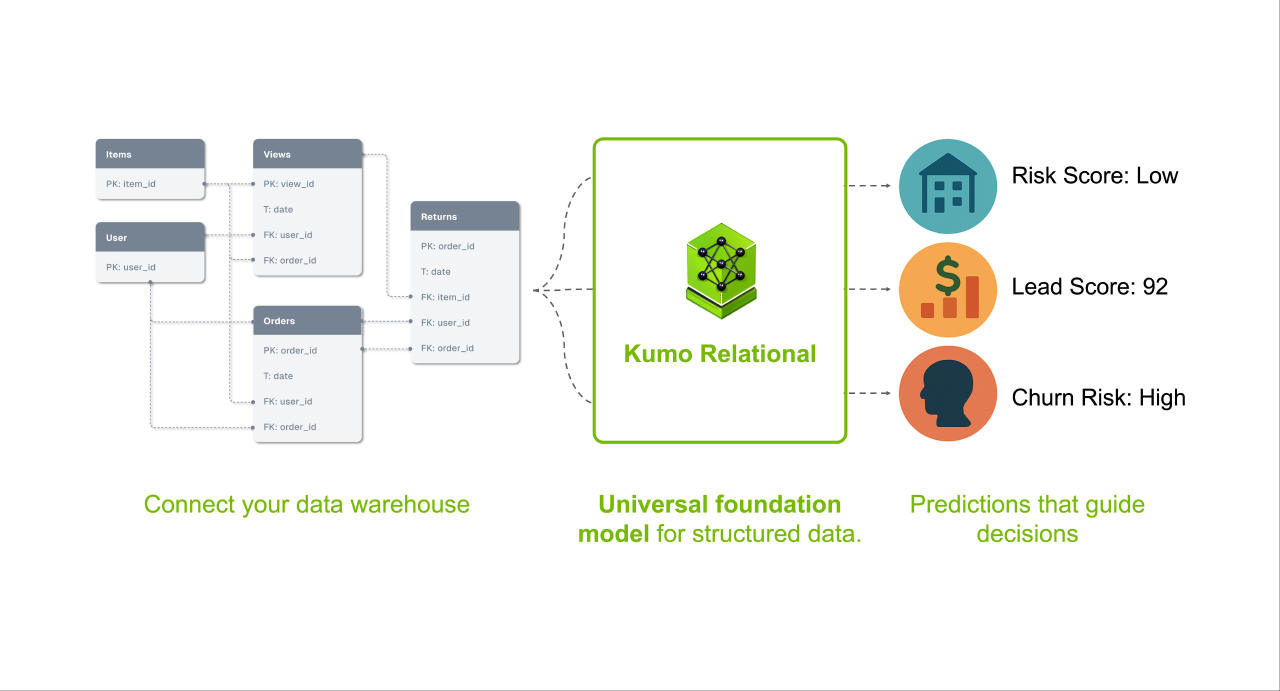 Nuovi modelliNVIDIA Kumo Relational batte il ML supervisionato sui dati relazionali senza trainingHerald of AI
NVIDIA Kumo Relational batte il ML supervisionato sui dati relazionali senza training
Un nuovo modello base pre-addestrato prevede risultati direttamente sui database enterprise, senza bisogno di feature engineering o training specifico per task.
 Come funzionaGoogle lancia TorchTPU, un backend nativo per PyTorch su TPU nel cloudHerald of AIhttps://github.com/soumith, CC BY-SA 4.0, via Wikimedia Commons
Google lancia TorchTPU, un backend nativo per PyTorch su TPU nel cloud
Un nuovo stack open-source permette agli sviluppatori di far girare modelli PyTorch direttamente sui chip TPU di Google, sostituendo il vecchio sistema PyTorch/XLA.