Mirendil lancia Fern 0.1, un modello di IA che può leggere 10 milioni di token in una volta
Una nuova IA per la programmazione può tenere in memoria un intero progetto software tutto insieme — utile per gli sviluppatori, ma ancora molto indietro rispetto ai migliori modelli nei compiti di coding effettivi.
What you could do with it
- Uno sviluppatore software potrebbe incollare un intero codebase — fino a circa mezzo milione di righe di codice — nel modello e ottenere assistenza in grado di comprendere il progetto nella sua interezza 1.
- Un ricercatore potrebbe caricare giorni di tracce di agent o log di addestramento nel modello per fare debugging delle esecuzioni o verificare i dati senza perdere contesto a causa della troncatura 1.
- Un ingegnere potrebbe usare il modello per eseguire comandi in un terminale ripetutamente finché i test non superano, lavorando su codebase ampie senza doverlo alimentare pezzo per pezzo 1.
A whole codebase in one go
Fern 0.1 può gestire fino a 10 milioni di token di input, che Mirendil stima corrispondano a circa 23 MB di codice o a mezzo milione di righe circa 1. Per farsi un'idea, un grande progetto software come Megatron-LM entrerebbe interamente nella memoria di lavoro del modello in una sola passata .
Il modello è pensato per il lavoro tecnico piuttosto che per la chat informale. Mirendil elenca sei utilizzi principali: lavorare su codebase ampie, eseguire comandi finché i test non superano (agentic coding), fare debugging di esecuzioni di addestramento partendo da log lunghi, leggere tracce intere di agent o di addestramento, e verificare i dati di addestramento alla ricerca di duplicati o spazzatura 1.
How it was built
Fern si basa su Mirendil-Base, un modello preaddestrato da un singolo ricercatore in 3,5 mesi con un costo totale di compute inferiore a 10 milioni di dollari 1. L'addestramento è avvenuto esclusivamente su dati pubblici provenienti da GitHub, pagine web pubbliche e dataset pubblici — senza contenuti in licenza, senza dati distillati da altri modelli e senza dati sintetici . Oltre il 99% del codice usato per costruire il modello è stato scritto da agent IA, mentre il ricercatore umano ha deciso cosa provare e quando intervenire .
Fern 0.1 è il più piccolo dei tre modelli previsti. La versione successiva, Mirendil-Base-Large, è già oltre l'80% nell'addestramento iniziale e la più grande, Mirendil-Base-XL, è oltre il 20% 1.
How well does it work?
Nei test su contesto lungo, Fern ottiene punteggi molto alti nei compiti semplici. Mirendil-Base (la versione precedente al post-addestramento) ha ottenuto il 100% in un compito di ricerca dell'ago nel pagliaio a ogni lunghezza testata, da 32.000 token fino a 10 milioni di token 1. Il ragionamento multihop, però, è sceso al 45% alla lunghezza massima .
Per quanto riguarda il coding reale, Fern 0.1 si colloca a metà classifica. Su Terminal Bench 4.0, un test che chiede a un'IA di correggere codice in un terminale vero, ha ottenuto solo il 6,1% — contro il 66,4% di Claude Opus 5.5 nella tabella comparativa di Mirendil 1. Ha superato alcuni modelli aperti più piccoli in altri test, ma è rimasto dietro a tutti i modelli frontier e ai grandi modelli open .
Mirendil afferma che la loss del modello (una misura della qualità delle previsioni) ha continuato a migliorare anche oltre 1 milione di token, punto in cui altri modelli smettono di riportare dati 1. A una finestra di 1 milione di byte, Fern ha ottenuto 0,165 bit per byte contro i 0,140 di Kimi K3 — non il migliore a parità di contesto, ma ancora in miglioramento su lunghezze maggiori .
percentage of coding tasks correctly solved in a real terminal. Più alto è meglio. Numeri: Mirendil. Grafico di Herald of AI.
Who can use it
Fern 0.1 è disponibile esclusivamente tramite accesso anticipato in hosting; non sono stati annunciati pesi aperti né versioni scaricabili 1. Si può richiedere l'accesso attraverso il sito web di Mirendil 2. Il modello conta tra 0,1 e 0,5 trilioni di parametri, sebbene Mirendil non abbia rivelato il conteggio esatto .
Quest'articolo tratta un trend solo a scopo informativo. Non costituisce consiglio né invito a fare alcuna di queste cose.
I fatti principali
- Fern 0.1 ha una context window di 10 milioni di token, che contiene circa 23 MB di codice alla volta
- Creato da un singolo ricercatore più agent IA in 3,5 mesi per meno di 10 milioni di dollari
- Ottiene il 100% nel recupero semplice a lungo contesto ma solo il 6,1% su Terminal Bench 4.0
- Disponibile solo via accesso anticipato in hosting; nessun peso aperto annunciato
- Due modelli più grandi già in sviluppo da Mirendil
Fonti
Notizie collegate
 La settimanaQuesta settimana in AI: nuovi modelli a profusione e agent più sicuriHerald of AI
Questa settimana in AI: nuovi modelli a profusione e agent più sicuri
Rilasci importanti di pesi aperti, risultati sulla velocità e un impegno a rendere gli agent di intelligenza artificiale più affidabili e protetti.
 Nuovi modelliKimi K3.1 Pro, un modello di intelligenza artificiale cinese scaricabile da chiunque, quasi eguaglia Claude Opus 5.5Herald of AI
Kimi K3.1 Pro, un modello di intelligenza artificiale cinese scaricabile da chiunque, quasi eguaglia Claude Opus 5.5
Il modello da 2,8 trilioni di parametri di Moonshot AI segna 55 su Artificial Analysis, tre punti dietro Claude Opus 5.5, costa la metà e i suoi pesi completi — i file che permettono a chiunque di eseguirlo autonomamente — saranno disponibili entro il 4 novembre.
 Nuovi modellivLLM Hyper-Optimizza Kimi K3 su NVIDIA GB300 per Inferenza RapidissimaHerald of AI
vLLM Hyper-Optimizza Kimi K3 su NVIDIA GB300 per Inferenza Rapidissima
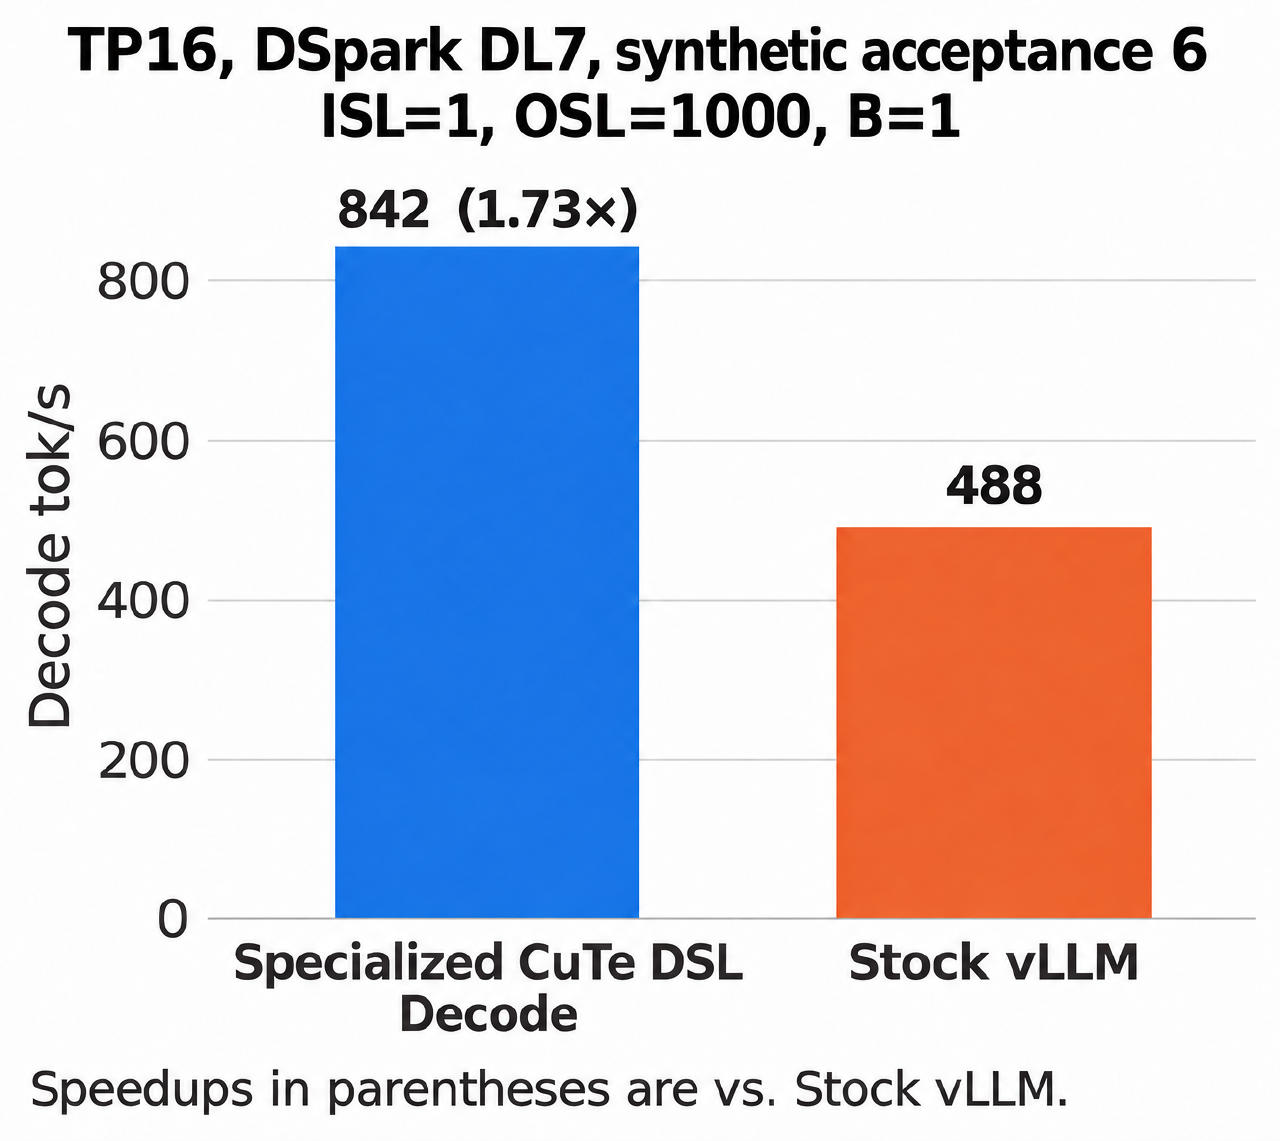
Nuove ottimizzazioni spingono il decoding di Kimi K3 oltre 840 token al secondo con batch 1 su 16 GPU NVIDIA GB300 con DSpark.
 Nuovi modelliStepFun rilascia i pesi open source del suo modello Step 5 Preview da 600BHerald of AI
StepFun rilascia i pesi open source del suo modello Step 5 Preview da 600B
Il laboratorio cinese di intelligenza artificiale ha reso disponibile il suo grande modello Mixture-of-Experts per l'auto-hosting, rivolto agli sviluppatori che creano agenti di programmazione e strumenti per la finanza.