Come la nuova libreria di NVIDIA fa previsioni senza tabelle di addestramento
Structured Data Models di NVIDIA permette di ottenere previsioni accurate dai fogli di calcolo semplicemente fornendo esempi all'AI.
Uno strumento con un'unica interfaccia per i dati tabellari
NVIDIA ha rilasciato una nuova libreria chiamata Structured Data Models che porta dietro una singola interfaccia PyTorch i modelli Foundation già addestrati per i dati in stile foglio di calcolo. Invece di passare ore ad addestrare un modello sui propri dati, puoi consegnare al sistema un insieme di esempi etichettati e chiedergli di prevedere le risposte per nuove righe in un colpo solo.
La libreria racchiude diversi modelli: TabICLv2 per compiti di classificazione su una singola tabella, KumoTabular per regressione e classificazione tabellare, e KumoRelational per intere basi di dati con più tabelle collegate. Ogni modello usa una tecnica chiamata apprendimento in contesto (in-context learning), in cui legge righe di esempio etichettate e poi produce probabilità per le righe che si vogliono prevedere. Si ricevono distribuzioni di previsione complete, non semplici indovinelli.
Come funziona in pratica
Per usare la libreria, si forniscono due cose: un batch di righe che hanno già risposte note, e le nuove righe che si vogliono far prevedere. Il modello elabora entrambi insieme in un solo passaggio e restituisce le sue risposte. Si possono anche riutilizzare lo stesso insieme di esempi etichettati per molte query di previsione diverse, il che fa risparmiare tempo.
Nei test, i modelli preaddestrati sono stati confrontati con strumenti standard di scikit-learn come gradient boosting e regressione logistica. I modelli per dati strutturati hanno reggito ragionevolmente bene senza alcun addestramento, anche se non sono sempre migliori di modelli costruiti specificamente per un compito. La libreria gestisce anche gli intervalli di previsione per la regressione, che danno un intervallo di valori probabili anziché un singolo numero 1.
Attenzione alle insidie
Il tutorial avverte di alcuni problemi silenziosi. Una fase di pre-elaborazione rimuove automaticamente le colonne con timestamp e testo senza avvisare, il che potrebbe eliminare informazioni utili dai dati. Un altro problema riguarda uno strumento di spiegazione con due note insidie che può dare risultati fuorvianti.
C'è anche un intoppo tecnico durante l'installazione della libreria. Il sistema che gestisce i dati relazionali ha bisogno di un pacchetto chiamato pyg-lib, ma il messaggio di errore che la libreria produce punta alla pagina di download sbagliata. La soluzione consiste nel costruire manualmente l'URL corretto partendo dai numeri di versione maggiore e minore, invece di seguire il consiglio della libreria.
Oltre le singole tabelle
Una delle funzionalità più interessanti è la possibilità di lavorare con intere basi di dati relazionali. Il tutorial dimostra la costruzione di un piccolo database commerciale con tre tabelle collegate e l'uso del modello per prevedere l'attività dei clienti direttamente dai dati connessi. La differenza chiave tra un modello relazionale corretto e uno difettoso dipende dal fatto che i dati di una tabella siano accidentalmente trapelati nelle previsioni di un'altra — qualcosa che la libreria gestisce con cura quando usata correttamente 1.
Il codice completo del tutorial è disponibile su GitHub, bloccato a un commit specifico per corrispondere alla configurazione testata.
I fatti principali
- La libreria Structured Data Models di NVIDIA non richiede addestramento per fare previsioni
- Usa l'apprendimento in contesto (in-context learning), in cui gli esempi etichettati fungono da prompt
- La libreria racchiude i modelli TabICLv2, KumoTabular e KumoRelational
- Una fase di pre-elaborazione rimuove in modo silenzioso le colonne con timestamp e testo per impostazione predefinita
- La libreria può prevedere da intere basi di dati relazionali, non solo da singole tabelle
Fonti
Notizie collegate
 Come funzionaUn nuovo motore permette ai modelli AI piccoli di rispondere in meno di 50 millisecondiHerald of AI
Un nuovo motore permette ai modelli AI piccoli di rispondere in meno di 50 millisecondi
Liquid AI afferma che il suo strumento permette all'AI generativa di sostituire vecchi modelli per i controlli antifrode, i pagamenti e la ricerca — senza rallentare le operazioni.
 Nuovi modelliRecursive Releases Flint, a 40B Open-Weight Local Coding Model for AgentsHerald of AI
Recursive Releases Flint, a 40B Open-Weight Local Coding Model for Agents
Flint è il primo modello di Recursive Superintelligence: un agente di codifica locale veloce che gira su hardware consumer.
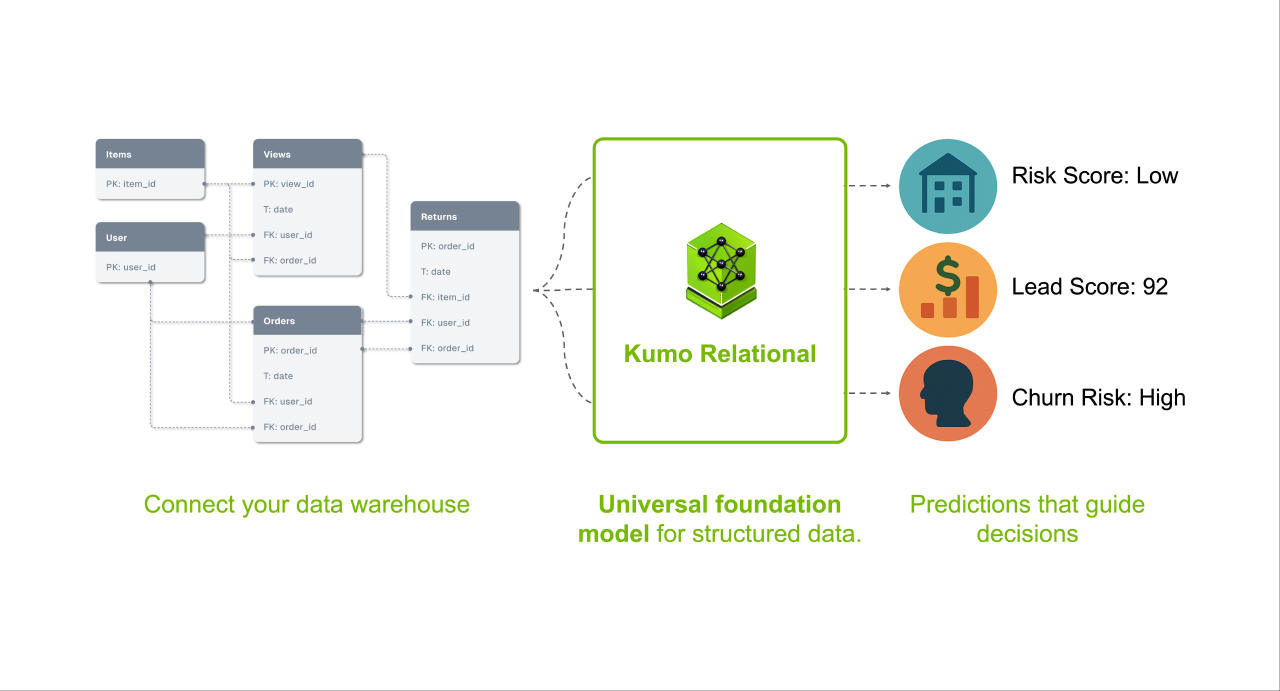 Nuovi modelliNVIDIA Kumo Relational batte il ML supervisionato sui dati relazionali senza trainingHerald of AI
NVIDIA Kumo Relational batte il ML supervisionato sui dati relazionali senza training
Un nuovo modello base pre-addestrato prevede risultati direttamente sui database enterprise, senza bisogno di feature engineering o training specifico per task.
 Come funzionaGoogle lancia TorchTPU, un backend nativo per PyTorch su TPU nel cloudHerald of AIhttps://github.com/soumith, CC BY-SA 4.0, via Wikimedia Commons
Google lancia TorchTPU, un backend nativo per PyTorch su TPU nel cloud
Un nuovo stack open-source permette agli sviluppatori di far girare modelli PyTorch direttamente sui chip TPU di Google, sostituendo il vecchio sistema PyTorch/XLA.