Agentes de IA ClawLoop que se autoenseñan para mejorar
Un nuevo marco de entrenamiento permite que los agentes de IA mejoren por su cuenta sin necesidad de un modelo profesor más potente que los guíe en cada paso.
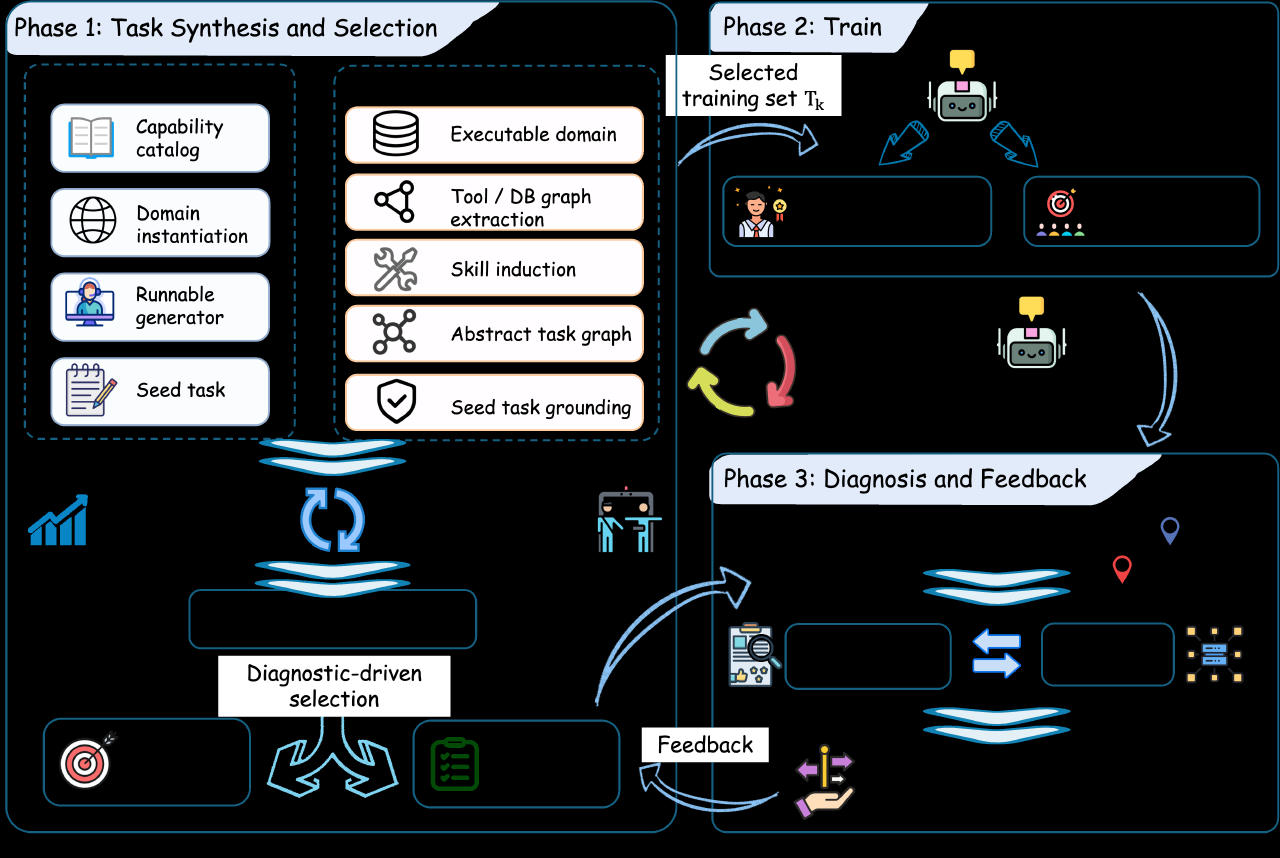
Cómo funciona
Un sistema que se autoentrena y permite que los agentes de IA mejoren alimentando sus propios errores de nuevo en el ciclo de entrenamiento.
- Crear un conjunto variado de tareas de práctica
- Entrenar al agente con ejemplos y recompensas
- Diagnosticar las debilidades y enviar los resultados al primer paso
Adivina
¿Qué guía al agente de ClawLoop durante el entrenamiento?
ClawLoop elimina la necesidad de un maestro más fuerte usando los propios errores del agente como combustible para el entrenamiento.
Un ciclo que se alimenta a sí mismo
Qwen ya es uno de los modelos de lenguaje de código abierto más potentes disponibles, pero un equipo de investigadores, incluido Hansi Yang de Alibaba, ha encontrado una manera de mejorarlo aún más sin necesidad de un modelo más potente que lo coordine. Llamaron a este enfoque ClawLoop, y funciona convirtiendo los propios errores del agente en combustible para su próxima ronda de mejora.
La mayoría de los pipelines de entrenamiento para agentes de IA dependen de un modelo profesor externo. Ese modelo más potente plantea las tareas, recopila ejemplos de cómo se desempeña el estudiante, y un investigador humano revisa los resultados. Esta configuración tiene un techo difícil de superar: el estudiante nunca puede superar al profesor, y el progreso depende de que los humanos interpreten los datos. ClawLoop elimina ambos límites.
Un ejemploInventado para explicarlo
Aria, probando un asistente de código con IA
AriaLe pedí al asistente que escribiera una función. Seguía cometiendo el mismo error.
AssistantEso fue la primera vuelta. Ahora el sistema registra todos los errores que vas detectando.
AriaO sea, que se entrena solo con sus propios fallos, sin tener que estar esperando a que alguien lo corrija?
AssistantAsí es. Los puntos débiles pasan a ser el siguiente conjunto de ejercicios.
Aria¿Y esto sigue y sigue sin necesitar un modelo más potente que lo guíe?
AssistantExacto. Cada vuelta alimenta el diagnóstico de vuelta a la siguiente ronda de entrenamiento.
El asistente mejoró tras ciclos repetidos de entrenamiento al aprender de sus propios errores diagnosticados.
Tres pasos, repetidos
El sistema funciona en un círculo compuesto por tres fases. Primero, Task Synthesis crea un conjunto diverso de desafíos de entrenamiento. Utiliza dos métodos de construcción diferentes para asegurar que las tareas sean variadas, luego incrementa su nivel de dificultad según un diagnóstico de cómo se comportó el agente en la ronda anterior, y las verifica tanto sin el agente como con él presente 1.
A continuación, la fase de Training actualiza al agente utilizando dos técnicas bien conocidas: supervised fine-tuning, donde aprende de ejemplos correctos, y reinforcement learning, donde aprende por ensayo y error con recompensas por buen comportamiento.
Finalmente, Diagnosis and Feedback observa cómo se comporta realmente el agente durante esas corridas de entrenamiento, escribe un informe sobre qué habilidades siguen siendo débiles, y envía ese informe de vuelta a la primera fase para que el próximo conjunto de tareas aborde exactamente esas brechas.
Resultados que se transfieren
Cuando los investigadores probaron ClawLoop usando Qwen3.6-27B como punto de partida, mejoró de manera constante en tres benchmarks: SkillsBench, Claw-Eval-Live y ClawGym-Bench. Pero el hallazgo más convincente llegó cuando tomaron los datos de entrenamiento producidos por el ciclo y los usaron para entrenar modelos más pequeños: Qwen3.5-4B y Qwen3.5-9B. Esos modelos más pequeños también mejoraron en todos los mismos benchmarks, demostrando que los datos de entrenamiento eran genuinamente de alta calidad y no solo útiles debido al modelo grande del ciclo 1.
Por qué importa
La idea clave es que ClawLoop no necesita un modelo más grande o inteligente para guiarlo. Al retroalimentar el diagnóstico propio del agente en su propio ciclo de entrenamiento, puede seguir sobrepasando las capacidades iniciales que tenía. Para la IA de código abierto, donde no existe un único modelo “profesor” dominante, este tipo de ciclo auto-mejorable podría acelerar el progreso de manera independiente a las ventajas propietarias.
El artículo fue enviado a arXiv en octubre de 2026 por investigadores de Alibaba y otras instituciones.
Correcciones y actualizaciones
- Corregido el 21 de octubre de 2026. Una versión anterior afirmaba que las tareas se filtran por dificultad según fracasos anteriores. El artículo indica que su dificultad se incrementa según un diagnóstico de cómo se comportó el agente en la ronda anterior.
Los datos clave
- ClawLoop reemplaza los modelos maestros externos por un ciclo de entrenamiento de tres fases autosostenido
- Task Synthesis, Training, and Diagnosis se retroalimentan mutuamente en un ciclo continuo
- Los datos generados por el bucle mejoraron los modelos más pequeños de Qwen3.5, lo que demuestra la transferibilidad
- El enfoque se probó en SkillsBench, Claw-Eval-Live y ClawGym-Bench
Fuentes
Sigue leyendo
 Cómo funcionaEl QwenGyre de Alibaba acelera el entrenamiento de agentes de IA de ejecución prolongadaHerald of AICómo funciona
El QwenGyre de Alibaba acelera el entrenamiento de agentes de IA de ejecución prolongada
Un nuevo sistema de refuerzo elástico permite que los agentes de codificación con IA funcionen durante horas mientras se entrenan de manera eficiente en hardware costoso de GPU.
 Cómo funcionaInvestigadores desarrollan método para que los modelos de lenguaje grandes respondan más rápidoHerald of AI
 Cómo funcionaMicrosoft descubre la puerta trasera 'Lazarus' que usa pequeños cambios en neuronas para volver a los agentes de IA contra tiHerald of AI
 Cómo funcionaRazonamiento de IA explicado: pensar más tiempo significa encontrar un mejor camino, no solo dar más pasosHerald of AI
Noticias relacionadas
 La semanaEsta semana en IA: llegan nuevos modelos y los agentes se vuelven más segurosHerald of AI
Esta semana en IA: llegan nuevos modelos y los agentes se vuelven más seguros
Grandes lanzamientos de modelos de pesos abiertos, avances de velocidad y un impulso para que los agentes de IA sean más fiables y seguros.
 Nuevos modelosEspecializar el vocabulario de los pequeños modelos de lenguaje reduce el coste de inferencia en un 77%Herald of AI
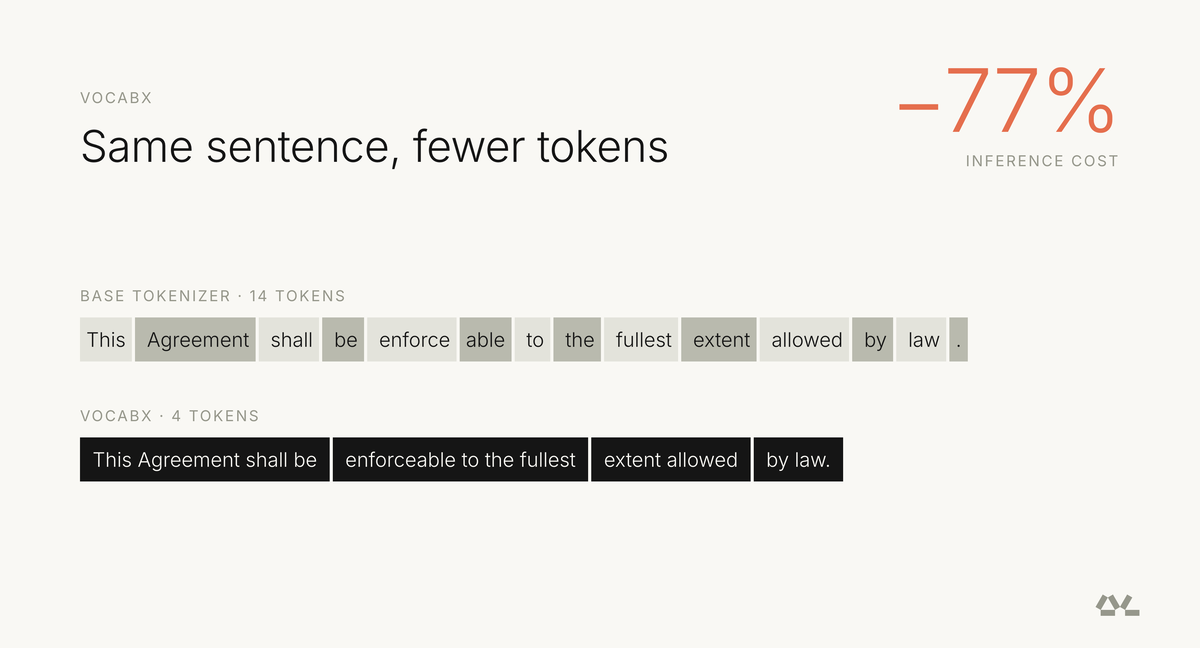
Especializar el vocabulario de los pequeños modelos de lenguaje reduce el coste de inferencia en un 77%
Los investigadores reconstruyeron el tokenizer de un corrector de ensayos en producción en lugar de dejarlo como estaba, mostrando que tratar el vocabulario como una palanca de costes puede reducir los costes de inferencia.
 Nuevos modelosRecursive lanza Flint, un modelo de codificación local de 40B y pesos abiertos para agentesHerald of AI
Recursive lanza Flint, un modelo de codificación local de 40B y pesos abiertos para agentes
Flint es el primer modelo de Recursive Superintelligence: un agente de codificación rápido y local que funciona en hardware de consumo.
 Nuevos modelosMicrosoft lanza Decision-1 para competir en el mercado en rápido crecimiento de modelos de decisión con IAHerald of AI
Microsoft lanza Decision-1 para competir en el mercado en rápido crecimiento de modelos de decisión con IA
El nuevo modelo busca ofrecer decisiones rápidas y precisas para tareas de enrutamiento y clasificación, sumándose a un campo cada vez más lleno de herramientas de IA especializadas.