Un nuevo método de atención acelera los modelos de IA con atajos matemáticos
Un artículo presenta DoSA, que encuentra tokens importantes más rápido usando cotas en lugar de cálculos completos.
El problema de la atención dispersa
Los modelos modernos de IA usan un mecanismo de atención —un proceso que ayuda al modelo a decidir qué partes del texto anterior importan más al generar cada nueva palabra. En los grandes modelos de lenguaje, este paso de atención es una de las partes más lentas al ejecutar el modelo, especialmente con entradas largas.
Los métodos de Sparse attention intentan solucionar esto calculando la atención solo para un pequeño subconjunto de tokens —llamados claves— en lugar de todos. Pero incluso estos métodos eficientes siguen requiriendo puntuar cada clave contra cada cabezal del indexador antes de elegir los mejores candidatos, lo que ralentiza el proceso.
Cómo funciona DoSA
Un nuevo método llamado DoSA, o Dots Sparse Attention, toma un enfoque diferente. En lugar de puntuar todo completamente, usa cotas matemáticas para determinar qué tokens valen la pena examinar más de cerca —y cuáles se pueden ignorar con seguridad.
La idea es que seleccionar los K tokens principales no siempre requiere conocer la puntuación exacta de cada candidato. Un conjunto semilla de tokens ya puntuados proporciona una cota inferior para el umbral ganador. Luego, dos tipos de cotas ayudan a descartar tokens sin necesidad de un cálculo completo:
- Las proyecciones de cabezales no negativos y las cotas residuales conjuntas muestran la contribución positiva máxima que podría tener un token.
- Las cotas de agregación informadas por activación muestran cuánto podría restar un cabezal negativo.
Juntas, estas cotas crean un certificado que señala solo los tokens aún elegibles para una puntuación completa. El filtrado por puntuación exacta luego reduce aún más la cantidad de trabajo necesario para escribir los resultados y hacer las selecciones finales.
Resultados
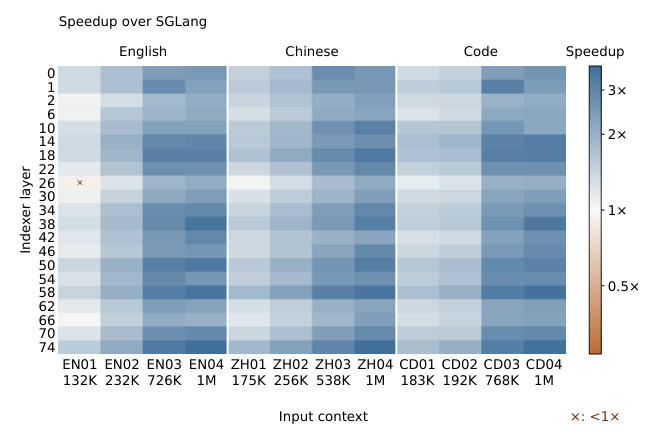
Las pruebas se realizaron en GPUs en tareas de inglés, chino y código. DoSA aceleró el indexador completo hasta 2,74 veces en comparación con SGLang y 1,69 veces en comparación con LiteTopK 1.
Las evaluaciones de punta a punta en GLM-5.2 y DeepSeek-V3.2 lograron aceleraciones de hasta 1,94x y 1,50x en tiempo hasta el primer token sobre las dos líneas base, respectivamente 1.
Por qué importa
Una inferencia más rápida significa que los modelos de IA pueden responder más rápidamente y ejecutarse en hardware menos potente. Esto es especialmente importante para aplicaciones que necesitan baja latencia, como chatbots en tiempo real o dispositivos con capacidad de cómputo limitada. Al reducir la cantidad de cálculos necesarios en la atención dispersa —uno de los pasos más pesados en términos de cómputo—, DoSA facilita ejecutar modelos grandes de manera eficiente.
El artículo también incluye un análisis de cómo la geometría y los márgenes de selección afectan el rendimiento, ofreciendo una visión de cuándo y por qué el método funciona mejor.
El trabajo fue publicado en arXiv por Fanxu Meng y Taosong Fang en septiembre de 2026 1.
Correcciones y actualizaciones
- Corregido el 20 de octubre de 2026. Una versión anterior de esta historia incluía detalles que sus fuentes no respaldan. Han sido corregidos o eliminados.
Los datos clave
- DoSA usa cotas matemáticas para omitir la puntuación completa de tokens irrelevantes en la atención dispersa
- Las pruebas en GPU mostraron una aceleración del indexador de hasta 2,74x sobre SGLang y 1,69x sobre LiteTopK
- Se reportaron aceleraciones de punta a punta de 1,94x (GLM-5.2) y 1,50x (DeepSeek-V3.2)
- El método es sin pérdidas, lo que significa que preserva la selección exacta de tokens
- Las pruebas abarcaron cargas de trabajo en inglés, chino y código