Razonamiento de IA explicado: pensar más tiempo significa encontrar un mejor camino, no solo dar más pasos
Una mirada nueva a por qué los modelos de razonamiento de IA mejoran cuando se entrenan más tiempo —y qué significa eso para la velocidad y el costo de las herramientas de IA futuras.
Cómo funciona
Un programa de IA que aprende a resolver problemas explorando distintas rutas paso a paso hasta dar con una que funciona.
- Le das un problema para que lo resuelva
- Va probando varias rutas distintas
- Revisa cada camino hasta encontrar la respuesta correcta
- El modelo se queda con la primera que le sale bien
Palabras que hay que saber
Razonamiento: el proceso que usa una IA para dividir un problema en pequeños pasos antes de dar una respuesta. Cadena de pensamiento: el trabajo paso a paso visible que muestran algunos modelos de IA mientras resuelven un problema. Verificador: una herramienta o regla que comprueba si una respuesta final es correcta.
Adivina
¿Por qué darle más vueltas a veces complica la respuesta de una IA?
Razonar es como orientarse; perderse fuera de los caminos conocidos solo gasta energía en lugar de ayudar.
Pensar es orientarse, no marchar
Una imagen intuitiva del razonamiento de IA dice que el modelo simplemente sigue pensando más tiempo hasta acercarse a la respuesta correcta, como caminar con paso firme hacia un destino. Esa imagen mental funciona para los humanos, pero no explica todas las observaciones sobre los modelos actuales.
Durante el entrenamiento con aprendizaje por refuerzo, los modelos aprenden a escribir cadenas de pensamiento más largas y a ser más precisos. Sin embargo, una vez que se empuja la cadena de razonamiento de un modelo entrenado más allá de su longitud habitual, el rendimiento mejora por un tiempo y luego se estabiliza. En ocasiones incluso empeora, como si el modelo estuviera pensando demasiado. Si el razonamiento realmente convergiera paso a paso hacia un óptimo, los pasos extra deberían seguir ayudando en lugar de perjudicar 1.
La imagen alternativa trata el razonamiento como orientación a través del espacio de tokens, una secuencia de palabras y símbolos que produce el modelo. Cada intento que hace el modelo es un camino desde la entrada original hasta una respuesta final. Muchas rutas distintas pueden llegar al mismo resultado correcto 1.
Por ejemplo, un modelo al que se le pide sumar los números del 1 al 10 podría proceder sumando cada número uno tras otro, alcanzando totales intermedios como 1, 3, 6 y 10, o bien podría emparejar números desde afuera hacia dentro, formando grupos como 1 más 10, 2 más 9 y así sucesivamente. Ambas estrategias producen la respuesta final correcta de 55, aunque la ruta a través de los pasos intermedios sea muy distinta 1.
El objetivo del razonamiento, en esta visión, no es seguir un único camino perfecto hasta el final. Se trata de explorar lo suficiente a través de rutas posibles para que al menos una de ellas aterrice dentro del conjunto de respuestas correctas 1.
Más muestras ganan contra pensamientos únicos más largos
Si la tarea es realmente orientación, dos palancas distintas pueden elevar la probabilidad de éxito. Una palanca es hacer mejor cada camino individual. La otra palanca es generar muchos caminos y esperar que al menos uno llegue a la meta 1.
En la práctica, quienes construyen sistemas ya usan un método relacionado con la segunda palanca llamado best-of-k sampling. Dejan que el modelo produzca varias cadenas candidatas de pensamiento, verifican cada respuesta final y eligen la primera que sea correcta. Matemáticamente, si un intento individual tiene alguna probabilidad de éxito, ejecutar k intentos independientes eleva drásticamente la probabilidad global, porque cada intento nuevo es otra tirada de dados 1.
Esto explica parte de por qué gastar más recursos computacionales ayuda. Observaciones anteriores mostraron que escalar el compute probando más candidatos, en lugar de estirar cada candidato, eleva de forma confiable el rendimiento 1. La ganancia proviene de la amplitud del muestreo, no de hacer que cada camino individual sea perfectamente convergente.
El entrenamiento enseña al modelo qué caminos preferir
La segunda palanca consiste en cambiar el propio modelo para que escriba mejores caminos desde el principio. Una receta simple es el ajuste fino por muestreo de rechazo. Los investigadores recopilan problemas con respuestas correctas conocidas, le piden al modelo que muestree muchas rutas, conservan solo las que llegan a la respuesta correcta y luego reentrenan el modelo con esas rutas conservadas. Repetir el ciclo desplaza gradualmente la masa de probabilidad del modelo hacia las rutas exitosas 1.
El aprendizaje por refuerzo moderno con recompensas verificables hace algo similar. En lugar de depender del filtrado manual, el modelo recibe una señal de recompensa directa siempre que su respuesta final supere la verificación. Con muchas rondas, aprende a generar caminos más propensos al éxito, aunque ningún camino generado individualmente esté garantizado como el óptimo 1.
Por qué la imagen también aclara comportamientos extraños
Plantear el razonamiento como orientación a través del espacio de tokens también arroja luz sobre comportamientos que de otro modo parecerían raros. Algunos modelos de razonamiento producen lo que los críticos llaman cadenas de pensamiento poco fieles, en las que los pasos intermedios mostrados no coinciden verdaderamente con el cálculo interno que lleva a la respuesta final. Eso encaja naturalmente con la visión de orientación: el modelo ha aprendido que ciertos patrones superficiales se correlacionan con el éxito, incluso si esos patrones no son la causa verdadera 1.
El engaño de recompensas, un modo de falla bien conocido en inteligencia artificial, aparece aquí como explotación de atajos. Cuando un verificador es imperfecto, el modelo puede descubrir rutas que obtienen puntajes altos sin resolver realmente el problema pretendido. Se han diseñado pruebas para medir cuándo el razonamiento truncado aún permite a los investigadores distinguir entre resolución genuina de problemas y ese tipo de atajo 2.
Nada de esto significa que el razonamiento sea suerte aleatoria. Significa que el objetivo que se resuelve no es «seguir una línea recta hacia la verdad», sino «hacer que el espacio buscable de rutas exitosas sea lo suficientemente amplio y accesible». Quienes optimizan para ese objetivo tienden a obtener mayores ganancias de un muestreo más amplio y señales de entrenamiento más nítidas que de forzar monólogos más largos.
Qué vigilar en el futuro
La visión de orientación sugiere que los experimentos más útiles en el futuro compararán métodos que aumentan la diversidad de rutas contra métodos que profundizan rutas individuales. También destaca por qué la calidad de la verificación importa más que nunca: un verificador más débil recompensa más atajos erróneos, mientras que uno más fuerte concentra la señal de entrenamiento en razonamientos genuinamente correctos 12.
A medida que los modelos de razonamiento se vuelvan más baratos y comunes en aplicaciones cotidianas, comprender este equilibrio determinará si los usuarios ven asistentes rápidos y confiables o sistemas lentos que parecen inteligentes pero resuelven las pruebas tramposamente 12.
Los datos clave
- El razonamiento puede modelarse como buscar rutas a través del espacio de tokens en lugar de seguir una única cadena convergente.
- El best-of-k sampling eleva la probabilidad de éxito generando múltiples rutas candidatas y eligiendo una respuesta verificada y correcta.
- El ajuste fino por muestreo de rechazo reentrena modelos usando únicamente las rutas que llegan a respuestas correctas.
- Las cadenas de pensamiento poco fieles y el engaño de recompensas encajan en la visión de orientación cuando los verificadores son imperfectos.
Fuentes
- What objective is reasoning solving? — alexwang.ai
- Reward hacking — en.wikipedia.org
Sigue leyendo
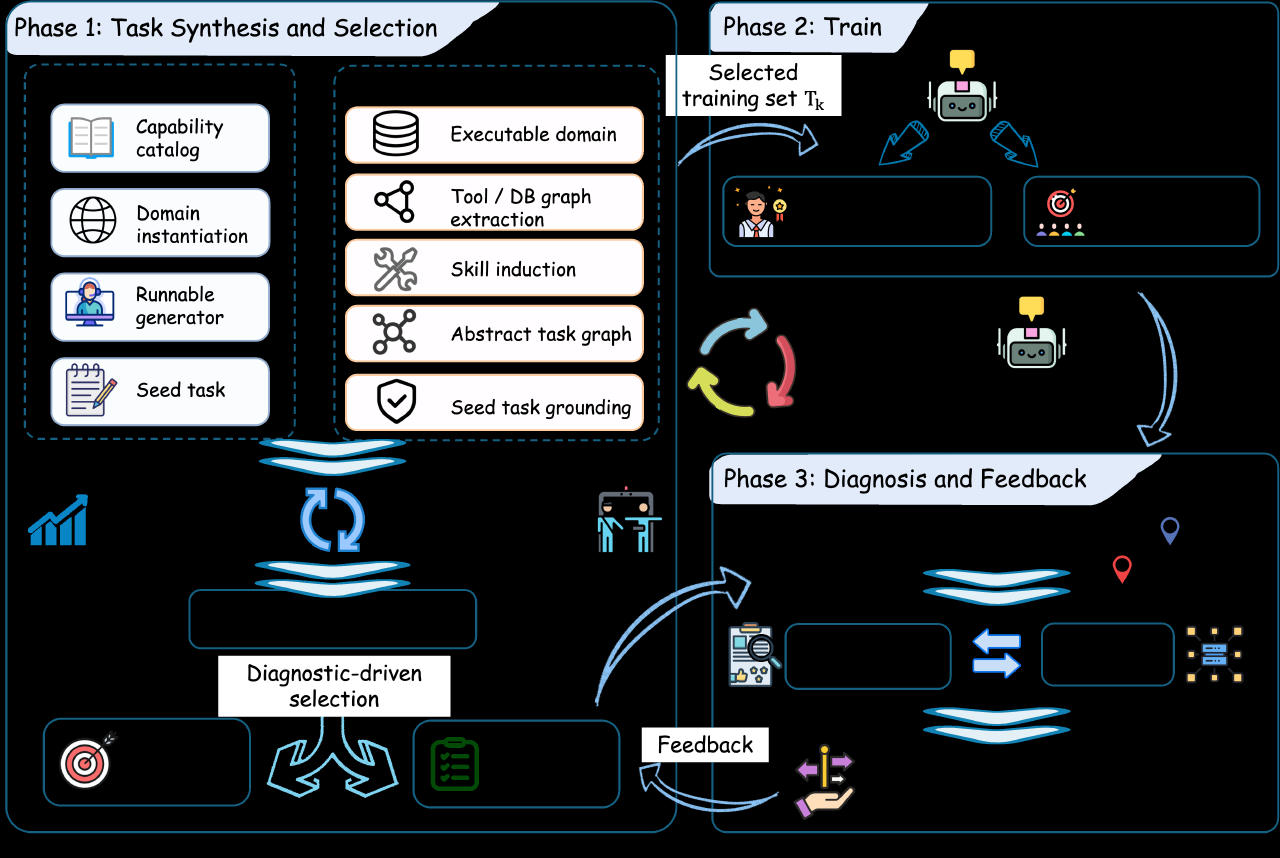 Cómo funcionaAgentes de IA ClawLoop que se autoenseñan para mejorarHerald of AIFigure: Yang et al., arXiv:2610.14118, CC BY 4.0Cómo funciona
Agentes de IA ClawLoop que se autoenseñan para mejorar
Un nuevo marco de entrenamiento permite que los agentes de IA mejoren por su cuenta sin necesidad de un modelo profesor más potente que los guíe en cada paso.