PeekKV un metodo più intelligente per comprimere la memoria AI che migliora la velocità del contesto lungo
I ricercatori hanno scoperto che osservare un solo token può determinare quali parti della memoria di un modello linguistico di grandi dimensioni sono rilevanti, riducendo i costi senza perdere accuratezza.
Il problema della memoria nelle conversazioni AI lunghe
Man mano che i modelli linguistici di grandi dimensioni gestiscono input sempre più lunghi, si trovano di fronte a un collo di bottiglia crescente: la cache KV. Questa cache conserva le informazioni che il modello deve ricordare dalle parti precedenti di una conversazione, ma le sue dimensioni crescono in modo lineare con la lunghezza del contesto, rendendola costosa per i servizi che eseguono questi modelli.1
Questo ha portato i ricercatori a cercare modi per comprimere la cache KV. Invece di mantenere tutto con la stessa importanza, alcuni metodi cercano di conservare solo le parti più utili e scartare il resto.
Un esempioInventato per spiegare
Elena studia articoli di ricerca sull'AI
ElenaHo trovato un trucco simpatico per prolungare le chat con l'AI usando meno memoria.
BenCome fa a non perdere il filo di quel che hai detto?
ElenaDopo aver letto tutto una volta, si concentra su un solo token per capire cosa conta e tiene solo quello.
BenMa c'è già qualche app AI che lo fa davvero?
ElenaPer ora no — il documento dice che è ancora solo ricerca, niente nei prodotti per i consumatori.
Ben ha capito come un controllo su un singolo token potrebbe cambiare il futuro delle conversazioni lunghe a basso costo.
Perché i metodi esistenti faticano
I ricercatori dietro la nuova tecnica, Minyoung Go e Yongjun Park, hanno scoperto una ragione chiave per cui gli approcci attuali sono incoerenti. Hanno rilevato che le testine di attenzione — le parti del modello che decidono a quali informazioni prestare attenzione — cambiano tra due fasi dell'elaborazione del testo da parte di un modello linguistico.
La prima fase, chiamata prefill, legge l'intero input in una sola volta. La seconda fase, chiamata decode, genera la risposta token per token. Sorprendentemente, anche all'interno di un singolo input, testine diverse diventano attive tra queste due fasi.1
Tuttavia, hanno anche scoperto qualcosa di importante riguardo alla fase decode. Una volta filtrati i token di formato — frammenti di testo che sono solo struttura come elenchi puntati o intestazioni di sezione piuttosto che contenuto vero e proprio — l'insieme delle testine attive è rimasto sorprendentemente stabile su tutti i token di contenuto nella risposta.1
Il trucco del singolo token
Questa intuizione ha portato i ricercatori a sviluppare PeekKV, un metodo che non richiede profilatura offline né addestramento. Funziona invece su qualsiasi modello o carico di lavoro fin da subito.
L'idea centrale è semplice ma potente: dopo il completamento della fase prefill, PeekKV esamina un solo token di contenuto. Questo singolo sguardo è sufficiente per capire quali gruppi di testine sono più importanti e quali token all'interno di ogni gruppo portano il peso maggiore.1
Utilizzando questi punteggi, il sistema distribuisce il proprio budget limitato di cache KV tra i gruppi di testine in proporzione alla loro importanza, e all'interno di ogni gruppo mantiene solo i token con il punteggio più alto.1
Ciò significa che PeekKV si adatta a qualsiasi input riceve, anziché affidarsi a ipotesi fisse su quali parti del modello saranno sempre rilevanti.
Indovina
Quanta memoria usa PeekKV mantenendo una precisione quasi completa?
Ha mantenuto il 95,7% di accuratezza usando solo il 10% del budget di memoria su RULER.
Risultati attraverso i benchmark
I ricercatori hanno testato PeekKV su quattro benchmark pubblici. Ha ottenuto la migliore accuratezza in oltre la metà dei confronti per modello contro i metodi di compressione più avanzati.
Su Llama-3.1-8B-Instruct in particolare, PeekKV ha mantenuto il 95,7% dell'accuratezza della cache completa utilizzando solo il 10% della memoria su RULER, un benchmark per il ragionamento su contesti lunghi di 16.000 token. Su LongBench, ha mantenuto il 95,9% dell'accuratezza completa con appena il 1,5% del budget di memoria.1
Il documento è stato sottoposto ad arXiv nell'ottobre 2026 dai ricercatori Minyoung Go e Yongjun Park.
Questa storia riporta una tendenza a scopo puramente informativo. Non costituisce un consiglio né un incoraggiamento a compiere alcuna di queste azioni.
Correzioni e aggiornamenti
- Corretta in data 23 ottobre 2026. Una versione precedente includeva nomi di modelli e formulazioni specifici non presenti nella fonte; le versioni corrette allineano il testo al wording effettivo della fonte riguardo a PeekKV che si applica direttamente a carichi di lavoro e modelli mai visti, e riguardo ai LLM che affrontano colli di bottiglia della cache KV senza nominare modelli specifici.
I fatti principali
- PeekKV utilizza un solo token dopo la fase di prefill per determinare quali componenti di memoria sono più importanti
- Su Llama-3.1-8B-Instruct, ha mantenuto il 95,7% di accuratezza con un budget di memoria al 10% sul benchmark RULER
- Ha mantenuto il 95,9% di accuratezza con solo l'1,5% di memoria su LongBench
- Il metodo non richiede profilazione offline né addestramento e si applica direttamente a carichi di lavoro non visti e a nuovi modelli
- I test di attenzione si attivano in modo diverso tra le fasi di prefill e decode all'interno di un singolo input
Fonti
Continua a leggere
 Come funzionaNuova tecnica rende i modelli linguistici diffusion più veloci senza perdere qualitàHerald of AICome funziona
Nuova tecnica rende i modelli linguistici diffusion più veloci senza perdere qualità
I ricercatori hanno scoperto che compiti diversi richiedono livelli di precisione diversi nelle varie fasi della generazione del testo, e hanno sviluppato un sistema che si regola automaticamente.
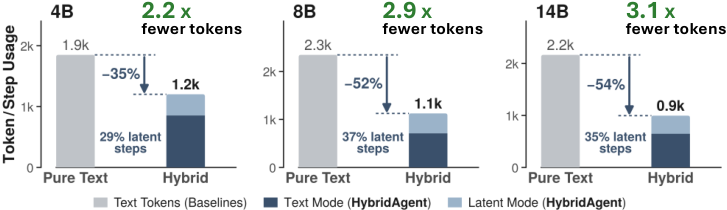 Come funzionaNuovi agenti AI passano dal ragionamento latente al testo, riducendo i costi nei testHerald of AI▶Figure: Zou et al., arXiv:2610.18861, CC BY 4.0
 Come funzionaChrome può ora recuperare informazioni dalla tua Gmail per compilare automaticamente i moduli onlineHerald of AI▶
 Come funzionaCompressione ThinkBit a due bit: il ragionamento dell'AI rimane affilato e i costi di inferenza si riducono dell'8×Herald of AI