NVIDIA apre due strumenti gratuiti per eseguire cloud computing basato su GPU dedicato all'AI
NVIDIA ha reso gratuito il suo software di gestione dei cluster, così le aziende possono permettere ai clienti di noleggiare computer pronti per l'AI sulle proprie schede grafiche.
Cosa potresti farci
- Un'azienda che possiede una flotta di server NVIDIA con GPU potrebbe lanciare un servizio Kubernetes gestito per i propri clienti senza scrivere da zero il software di gestione del cluster 1.
- Un team di piattaforma AI potrebbe provisionare ogni cliente con un cluster Kubernetes indipendente — il proprio piano di controllo, database etcd e nodi worker — attraverso un'API REST e kubectl 2.
- Un operatore potrebbe fissare versioni precise del software a generazioni specifiche di GPU in ricette dichiarative, poi costruire immagini container firmate, immagini OS, Helm charts e SBOM automaticamente 1.
Cosa fanno gli strumenti
Per anni, se possedevi un rack di server grafici NVIDIA e volevi vendere tempo su di essi a diversi team AI — o al tuo stesso gruppo prodotti — dovevi assemblare da solo questo strato di gestione a partire da pezzi di software open-source, prodotti commerciali e codice personalizzato, per poi mantenerlo funzionante attraverso ogni nuova versione di ogni componente.
NVKE fornisce la superficie di controllo per questo lavoro: un'interfaccia di programmazione delle applicazioni e controller in background installati su un piccolo cluster di gestione che accettano richieste come 'crea un cluster per un cliente', 'aggiungi dieci nodi worker', 'aggiorna Kubernetes' o 'sostituisci un nodo guasto'. I clienti si collegano tramite il consueto strumento a riga di comando kubectl e ricevono cluster ordinari con piani di controllo isolati 2.
NVKR è la fabbrica di costruzione complementare. Prende liste dichiarative — chiamate Definitions — che fissano versioni precise del software a generazioni precise di GPU, le compila in pacchetti eseguibili, immagini container, immagini Linux per nodi bare-metal e file di configurazione Helm, e aggiunge firme crittografiche, certificati dei materiali software e record di provenienza a ogni artifact 1.
Entrambi sono rilasciati sotto licenza open-source Apache 2.0 e sono stati annunciati come componenti della più ampia NVIDIA DSX AI Factory Platform, un pacchetto rivolto alle organizzazioni che gestiscono flotte GPU come provider cloud interni o esterni 1.
Come viene messo insieme
Un operatore inizia bootstrappando un cluster temporaneo di prova a singolo nodo, poi NVIDIA Infra Controller provisiona tre server CPU per il piano di gestione e li avvia da un'immagine costruita da NVKR 12. Un terzo progetto, CAPNICo, fa da ponte tra il controller infrastrutturale e il framework Cluster API di Kubernetes stesso, così che il piano di gestione possa comunicare con server bare-metal .
Quando un cliente richiede un cluster, NVKE assegna il proprio piano di controllo, database etcd e insieme di nodi worker — tutti in esecuzione su Kubernetes upstream più kubeadm — e installa OVN-Kubernetes per la rete e NodeLocal DNSCache per la risoluzione rapida dei nomi 1. Ogni nodo deve dimostrare la propria identità tramite SPIFFE e Trusted Platform Module prima di ricevere le credenziali di join; è disponibile la cifratura per-cluster per il datastore etcd 2. Un template OpenTelemetry invia log, metriche e tracce tramite protocollo OTLP così che gli operatori possano monitorare tutto da un unico posto .
All'interno dei cluster di lavoro, tre progetti complementari colmano le lacune che Kubernetes vanilla lascia per l'AI: AI Cluster Runtime gestisce scheduling e isolamento GPU, NodeWright gestisce pacchetti a livello di nodo, e NVSentinel fornisce automazione break-fix 1.
Chi lo sta già usando
Quattro partner cloud — Firmus, SK Telecom, Mirantis e Spectro Cloud, tra gli altri — stanno integrando NVKE o aggiungendo componenti ai propri prodotti Kubernetes gestiti; Netris sta abilitando NVKE per l'automazione di rete 1. La CNCF ha certificato che NVKE crea cluster conformi testati contro Kubernetes versione 1.36, guadagnandosi sia il badge Certified Kubernetes Installer sia il badge Certified Kubernetes AI Platform .
Una valutazione locale può essere eseguita su un singolo host Linux o VM Mac con appena sei CPU, dodici gigabyte di memoria e cento gigabyte di disco — nessuna GPU, nessun conto NVIDIA richiesto 12. Le installazioni di produzione richiedono capacità iscritta a NICo, un build host abilitato KVM e un registro container .
Il retroscena
La documentazione di NVKE riporta un avviso esplicito: il progetto è in anteprima pubblica, le API possono cambiare tra le versioni e NVIDIA non lo raccomanda per carichi di lavoro di produzione 23. Oltre a questa dicitura generale, il riassunto di MarkTechPost segnala due lacune concrete — dopo l'installazione l'API di gestione serve HTTP non cifrato sulla porta 30080 con autenticazione disabilitata di default, e attualmente non esiste alcun percorso documentato di aggiornamento né procedura di backup per il piano di gestione stesso 1. Entrambi i problemi sono coerenti con una versione in anteprima, ma chiunque consideri deployment reali dovrebbe pianificare di risolverli prima di andare oltre i test.
Questa storia segnala uno sviluppo a scopo puramente informativo. Non costituisce consiglio né incoraggiamento a implementare alcuna infrastruttura specifica.
Come valutare la qualità
Non vengono pubblicati benchmark di throughput o tempi di provisioning; la fonte indica che il segnale di qualità è la certificazione, non la velocità 1. NVKE è testato per conformità su Kubernetes 1.36 nell'ambito dei programmi Certified Kubernetes AI Platform e Certified Kubernetes Installer . Per confronto, Gardener (SAP) si definisce pronto per la produzione e certifica fino a v1.35, mentre NVKE stesso è classificato come anteprima e non raccomandato per carichi di lavoro di produzione poiché la sua API predefinita gira in chiaro HTTP sulla porta 30080 con autenticazione disattivata e mancano procedure di aggiornamento o backup .
I fatti principali
- Due strumenti gratuiti NVIDIA offrono agli operatori un piano di gestione e una pipeline di costruzione già pronti per cluster Kubernetes con GPU
- Testato per conformità contro Kubernetes 1.36 con badge di certificazione CNCF ottenuti
- Versione in anteprima: autenticazione disattivata di default sulla porta 30080 e ancora inesistente un percorso di aggiornamento per la produzione
- La valutazione locale richiede 6 CPU, 12 GB RAM, 100 GB di disco senza GPU necessaria
Fonti
Se questa notizia riguarda te o la tua azienda, o usa qualcosa che ti appartiene, chiedi una correzione o la rimozione. Come funzionano le richieste
Continua a leggere
 App e prodottiDyania's Synapsis AI reads 16 years of patient charts on hospital servers at Cleveland ClinicHerald of AI
Dyania's Synapsis AI reads 16 years of patient charts on hospital servers at Cleveland Clinic
Uno strumento di AI in grado di cercare tra gli anni di appunti manoscritti dei medici negli archivi ospedalieri — sono i medici a decidere tutto.
 App e prodottiNVIDIA apre il codice sorgente di Run:ai per la gestione delle GPU di KubernetesHerald of AI
NVIDIA apre il codice sorgente di Run:ai per la gestione delle GPU di Kubernetes
La mossa offre agli sviluppatori l'accesso gratuito a strumenti di orchestrazione GPU di livello enterprise progettati per carichi di lavoro AI.
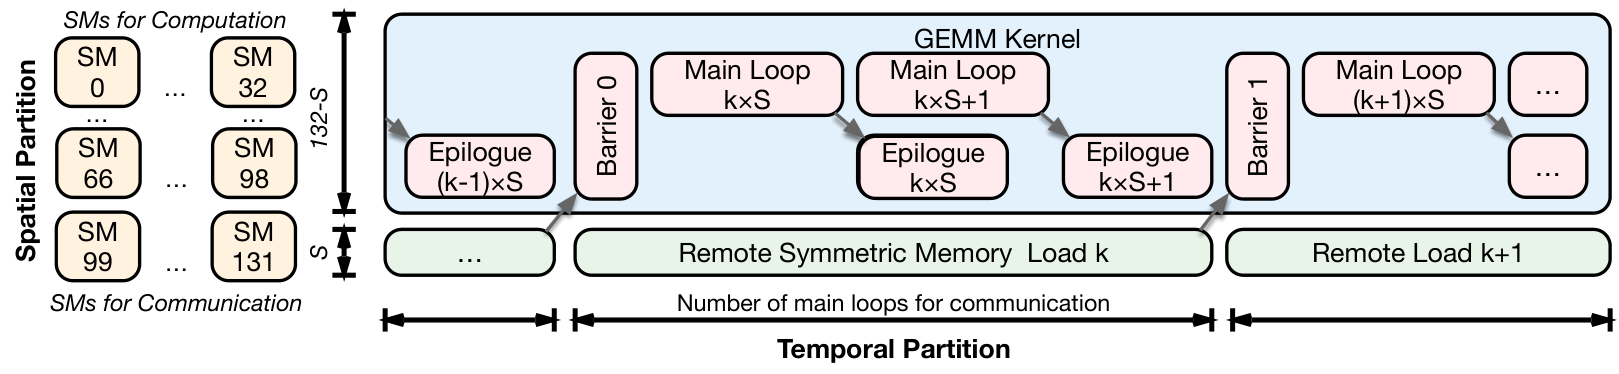 App e prodottiCome Meta ha costruito TLX per aiutare i normali ingegneri a spremere più prestazioni dall'hardware per l'AIHerald of AIFigure: Guan et al., arXiv:2605.10905, CC BY 4.0
Come Meta ha costruito TLX per aiutare i normali ingegneri a spremere più prestazioni dall'hardware per l'AI
Un nuovo strumento permette ai comuni sviluppatori di AI di scrivere codice GPU che raggiunge prestazioni di livello specializzato, alimentando i sistemi alla base di Facebook, Instagram e altri servizi.