Come Meta ha costruito TLX per aiutare i normali ingegneri a spremere più prestazioni dall'hardware per l'AI
Un nuovo strumento permette ai comuni sviluppatori di AI di scrivere codice GPU che raggiunge prestazioni di livello specializzato, alimentando i sistemi alla base di Facebook, Instagram e altri servizi.
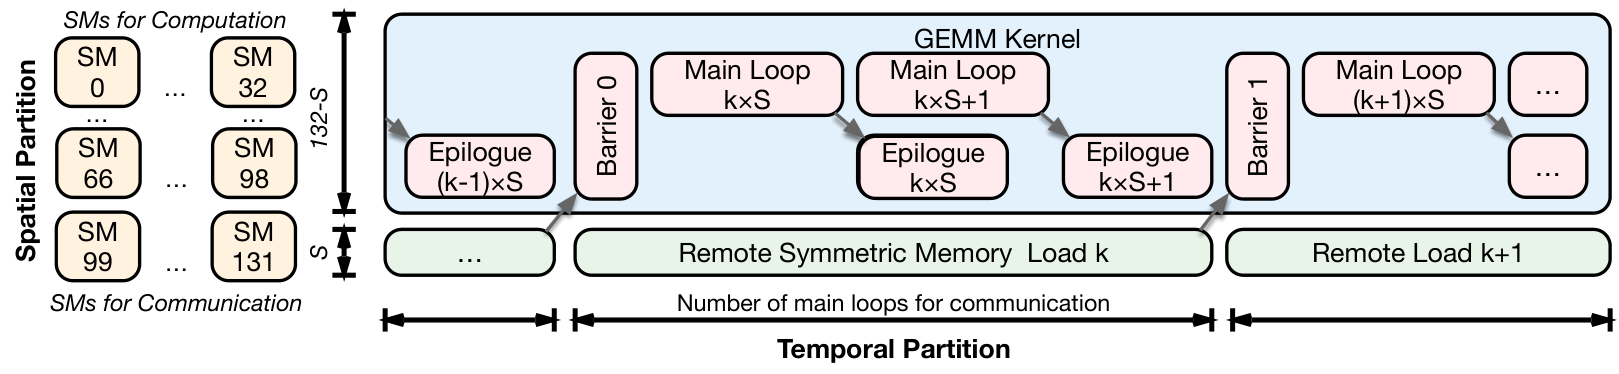
Un'estensione di programmazione che permette agli ingegneri AI comuni di scrivere codice GPU veloce senza bisogno di competenze hardware.
- Individua le parti lente nel codice GPU
- Riscrivi il codice critico usando TLX
- Chiedi ai gruppi di processori di condividere il lavoro
- Ottieni velocità da specialisti in poche ore
Cosa potresti farci
- Un ingegnere ML di Meta potrebbe profilare un carico di lavoro GPU, individuare un collo di bottiglia e riscrivere con TLX il kernel più frequente in Triton per velocizzarlo, completando l'ottimizzazione in ore anziché in giorni 1.
- Un qualsiasi sviluppatore potrebbe scrivere un kernel di attenzione per un modello linguistico di grandi dimensioni e coordinare esplicitamente quali gruppi warp della GPU spostano dati in modo asincrono mentre altri elaborano numeri, ottenendo prestazioni di livello specializzato senza scrivere migliaia di righe di codice a basso livello 1.
- Meta potrebbe distribuire kernel scritti con TLX nelle proprie pipeline di addestramento e inferenza AI in produzione, alimentando i sistemi alla base delle raccomandazioni di News Feed, dei chatbot e del preaddestramento su larga scala di LLM su GPU sia NVIDIA che AMD 1.
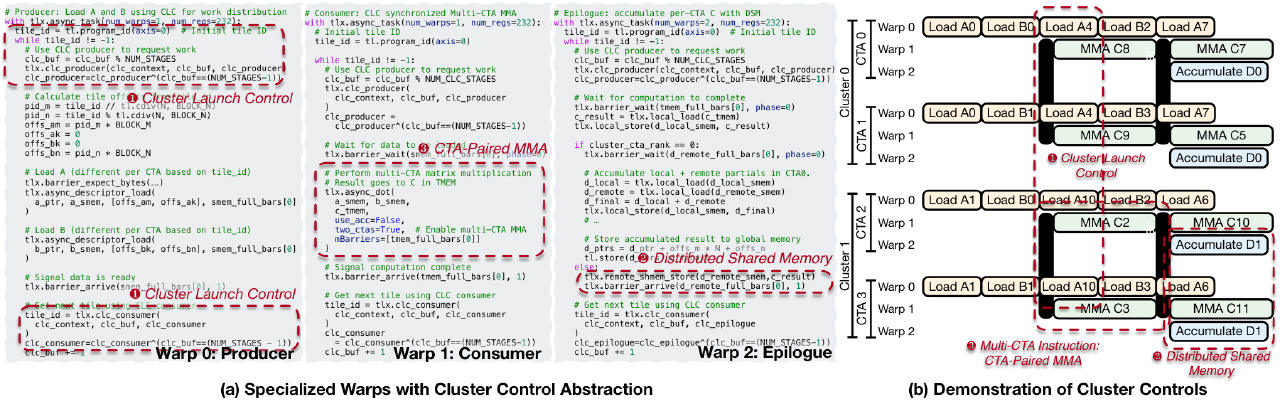
Figura: Guan et al., arXiv:2605.10905, CC BY 4.0
Qual era il problema
Le schede grafiche moderne (GPU) sono diventate incredibilmente complesse. Invece di limitarsi a eseguire operazioni di calcolo semplici più rapidamente, ora includono funzionalità hardware speciali progettate per muovere i dati rapidamente e coordinare le diverse parti del chip che lavorano insieme contemporaneamente. Le architetture Hopper e Blackwell di NVIDIA, ad esempio, hanno introdotto caratteristiche come la specializzazione del warp — dove diversi gruppi di processori gestiscono lavori diversi simultaneamente — e motori dedicati per il trasporto dei dati tra memoria e unità di calcolo.
Il problema è che i linguaggi di programmazione tradizionali per GPU o davano agli sviluppatori troppi dettagli (richiedendo centinaia di righe di codice manuale per coordinare tutte queste nuove funzionalità) o nascondevano tutto dietro ottimizzazioni automatiche che non riuscivano a sfruttare l'hardware più recente. Meta si trovava in uno spazio intermedio: Triton rendeva più produttiva per gli ingegneri la scrittura di codice GPU ottimizzato, ma i chip moderni richiedevano schemi di coordinamento che il compilatore da solo non riusciva a gestire 1.
Specialist CUDA vs. ingegnere ML standard con TLX + Triton
Dati dal documento Meta TLX e adozione riportata, CC BY 4.0
Come TLX colma il vuoto
TLX si colloca tra la semplicità di Triton e il controllo dettagliato necessario per le GPU moderne. Invece di costringere gli ingegneri a scrivere migliaia di righe di codice a basso livello o aspettare che gli autori dei compilatori tengano il passo con ogni nuova generazione hardware, TLX aggiunge modi espliciti ma gestibili per descrivere come i diversi gruppi di processori GPU dovrebbero cooperare 2.
In pratica, questo significa che un ingegnere può scrivere una routine GPU per i calcoli di attenzione — l'operazione fondamentale alla base dei modelli linguistici di grandi dimensioni — e indicare precisamente alla GPU quali parti devono spostare dati in modo asincrono mentre altre elaborano numeri. Il risultato sono kernel che eguagliano ciò che i team specializzati impiegavano settimane a costruire, ma che un normale ingegnere ML può produrre in ore 1.
Perché Meta ha deciso di pubblicarlo
Da Meta, il passaggio a Triton è stato drastico. Nel corso di dieci mesi, il numero di kernel GPU scritti in Triton è cresciuto di circa 3,8 volte, rispetto a una crescita di circa 2,0 volte per il linguaggio CUDA più vecchio. L'ottimizzazione dei kernel — un tempo compito di un piccolo gruppo di specialisti hardware — è diventata parte del bagaglio normale per qualsiasi ingegnere ML dell'azienda 1.
TLX alimenta carichi di lavoro di addestramento e inferenza AI in produzione su tutta Meta, inclusi sistemi di raccomandazione e preaddestramento su larga scala di modelli linguistici. Funziona su GPU sia NVIDIA che AMD. Il codice è stato reso open source, consentendo ad altre aziende e ricercatori di utilizzarlo e migliorarlo 12.
L'idea sottostante è semplice: se ogni nuova generazione di chip introduce nuovi modi per organizzare il lavoro, allora dare ai programmatori mezzi chiari e coerenti per descrivere tale organizzazione — senza sommergerli nei dettagli specifici dell'hardware — permette loro di tenere il passo con l'hardware 2.
Come si comporta in pratica
2. Secondo Meta, i kernel scritti con TLX raggiungono prestazioni equivalenti alle implementazioni più avanzate, ma richiedono solo una piccola quantità di lavoro di sviluppo 1.
I fatti principali
- TLX è un'estensione del compilatore Triton di Meta che aggiunge un controllo esplicito a livello di warp e cluster delle GPU
- L'utilizzo dei kernel Triton da parte di Meta è cresciuto di 3,8 volte, contro il fattore 2,0 del CUDA, nell'arco di dieci mesi
- TLX supporta GPU NVIDIA e AMD e alimenta i carichi di lavoro di addestramento e inferenza in produzione presso Meta
- L'approccio consente ai normali ingegneri ML di scrivere kernel GPU di livello specializzato in ore invece che in giorni
- Il codice TLX è stato pubblicato su GitHub nella cartella facebookexperimental/triton
Fonti
Se questa notizia riguarda te o la tua azienda, o usa qualcosa che ti appartiene, chiedi una correzione o la rimozione. Come funzionano le richieste
Continua a leggere
 App e prodottiDyania's Synapsis AI reads 16 years of patient charts on hospital servers at Cleveland ClinicHerald of AI
Dyania's Synapsis AI reads 16 years of patient charts on hospital servers at Cleveland Clinic
Uno strumento di AI in grado di cercare tra gli anni di appunti manoscritti dei medici negli archivi ospedalieri — sono i medici a decidere tutto.
 App e prodottiNVIDIA apre due strumenti gratuiti per eseguire cloud computing basato su GPU dedicato all'AIHerald of AI
NVIDIA apre due strumenti gratuiti per eseguire cloud computing basato su GPU dedicato all'AI
NVIDIA ha reso gratuito il suo software di gestione dei cluster, così le aziende possono permettere ai clienti di noleggiare computer pronti per l'AI sulle proprie schede grafiche.
 App e prodottiMeta porta su Mac con Apple Silicon l'emulatore Cuttlefish di AndroidHerald of AIMallikarjunasj, CC BY-SA 4.0, via Wikimedia Commons
Meta porta su Mac con Apple Silicon l'emulatore Cuttlefish di Android
Significa che il software Android può ora essere testato su telefoni virtuali dall'aspetto reale, che girano direttamente sui computer Apple.