JetBrains libera Mellum2.1, un modelo de programación rápido y de código abierto
Un modelo de 12 mil millones de parámetros que se entrena con entornos de software reales ya puede ejecutarse en tu propio hardware.
JetBrains ha lanzado Mellum2.1, un modelo de código abierto diseñado específicamente para agentes de codificación y subagentes rápidos que se ejecutan en tu propio hardware 1. El modelo es un modelo de pensamiento de Mixture of Experts de 12 mil millones de parámetros, lo que significa que solo 2,5 mil millones de parámetros están activos en cualquier momento dado . Esto lo hace lo suficientemente pequeño para alojarse de forma privada mientras sigue siendo rápido.
El lanzamiento está disponible bajo la licencia Apache 2.0 en Hugging Face 1. La arquitectura no ha cambiado respecto a Mellum2, que JetBrains publicó como código abierto en junio de 2026, pero la actualización proviene casi en su totalidad del aprendizaje por refuerzo, un método de entrenamiento en el que el modelo mejora al realizar tareas y recibir recompensas 2.
Qué puedes hacer con ello
- Un desarrollador podría ejecutar el modelo localmente para tener un agente de IA que explore su base de código, edite archivos y verifique sus propios cambios sin enviar datos a la nube 2.
- Un equipo podría implementar Mellum2.1 como un subagente rápido para el enrutamiento, resumen de tareas y llamada de herramientas dentro de sus propios flujos de trabajo de ingeniería de software 3.
- Una empresa podría alojar por su cuenta el modelo cuantizado de 7 GB en hardware GPU de consumo para obtener asistencia de codificación sin pagar tarifas por token de API 1.
Diseñado para agentes que realmente funcionan
Mellum2 era rápido, pero no podía funcionar de manera efectiva dentro de un repositorio de software real 2. Tras un verano de aprendizaje por refuerzo en entornos reales, con millones de ejecuciones en sandboxes a través de miles de entornos, Mellum2.1 ahora puede explorar una base de código, editar archivos y comprobar sus propios cambios .
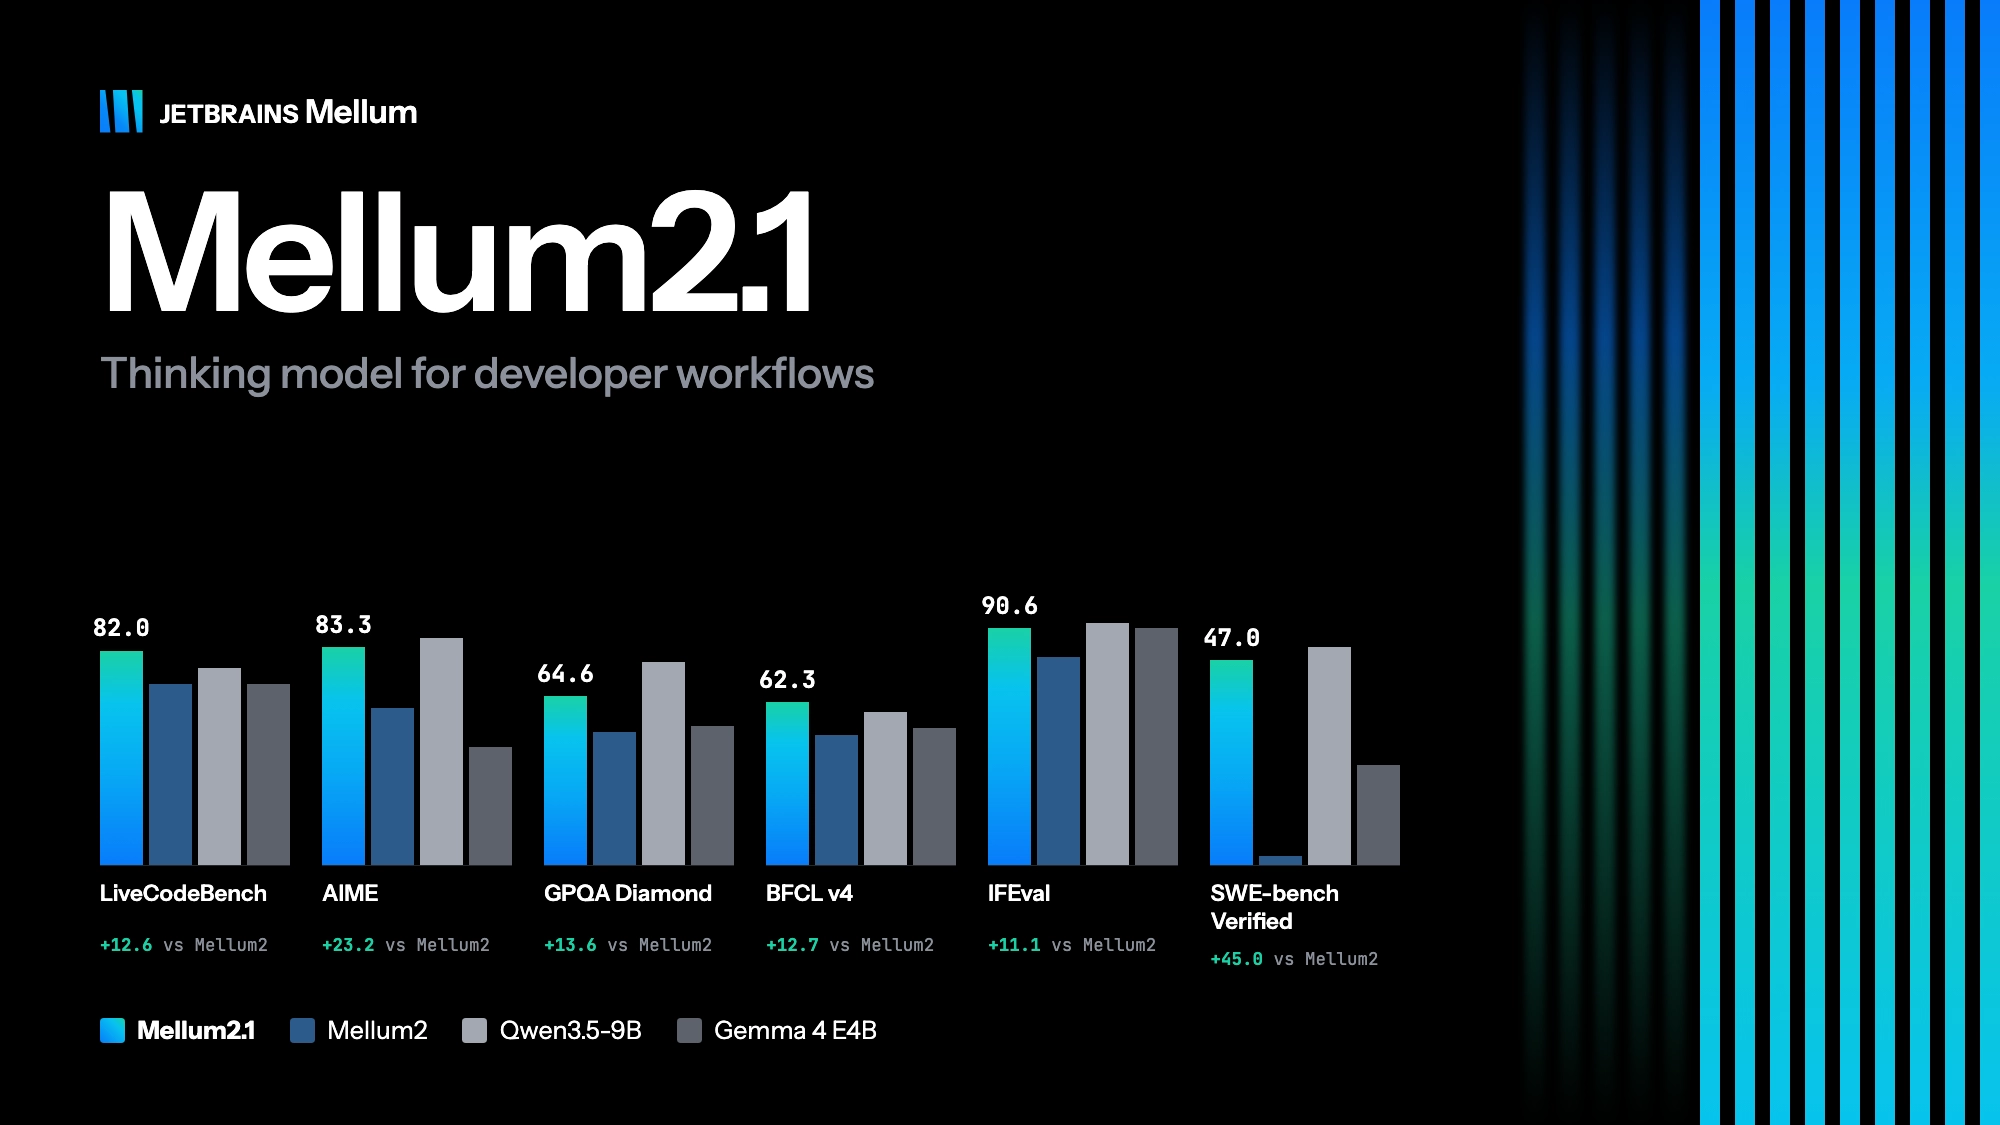
Las mayores mejoras están en tareas de codificación agéntica. En SWE-bench Verified, la puntuación saltó de 2,0 con Mellum2 a 47,0 con Mellum2.1 1. En SWE-bench Pro, pasó de 0,0 a 28,0 . Estas pruebas evalúan qué tan bien puede un modelo corregir errores reales en proyectos de código abierto reales.
JetBrains añadió tareas de aprendizaje por refuerzo en matemáticas, programación competitiva, ciencia, uso de herramientas e ingeniería de software 2. La compañía filtró conjuntos de datos abiertos para eliminar pruebas rotas, respuestas no verificables y tareas demasiado fáciles o imposibles para el modelo .
Velocidad y rendimiento
Mellum2.1 lidera su grupo en varias pruebas de codificación 1. Obtuvo 82,0 en LiveCodeBench v6, en comparación con 75,4 de Qwen3.5-9B y 69,4 de Gemma 4 E4B . También obtuvo la puntuación más alta en HumanEval+ con 91,5 y en BFCL v4 con 62,3 .
Qwen3.5-9B sigue superando a Mellum2.1 en SWE-bench Pro con 38,0 frente a 28,0, así como en tareas muy dependientes de conocimientos como GPQA Diamond 1. Las cifras son autodeclaradas por JetBrains y se midieron utilizando el mismo sistema de evaluación para todos los modelos .
En velocidad, el post-entrenamiento no cambió la arquitectura, por lo que Mellum2.1 es tan rápido como su predecesor 2. JetBrains informa que sirve casi el doble de tokens que Qwen3.5-9B en una sola GPU NVIDIA H200 bajo carga pesada 1. Para solicitudes individuales, la predicción multitoken lo hace aproximadamente 1,6 veces más rápido .
Ejecutarlo por su cuenta
El modelo completo se puede servir en vLLM, y las compilaciones GGUF están disponibles para uso local a través de llama.cpp, Ollama y LM Studio 1. La versión cuantizada más pequeña comienza en 7,0 GB, lo que la hace práctica para ejecutarse en hardware de consumo .
JetBrains recomienda una temperatura de 0,6 y una longitud de contexto de 131.072 tokens 1. El modelo se entrega con pesos bfloat16 y admite llamada de herramientas para agentes que necesitan interactuar con sistemas externos .
Qué tan bueno es
En las pruebas de codificación agéntica, Mellum2.1 obtuvo 47,0 en SWE-bench Verified y 28,0 en SWE-bench Pro, ambos saltos masivos desde 2,0 y 0,0 de Mellum2 respectivamente 1. Frente a rivales de tamaño similar, lidera en LiveCodeBench v6 con 82,0 frente a 75,4 de Qwen3.5-9B y 69,4 de Gemma 4 E4B, según JetBrains . Qwen3.5-9B aún lo supera en SWE-bench Pro con 38,0, lo que muestra que la brecha en corrección de errores reales más difíciles persiste . Todas las cifras son autodeclaradas por JetBrains utilizando su propio sistema de evaluación .
Los datos clave
- Mellum2.1 es un modelo de Mixture of Experts de 12B con 2,5B de parámetros activos
- La puntuación en SWE-bench Verified saltó de 2,0 a 47,0 después del aprendizaje por refuerzo
- Lanzado bajo licencia Apache 2.0 en Hugging Face
- Se ejecuta localmente desde 7,0 GB con cuantización GGUF
Fuentes
- JetBrains Releases Mellum2.1: A 12B MoE Open Model for Coding Agents — marktechpost.com
- Mellum2.1 Gets to Work: A Fast Open Model for Coding Agents
- Introducing Mellum2: A 12B Mixture-of-Experts Model by JetBrains
- Mellum2: JetBrains 12B MoE Code Model Guide - codersera.com — codersera.com
- Mellum2 Goes Open Source: A Fast Model for AI Workflows
Sigue leyendo
 Cómo funcionaMistral AI presenta Mistral Large 4, un modelo multimodal de 1,05 billones de parámetrosHerald of AICómo funciona
Mistral AI presenta Mistral Large 4, un modelo multimodal de 1,05 billones de parámetros
El nuevo modelo insignia de Mistral AI, apodado «Le Chonk», combina una escala masiva con una ventana de contexto de 1 millón de tokens y un sólido rendimiento en ciberseguridad.
 Cómo funcionaCoreWeave se volca al Kubernetes de código abierto mientras los lanzamientos de modelos de IA se vuelven más complicadosHerald of AI
 Cómo funcionaNexus-CLI te permite usar DeepSeek V3 y R1 gratis a través de un proxy localHerald of AI
 Nuevos modelosNVIDIA lanza el modelo super VL de 120B Nemotron 3.5 abiertoHerald of AI