Cómo el RRSI de Google permite que los agentes de IA se mejoren a sí mismos sin salirse de control
Una nueva guía de Google Research muestra cómo los agentes de auto-mejora pueden reescribir su propio código usando bucles de retroalimentación regularizados.
Qué es el RRSI
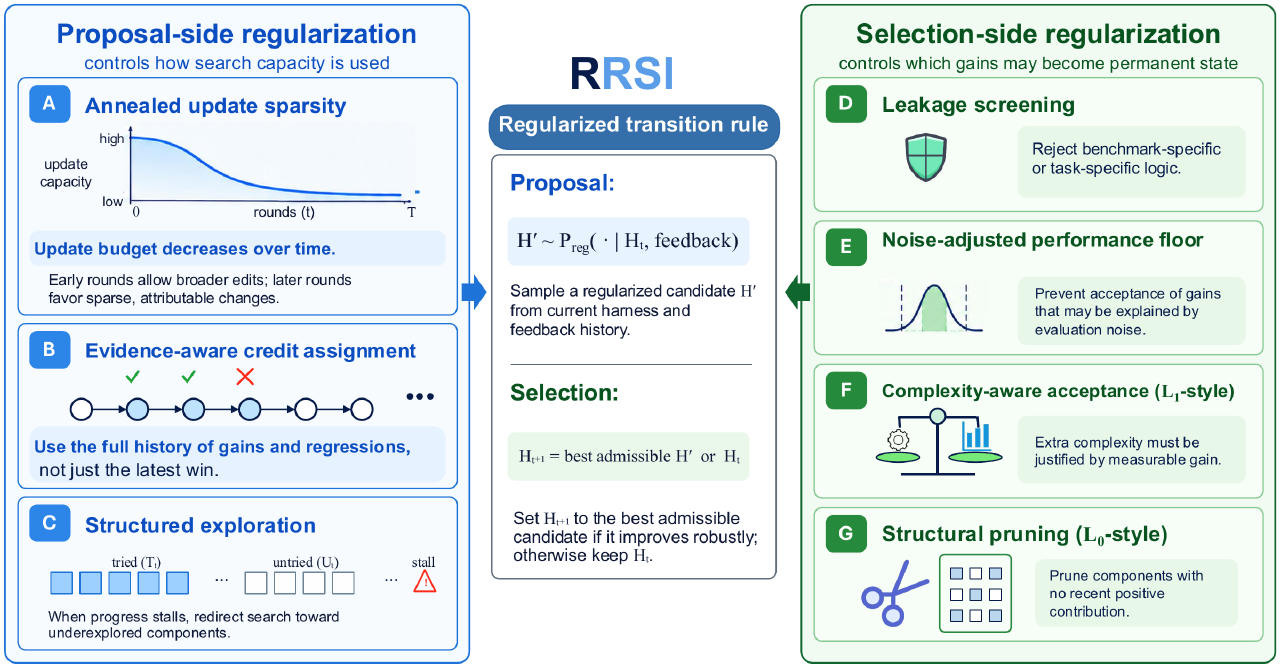
Google Research ha publicado una guía y código para un método llamado Mejora Recursiva Regularizada de Auto-Perfeccionamiento, o RRSI. Enseña a los agentes de IA a reescribir partes de su propio sistema —sus prompts, herramientas, memoria y flujo de control— manteniendo el modelo de lenguaje subyacente congelado. El objetivo es permitir que los agentes evolucionen sin sobreajustarse a las tareas específicas en las que se están entrenando.
El ciclo de auto-mejora
En la configuración completa de RRSI, un borrador de cada edición propuesta se crea llamando a Claude en Vertex AI, y la calidad de cada edición se puntúa dentro de contenedores Docker ejecutando tareas de benchmark 1. Sin embargo, la parte que realmente decide qué ediciones sobreviven es puro Python, sin llamadas a API necesarias.
El sistema funciona por rondas. Cada ronda propone varias ediciones candidatas, las puntúa en benchmarks reales de tareas y luego aplica un conjunto de reglas para elegir las mejores. Estas reglas son el núcleo de la contribución del RRSI: mantienen la mejora estable sin permitir que el agente derive hacia comportamientos sobreajustados o inestables.
Cómo el RRSI se mantiene estable
Varios mecanismos trabajan juntos para prevenir el caos:
- Banda de ruido: Antes de comparar puntajes, el sistema añade ruido aleatorio calibrado para que pequeñas diferencias no causen cambios bruscos en las decisiones 1.
- Regla de costo: Cada edición tiene un costo medido en tokens. Las ediciones más baratas se prefieren cuando las ganancias de rendimiento son similares.
- Presupuesto de edición anneal: Al inicio del entrenamiento el agente puede hacer muchas ediciones; más adelante recibe menos, para que deje de ajustar una vez que encuentra una buena configuración.
- Detector de filtraciones: Un módulo crítico verifica si una edición propuesta podría exponer accidentalmente las respuestas de prueba al agente, bloqueando cualquier cambio sospechoso antes de que se aplique.
- Seguimiento del historial: RRSI registra cada edición, detecta cuándo el progreso se estanca y puede impulsar la exploración si el agente se atasca 1.
- Verificación de novedad: El sistema mide si una nueva edición es estructuralmente diferente de las anteriores, premiando la variación genuina.
Por qué esto importa
La mayor parte de la investigación en IA de auto-mejora se enfoca en cambiar el modelo mismo, ya sea realimentándolo o ajustándolo. RRSI toma un camino diferente: el modelo permanece congelado y el agente mejora su "harness" circundante. Esto significa iteración más rápida, menor costo y una forma más segura de estudiar la modificación autónoma sin riesgo de degradación del modelo.
El ciclo completo de RRSI requiere Claude y benchmarks en Docker, pero cualquiera puede ejecutar la lógica de decisión localmente para entender cómo el algoritmo selecciona qué ediciones mantener 1.
Correcciones y actualizaciones
- Corrected on 21 October 2026. An earlier version claimed the research team included members from UNC-Chapel Hill, Stanford University, and Washington University in St. Louis; the sources do not mention any such university affiliations.
Los datos clave
- RRSI keeps the base language model frozen and evolves only the agent's surrounding harness.
- Proposed edits are drafted with Claude on Vertex AI and scored in Docker benchmarks.
- The core edit-selection logic runs in plain Python without API keys or GPUs.
- A leakage screen blocks edits that might accidentally reveal test answers.
- An annealed budget lets the agent make many edits early and fewer later.
Fuentes
- Google Research RRSI Guide: Mastering Self-Improving AI Agents — marktechpost.com
- GitHub - google-research/rrsi
- PDF RRSI: Regularized Recursive Self-Improvement of Agent Harnesses — regularized-rsi.com
Noticias relacionadas
 Hecho con IAPor qué la IA temprana fue diseñada para ser aleatoria — y por qué dejamos de gustarlaHerald of AI
Por qué la IA temprana fue diseñada para ser aleatoria — y por qué dejamos de gustarla
Un historiador del MIT demuestra que las 'alucinaciones' de la IA actual se remontan a los años cincuenta, cuando los ingenieros construyeron deliberadamente máquinas capaces de cometer errores creativos.
 Cómo funcionaGoogle abre TorchTPU, un backend nativo de PyTorch para TPUs en la nubeHerald of AIhttps://github.com/soumith, CC BY-SA 4.0, via Wikimedia Commons
Google abre TorchTPU, un backend nativo de PyTorch para TPUs en la nube
Una nueva pila de código abierto permite a los desarrolladores ejecutar modelos de PyTorch directamente en los chips TPU de Google, reemplazando el antiguo sistema PyTorch/XLA.
 Cómo funcionaOmnara ofrece alternativa de código abierto a agentes de IA gestionadosHerald of AI
Omnara ofrece alternativa de código abierto a agentes de IA gestionados
Una nueva plataforma autoalojable permite a los desarrolladores ejecutar agentes de IA en cualquier modelo sin depender de servicios propietarios.
 Cómo funcionaIngenieros luchan con código de IA que ya no pueden comprender totalmenteHerald of AI
Ingenieros luchan con código de IA que ya no pueden comprender totalmente
La sincera publicación de un ingeniero de Meta sobre el envío de sistemas escritos por IA ha desatado un debate más amplio sobre el control del diseño y la profundidad técnica en los equipos de software.