Come il RRSI di Google permette agli agenti AI di migliorare se stessi senza perder di vista
Una nuova guida di Google Research mostra come gli agenti auto-miglioranti possano riscrivere il proprio codice usando cicli di feedback regolarizzati.
Che cos'è il RRSI?
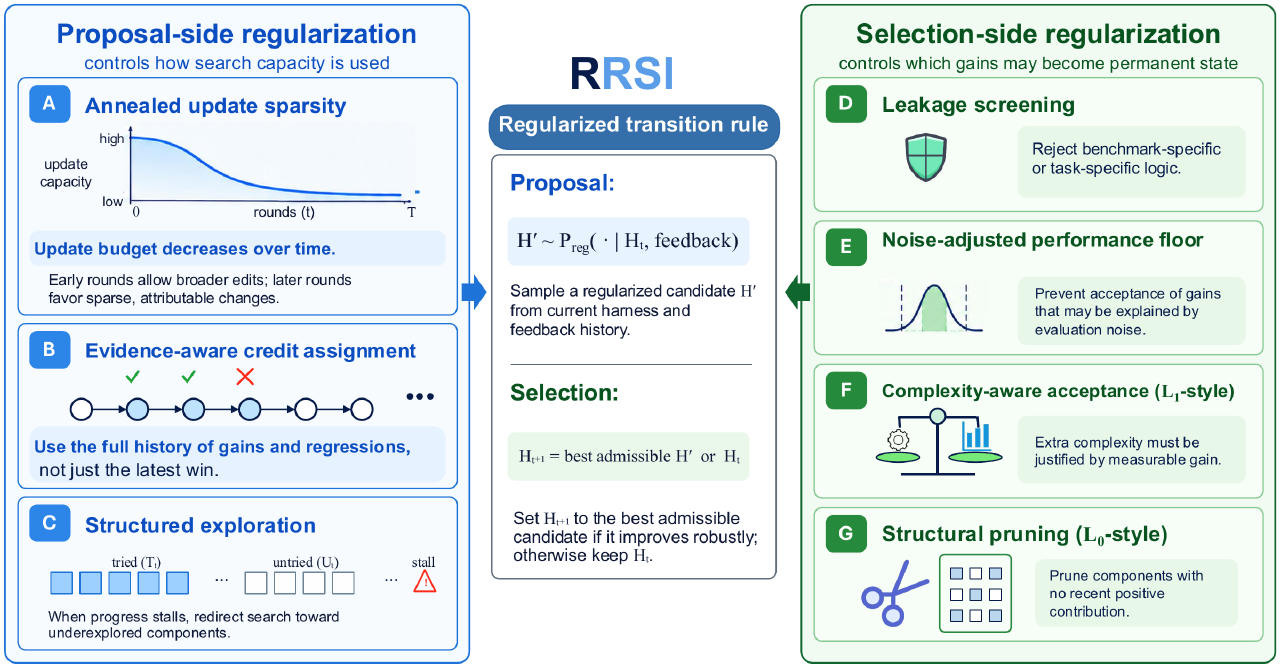
Google Research ha rilasciato una guida e il codice per un metodo chiamato Regularized Recursive Self-Improvement, o RRSI. Insegna agli agenti AI a riscrivere parti del proprio sistema — i prompt, gli strumenti, la memoria e il flusso di controllo — mantenendo congelato il modello linguistico sottostante. L'obiettivo è permettere agli agenti di evolvere senza overfittare sui compiti specifici su cui vengono addestrati.
Il ciclo di auto-miglioramento
Nella configurazione completa RRSI, una bozza di ciascuna modifica proposta viene creata chiamando Claude su Vertex AI, e la qualità di ogni modifica viene valutata all'interno di container Docker che eseguono benchmark 1. Tuttavia, la parte che decide effettivamente quali modifiche sopravvivere è puro Python — senza bisogno di chiamate API.
Il sistema funziona a round. Ogni round propone diverse modifiche candidate, le valuta sui benchmark reali e poi applica un insieme di regole per scegliere le migliori. Queste regole sono il contributo principale del RRSI: mantengono il miglioramento costante senza permettere all'agente di deviare verso comportamenti overfittati o instabili.
Come il RRSI rimane stabile
Diversi meccanismi lavorano insieme per prevenire il caos:
- Noise band: Prima di confrontare i punteggi, il sistema aggiunge rumore casuale calibrato così che piccole differenze non causino oscillazioni selvagge nelle decisioni 1.
- Cost rule: Ogni modifica ha un costo misurato in token. Le modifiche più economiche vengono preferite quando i guadagni di prestazioni sono simili.
- Annealed edit budget: All'inizio dell'addestramento l'agente può fare molte modifiche; più avanti ne fa meno, così smette di rimuginare una volta trovato un buon setup.
- Leakage screen: Un modulo critic verifica se una modifica proposta potrebbe esporre accidentalmente le risposte dei test all'agente, bloccando eventuali cambiamenti sospetti prima che vengano applicati.
- History tracking: Il RRSI registra ogni modifica, rileva quando i progressi stagnano e può aumentare l'esplorazione se l'agente rimane bloccato 1.
- Novelty check: Il sistema misura se una nuova modifica è strutturalmente diversa dalle passate, premiando la variazione genuina.
Perché questo è importante
La maggior parte della ricerca sugli AI auto-miglioranti si concentra sul cambiare il modello stesso — riaddestrandolo o affinandolo. Il RRSI segue un percorso diverso: il modello rimane congelato e l'agente migliora il suo "harness" circostante. Questo significa iterazioni più veloci, costi inferiori e un modo più sicuro per studiare la modifica autonoma senza rischiare il deterioramento del modello.
Il ciclo RRSI completo richiede Claude e benchmark Docker, ma chiunque può eseguire la logica decisionale localmente per capire come l'algoritmo sceglie quali modifiche mantenere 1.
Correzioni e aggiornamenti
- Corrected on 21 October 2026. Una versione precedente affermava che il team di ricerca includeva membri della UNC-Chapel Hill, Stanford University e Washington University in St. Louis; le fonti non menzionano affiliazioni universitarie di sorta.
I fatti principali
- Il RRSI mantiene congelato il modello linguistico di base e fa evolvere solo l'harness circostante dell'agente.
- Le modifiche proposte vengono abbozzate con Claude su Vertex AI e valutate in benchmark Docker.
- La logica centrale di selezione delle modifiche gira in Python semplice senza chiavi API o GPU.
- Uno schermo di fuga blocca le modifiche che potrebbero rivelare accidentalmente le risposte dei test.
- Un budget annealing permette all'agente di fare molte modifiche all'inizio e meno più tardi.
Fonti
- Google Research RRSI Guide: Mastering Self-Improving AI Agents — marktechpost.com
- GitHub - google-research/rrsi
- PDF RRSI: Regularized Recursive Self-Improvement of Agent Harnesses — regularized-rsi.com
Notizie collegate
 Come funzionaAnthropic lancia sandbox-runtime per racchiudere in sicurezza gli agenti AI senza containerHerald of AI
Anthropic lancia sandbox-runtime per racchiudere in sicurezza gli agenti AI senza container
Un nuovo strumento gratuito di Anthropic permette agli sviluppatori di mettere salvagenti intorno a qualsiasi programma AI, bloccando l'accesso non autorizzato ai file e le connessioni a Internet.
 Fatto con l’AIPerché i primi sistemi di intelligenza artificiale erano progettati per essere casuali — e perché non ci hanno più soddisfattoHerald of AI
Perché i primi sistemi di intelligenza artificiale erano progettati per essere casuali — e perché non ci hanno più soddisfatto
Uno storico del MIT dimostra che le "allucinazioni" dell'AI di oggi risalgono agli anni Cinquanta, quando gli ingegneri costruirono deliberatamente macchine capaci di commettere errori creativi.
 Come funzionaGoogle lancia TorchTPU, un backend nativo per PyTorch su TPU nel cloudHerald of AIhttps://github.com/soumith, CC BY-SA 4.0, via Wikimedia Commons
Google lancia TorchTPU, un backend nativo per PyTorch su TPU nel cloud
Un nuovo stack open-source permette agli sviluppatori di far girare modelli PyTorch direttamente sui chip TPU di Google, sostituendo il vecchio sistema PyTorch/XLA.
 Nuovi modelliGemini 4 Argon si cimenta nella programmazione di bot per StarCraftHerald of AI
Gemini 4 Argon si cimenta nella programmazione di bot per StarCraft
Il nuovo modello di Google si piazza al terzo posto in una classifica in cui i sistemi di IA scrivono bot per il classico gioco in tempo reale.