Investigadores entrenan IA para que los modelos lingüísticos grandes puedan reconfigurar con más facilidad sus circuitos visuales
Una nueva técnica de entrenamiento hace mucho más fácil que la IA textual reescriba los circuitos internos de los modelos de detección de imágenes.
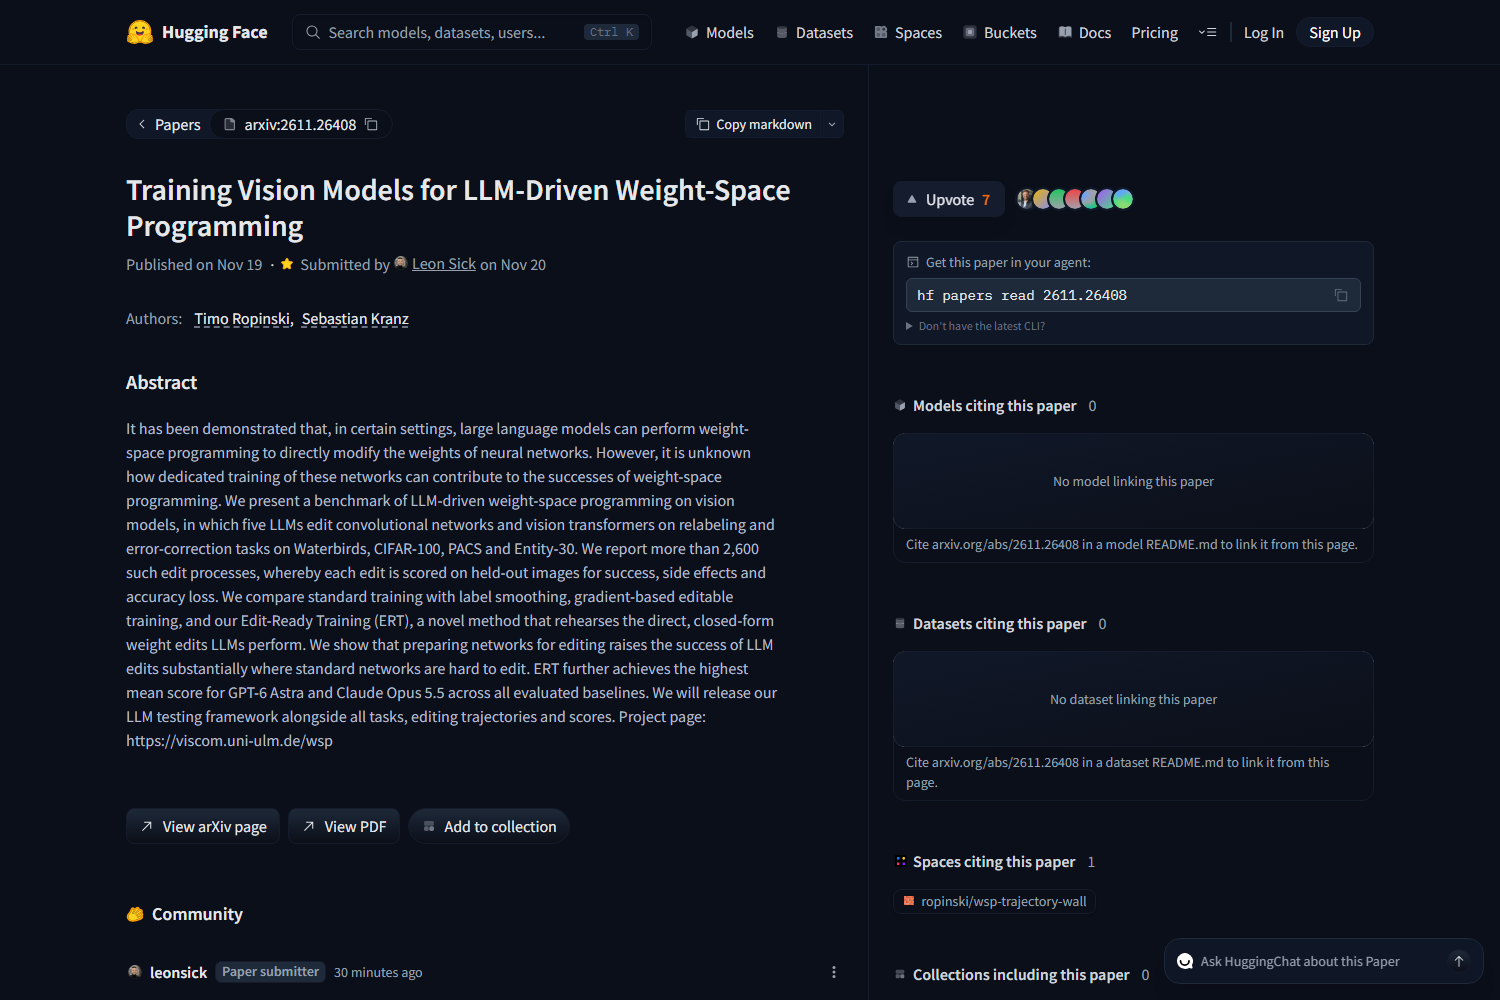
Un método de entrenamiento que prepara a la IA visual para que los modelos de lenguaje grandes puedan editar directamente sus números internos con alta eficacia.
- Preparás la IA visual de antemano usando un entrenamiento especial de edición
- Le pedís a una IA de texto que reescriba los números de los pesos internos del modelo
- El modelo acepta las ediciones y mantiene casi toda su precisión original
Qué se puede hacer con esto
- Los investigadores podrían preparar modelos de IA visual por anticipado para que los modelos lingüísticos grandes puedan reconfigurar con mayor facilidad y éxito sus números internos 1
Reconfigurar desde adentro
Las redes neuronales almacenan lo que han aprendido en millones de números diminutos llamados pesos. Por lo general, esos números solo cambian cuando alguien ejecuta un proceso de entrenamiento lento y exigente computacionalmente sobre conjuntos masivos de datos. Una idea más reciente, conocida a veces como programming en el espacio de pesos, omite ese proceso por completo y permite que un modelo lingüístico grande escriba números nuevos directamente en los pesos 1.
El problema es que la mayoría de las redes entrenadas resisten ser reconfiguradas. Fueron moldeadas por descenso de gradiente, un método estándar de optimización, para asentarse en valles estrechos dentro de su propio "espacio de pesos", un paisaje matemático donde cada combinación posible de números cuenta como un punto 1. Perturbarlas desde afuera suele romper cualquier estructura útil que el entrenamiento ya haya construido.
"Cómo el entrenamiento dedicado de estas redes puede contribuir a los éxitos del programming en el espacio de pesos" era precisamente la pregunta sin respuesta que dejaban demostraciones anteriores, señala el artículo de Timo Ropinski y Sebastian Kranz, publicado en arXiv el 19 de noviembre de 2026 y compartido en Hugging Face al día siguiente 1.
Cómo tres formas de preparar una IA de visión afectan su editabilidad
Basado en benchmark de Timo Ropinski y Sebastian Kranz; ERT superó a ambos métodos base en éxito de edición, daño colateral y retención de precisión.
Más de dos mil ediciones calificadas
Ropinski y Kranz construyeron un conjunto de pruebas alrededor de cinco modelos lingüísticos grandes editando tanto redes convolucionales como vision transformers en cuatro conjuntos de datos de imágenes: Waterbirds, CIFAR-100, PACS y Entity-30 1. Las pruebas abarcaron dos tipos de cambios: la relabelización, que modifica cómo el modelo categoriza ciertas imágenes, y la corrección de errores, que repara fallos conocidos . En total ejecutaron más de 2600 sesiones de edición individuales .
Cada intento fue calificado en tres ejes: si el cambio deseado realmente funcionó, cuánto daño causó en otras partes y cuánto bajó la precisión general 1. Esa tercera medida es importante: una reconfiguración exitosa que convierte un modelo con 90 % de aciertos en algo así como una moneda al aire apenas ha mejorado nada para un usuario real.
Se compararon tres regímenes de entrenamiento 1. El primero fue entrenamiento convencional con suavizado de etiquetas, un truco de regularización que evita que el modelo se vuelva excesivamente seguro al transformar las etiquetas de categoría rígidas en mezclas . El segundo fue un método de entrenamiento editable basado en gradientes previos de trabajos anteriores . El tercero fue un enfoque nuevo que los autores llaman Edit-Ready Training, o ERT, que ensayaba las transformaciones lineales de forma cerrada exactas que los modelos lingüísticos aplican durante la edición —es decir, la red se prepara para ser editable antes de que alguien le pida que lo esté— .
"Preparar redes para la edición eleva sustancialmente el éxito de las ediciones de los LLM donde las redes estándar son difíciles de editar", escribieron los investigadores 1. En todas las pruebas base, ERT produjo la puntuación media más alta cuando se combinó con GPT-6 Astra y Claude Opus 5.5 . El equipo también se comprometió a publicar el marco de pruebas completo, cada trayectoria de edición y todas las puntuaciones junto con los conjuntos de datos, y publicó una página del proyecto en viscom.uni-ulm.de/wsp .
Por qué esta ruta podría importar
Si una técnica como ERT escala, acerca un poco más a la realidad el sueño de la IA autoactualizable en el dispositivo. En lugar de flashear una versión nueva de firmware cada vez que se quiere que un modelo especializado aprenda una nueva distinción, un agente lingüístico de propósito general podría intervenir, ajustar los números correctos y verificar el resultado contra un conjunto reservado de imágenes 1. Por ahora los experimentos están firmemente anclados en benchmarks académicos, y el artículo no afirma que el enfoque funcione para cada arquitectura o para cada tipo de edición. Lo que sí muestra es una ruta concreta: entrenar el circuito para esperar que lo reconfiguren, que otros equipos pueden extender o cuestionar.
Qué tan buena es
Los investigadores probaron más de 2600 sesiones de edición individuales en cuatro conjuntos de datos de imágenes —Waterbirds, CIFAR-100, PACS y Entity-30— usando cinco modelos lingüísticos grandes, entre ellos GPT-6 Astra y Claude Opus 5.5 1. Cada edición fue calificada según si realmente funcionó, cuánto daño colateral causó en otras partes y cuánto bajó la precisión general . Su nuevo método de Edit-Ready Training (ERT) logró tasas de éxito substancialmente más altas, especialmente donde las redes entrenadas de forma convencional son muy difíciles de editar . En todas las bases, ERT obtuvo las mejores puntuaciones tanto para GPT-6 Astra como para Claude Opus 5.5 .
Correcciones y actualizaciones
- Corregido el 20 de noviembre de 2026. Una versión anterior afirmaba que los usuarios comunes y las empresas podían usar la programación en el espacio de pesos impulsada por modelos de lenguaje grandes para editar modelos de visión de forma económica; la fuente solo describe un método de investigación con evaluación comparada para editar redes mediante modificaciones directas de los pesos, sin mención de ahorro de costos ni aplicación comercial.
Los datos clave
- Más de 2.600 ensayos de edición con modelos de lenguaje grande (LLM) en cuatro conjuntos de datos de imágenes
- El Entrenamiento Listo para Editar (ERT) prepara las redes ensayando exactamente las matemáticas que usa el modelo de lenguaje para cambiar los pesos
- Los mejores puntajes provinieron de combinar ERT con GPT-6 Astra y Claude Opus 5.5
- Cinco modelos de lenguaje grandes editaron tanto redes convolucionales como transformadores de visión
Fuentes
Si esta noticia te afecta a ti o a tu empresa, o usa algo que te pertenece, pide una corrección o que se retire. Cómo funcionan las solicitudes
Sigue leyendo
 Nuevos modelosGoogle presenta Gemini 4 Argon con capacidad de salida de 1 millón de tokensHerald of AI
Google presenta Gemini 4 Argon con capacidad de salida de 1 millón de tokens
El nuevo modelo de vanguardia puede generar un millón de tokens de una sola vez, pero se queda atrás de sus rivales en tareas reales de programación.
Simon Willison usó Claude Code para convertir teléfonos y tabletas que ya no se usan en un localizador de un pitido misterioso
Un desarrollador usó Claude Code para convertir dispositivos de repuesto en un localizador de sonido, y encontró un antiguo detector de monóxido de carbono que urgía por tener sus pilas cambiadas.
Un desarrollador usó modelos de Fable AI para crear un juego que se desarrolla solo
Spawn, un mundo de juego multijugador, se codifica y corrige automáticamente con agentes de IA; la empresa gasta millones en tokens de IA cada mes.